AI Gateway와 Model provider는 각각 input·output 토큰을 기록하고, 사용 금액은 토큰 수 × 모델 단가로 계산합니다. 하지만 시간이 지나면, AI gateway와 Model provider의 토큰이 차이가 발생합니다. 그 이유가 무엇인지 이 글에 정리했습니다.
AI Gateway의 핵심 기능: 집계
AI Gateway의 핵심 기능 중 하나는 집계(Aggregation)입니다. AI Gateway는 model을 얼마나 사용했는지 기록해야 하고 기록한 내용을 가지고 사용 금액을 계산해야 합니다.
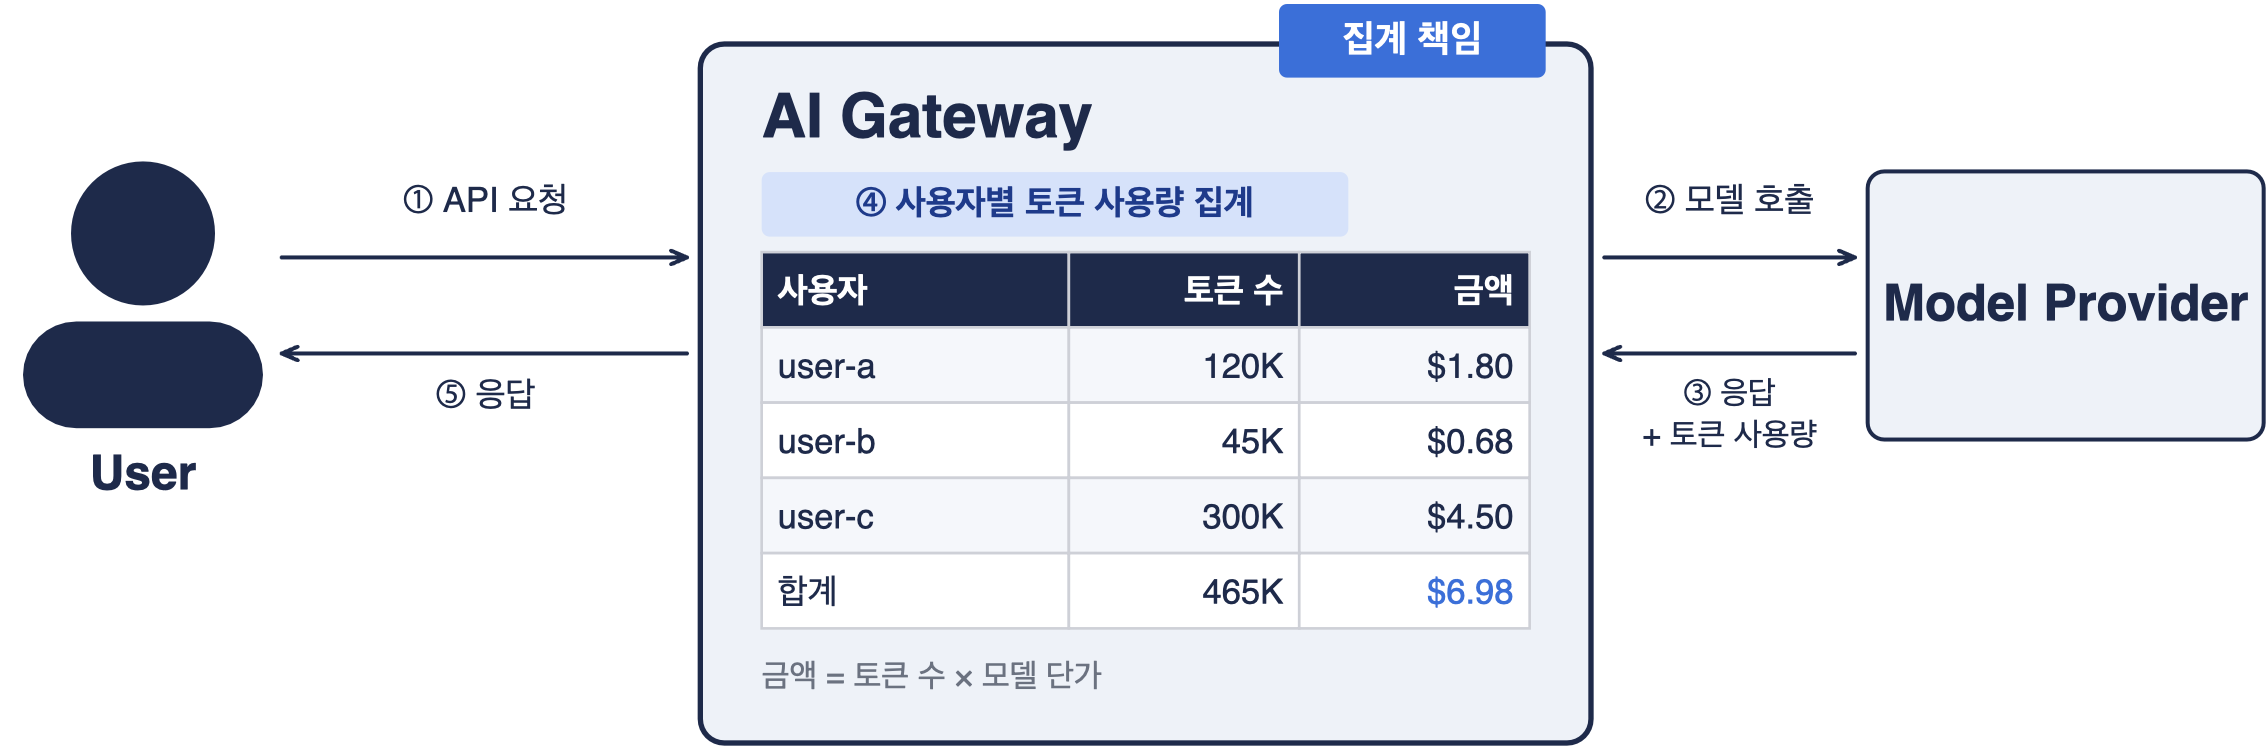
집계 원리
집계 원리는 토큰 수 x 모델 단가입니다. 토큰 수는 input 토큰과 output 토큰이 있습니다. 집계는 AI Gateway와 Model provider 두 곳에서 모두 계산하므로 각각 input 토큰과 output 토큰을 기록합니다. 사용하는 AI Gateway, Model provider 종류에 따라 input 토큰과 output 토큰을 부르는 이름이 다릅니다.
예를 들어 AI Gateway LiteLLM은 token들을 아래처럼 부르고
- input token -> prompt_tokens
- output token -> completion_tokens
Model provider Bedrock은 token들을 아래처럼 부릅니다.
- input token -> InputTokenCount
- output token -> OutputTokenCount
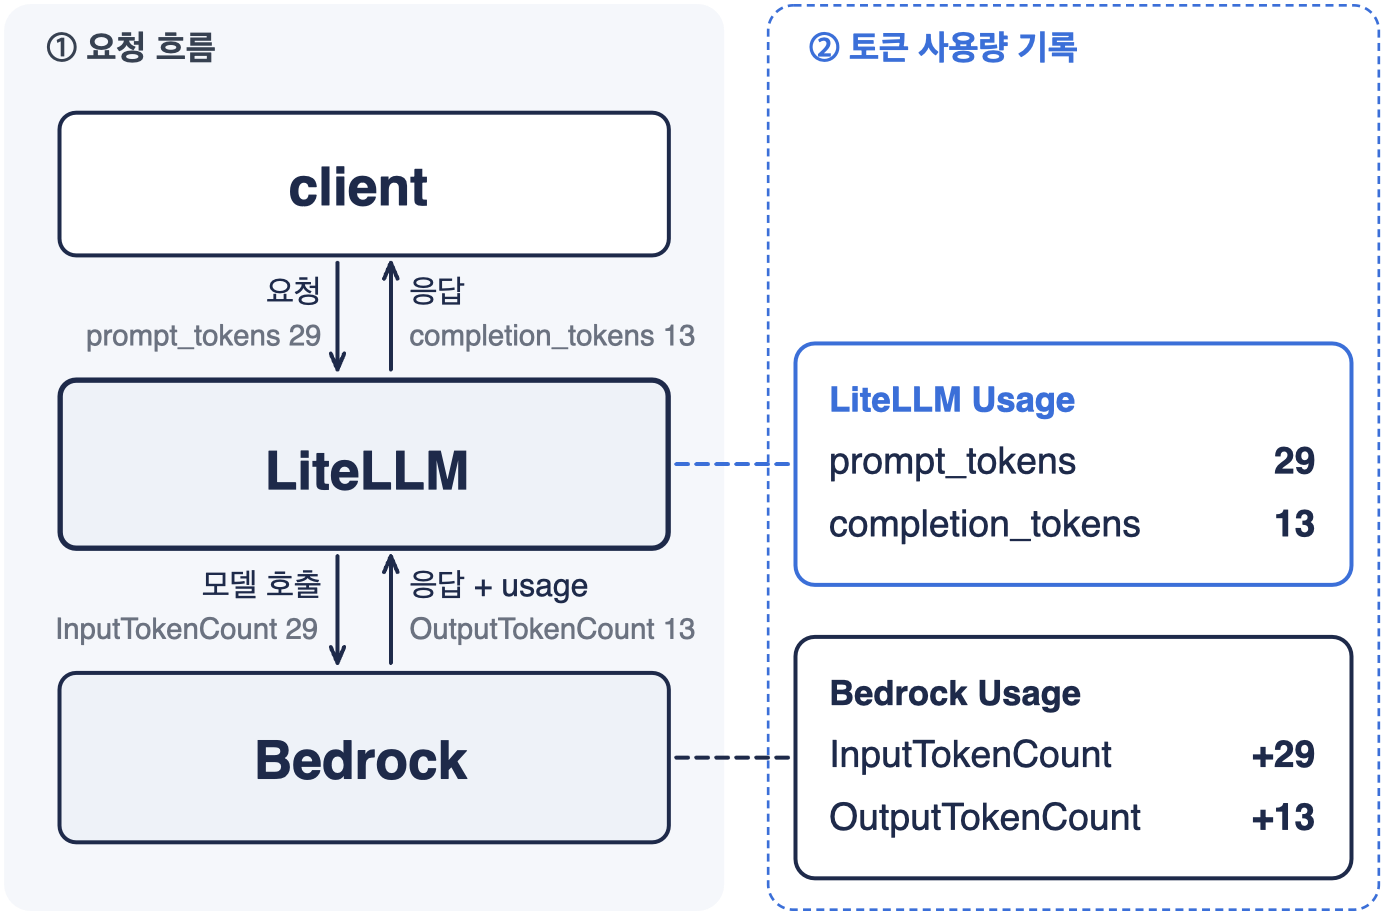
AI Gateway는 토큰을 가지고 비용계산을 하고, 이 계산을 근거로 사용자에게 금액을 청구합니다.
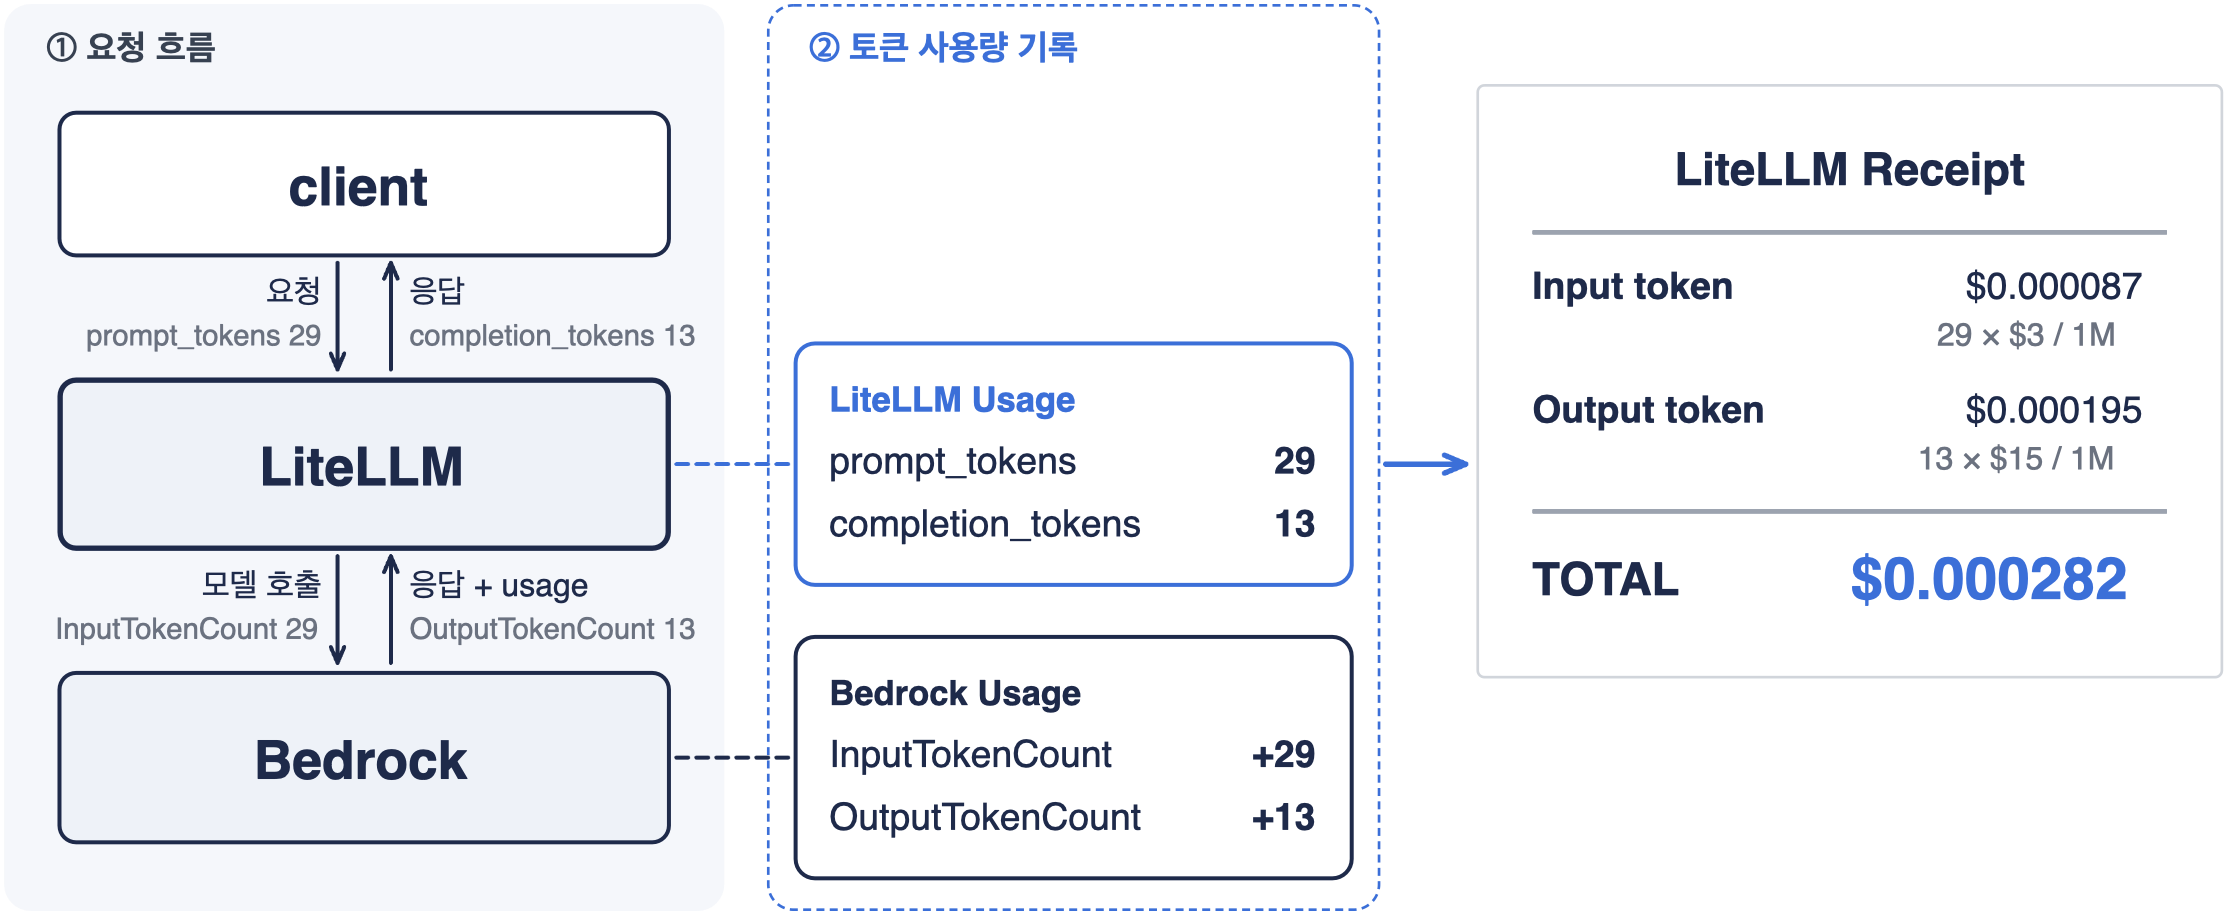
집계 실험A
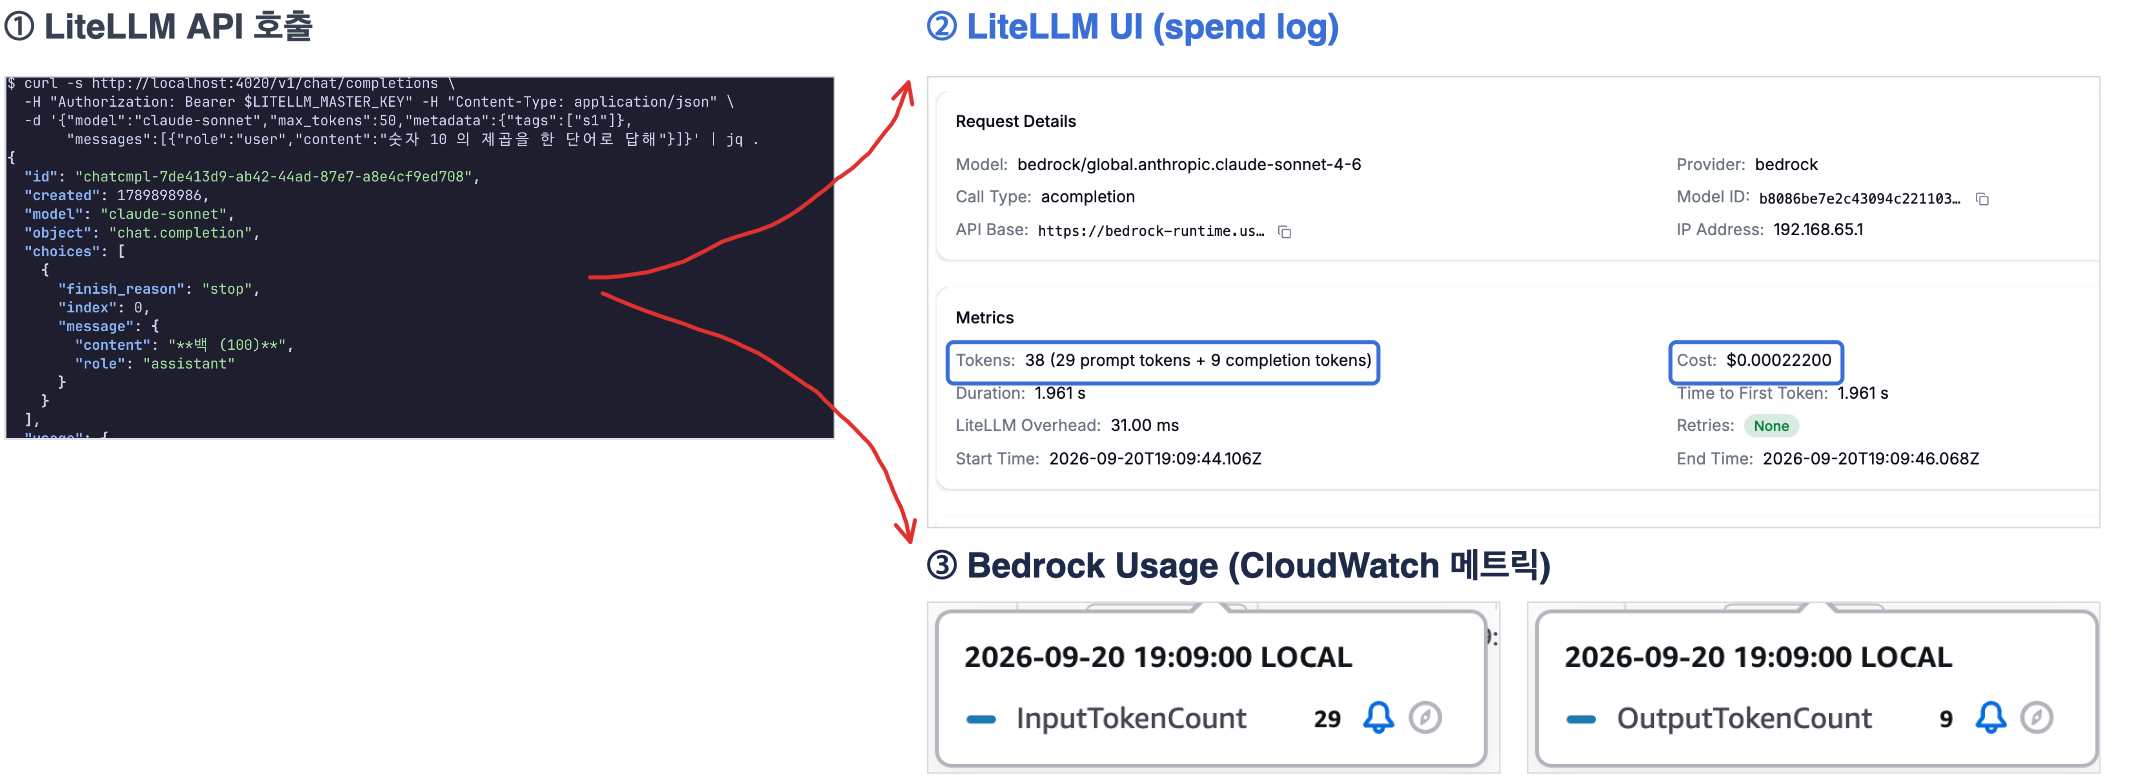
실험 A는 테스트 프롬프트를 실행 후, LiteLLM 토큰과 Bedrock 토큰이 같은지 비교합니다.
테스트 프롬프트는 아래와 같습니다. 단순히 제곱근을 요청하는 겁니다.
LITELLM_MASTER_KEY={placeholder}

curl -s http://localhost:4020/v1/chat/completions \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" -H "Content-Type: application/json" \
  -d '{"model":"claude-sonnet","max_tokens":50,"metadata":{"tags":["s1"]},
       "messages":[{"role":"user","content":"숫자 10 의 제곱을 한 단어로 답해"}]}' | jq .
LiteLLM API 호출 후, LiteLLM과 Bedrock 집계 결과를 보면 input, output 토큰이 동일합니다.
집계의 어려운 점 - 다양한 변수들
집계 실험A처럼 AI Gateway와 Model provider의 집계 결과가 같으면 좋겠지만, 시간이 갈수록 다양한 변수로 인해 집계 결과가 다릅니다. 따라서 AI Gateway를 운영한다면 집계 결과가 왜 다른지 이해하고, 사용자에게 집계에 대한 신뢰를 주기 위해 왜 다른지 설명할 줄 알아야 합니다.
변수A - AI Gateway 캐시
AI Gateway에서 캐시를 사용한다면, AI Gateway input/output 토큰과 Bedrock input/output 토큰의 차이가 생깁니다. AI Gateway가 캐시 기능 때문에 Model provider를 호출하지 않고 AI Gateway 토큰만 쌓이기 때문입니다.
AI Gateway와 Model provider의 캐시 구조는 아래와 같습니다. Model provider는 GPU 연산을 줄여 GPU 활용을 높이기 위해 캐시를 사용합니다. AI Gateway 역시 캐시를 가지고 있고 옵션으로 사용합니다. AI Gateway가 캐시를 쓰는 이유는 Model 호출 수를 줄여 비용을 절약하고 응답 시간을 빠르게 하기 위해서입니다.
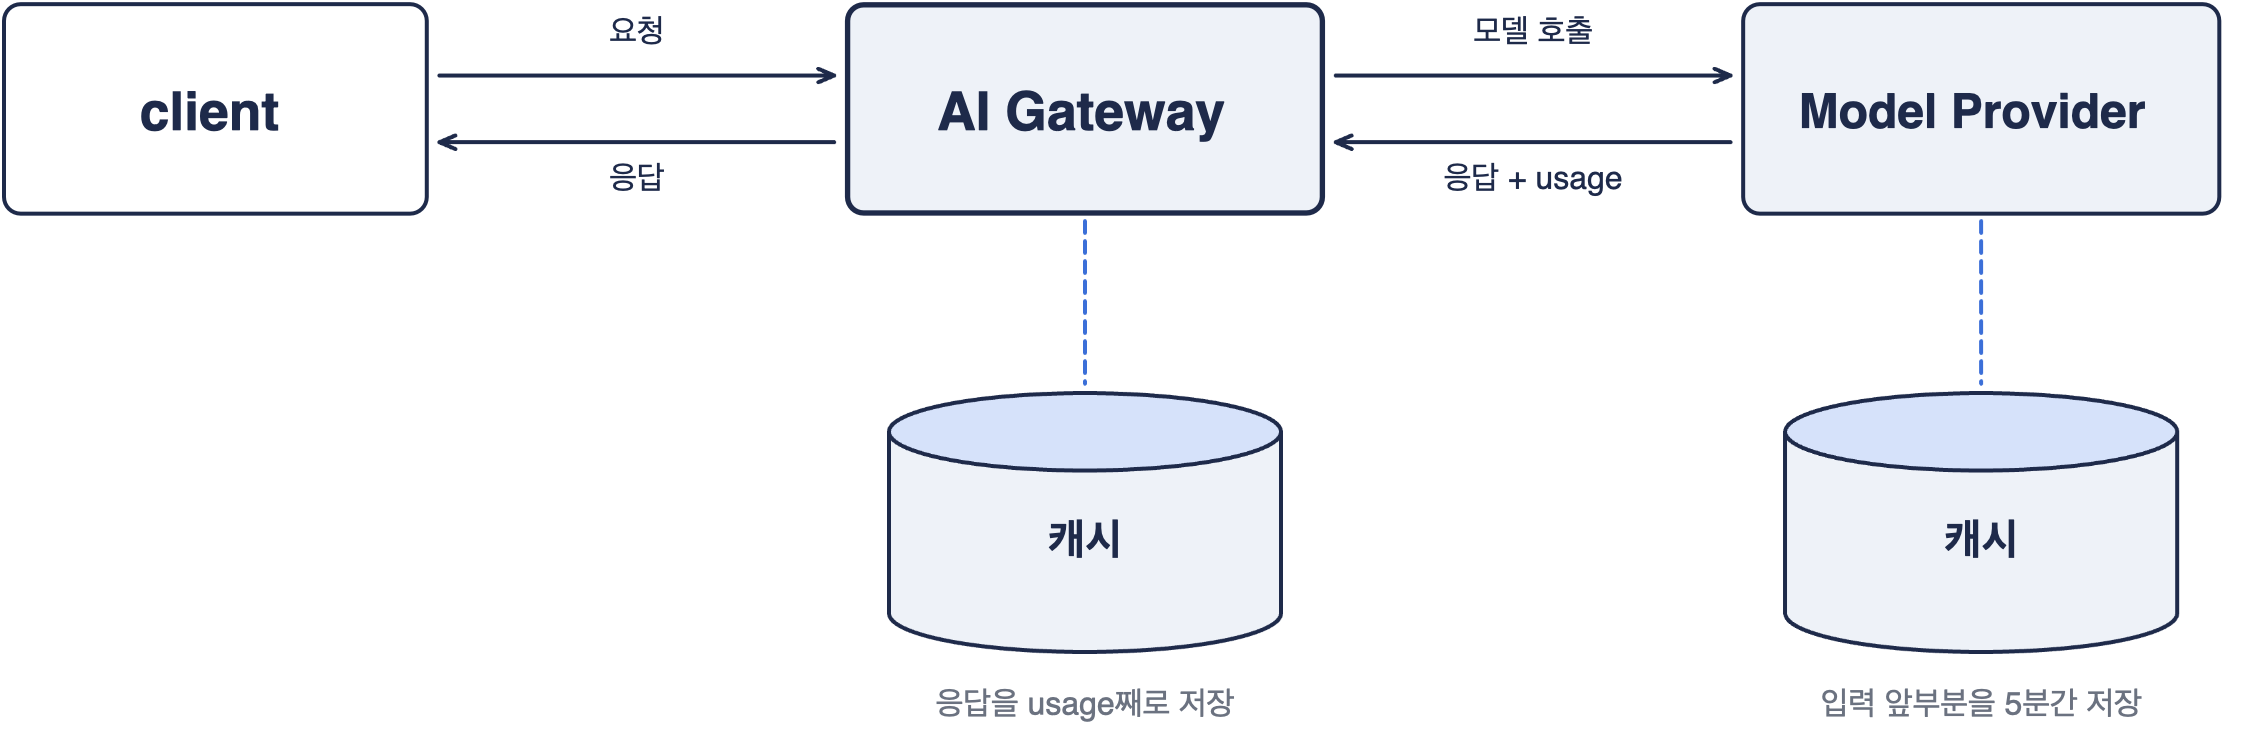
AI Gateway에서는 캐시가 hit되면 Model provider를 호출하지 않기 때문에, AI Gateway의 input과 output 토큰이 Model provider보다 많아집니다.

캐시 실험
집계 실험에서 사용한 프롬프트를 5번 실행하여, LiteLLM과 Bedrock 토큰을 비교합니다.
LITELLM_MASTER_KEY={placeholder}

curl -s http://localhost:4020/v1/chat/completions \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" -H "Content-Type: application/json" \
  -d '{"model":"claude-sonnet","max_tokens":50,"metadata":{"tags":["s1"]},
       "messages":[{"role":"user","content":"숫자 10 의 제곱을 한 단어로 답해"}]}' | jq .
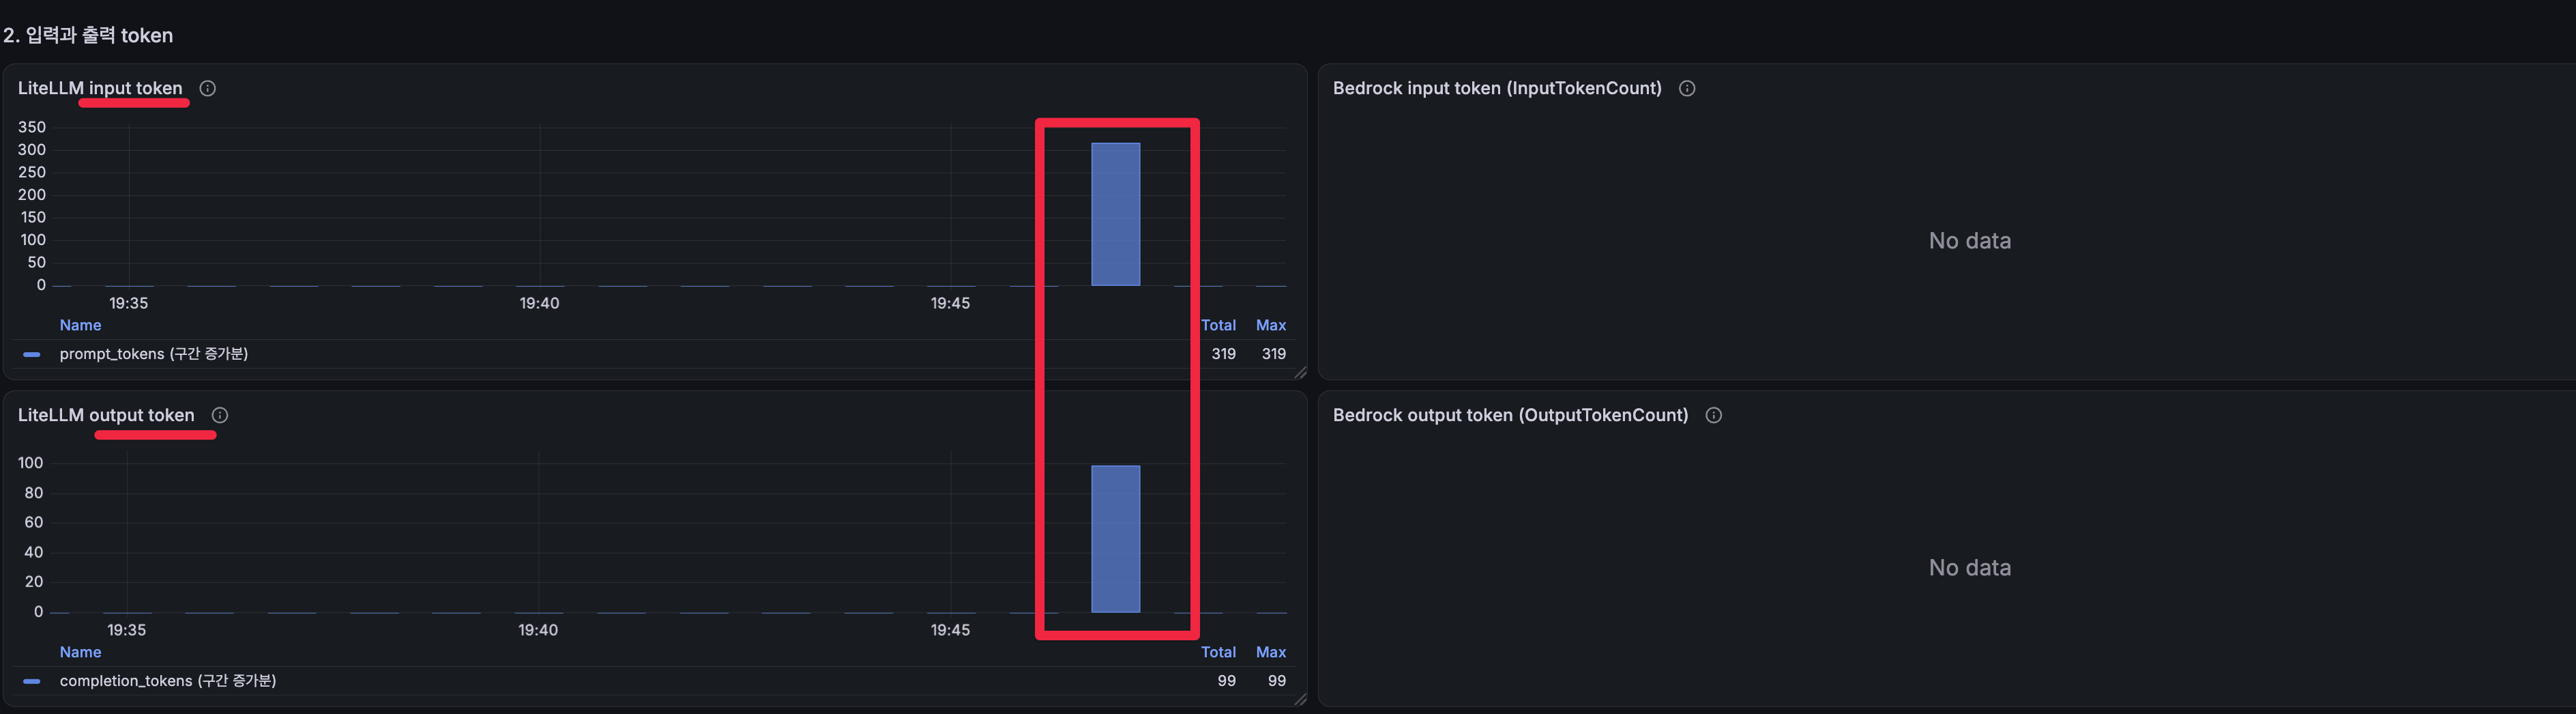
프롬프트를 5번 실행하면, LiteLLM input, output 토큰만 증가했습니다.
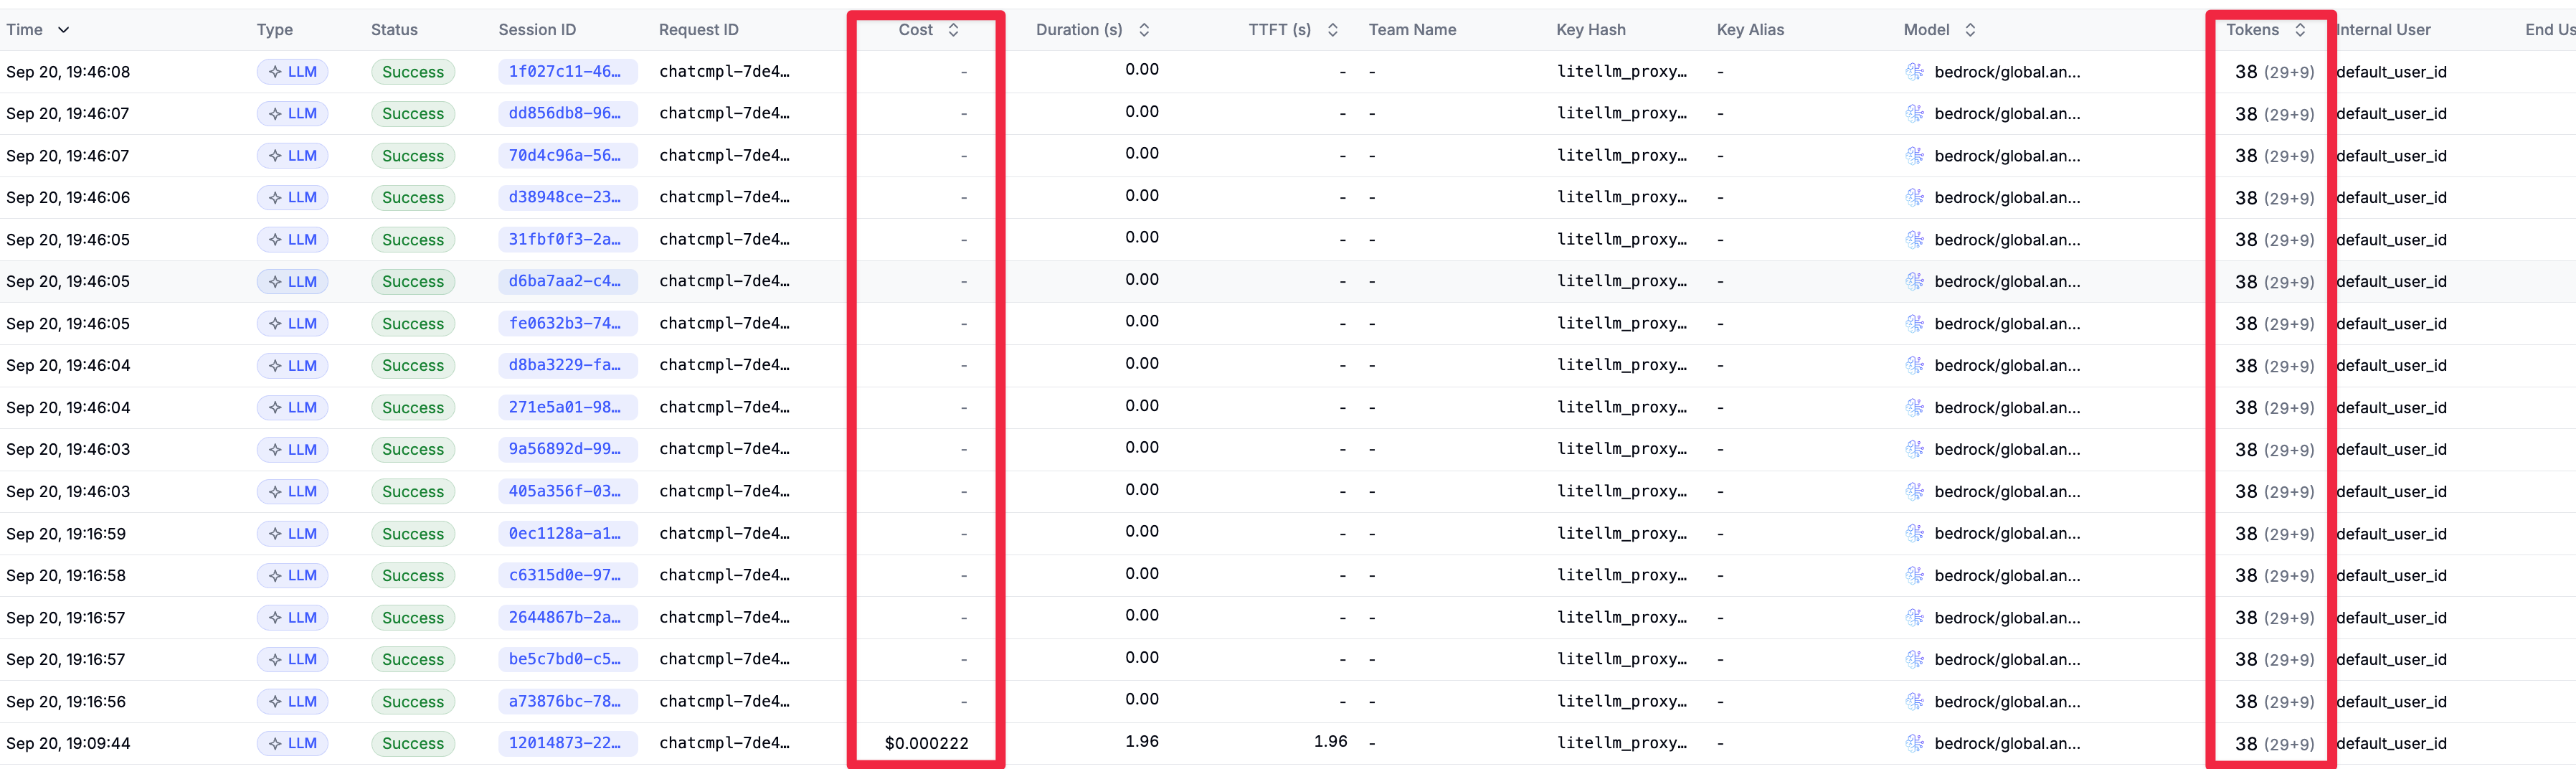
LiteLLM log를 보면 캐시가 안 된 최초 프롬프트만 Cost가 발생하고, 이후 동일한 프롬프트는 Cost가 발생하지 않습니다. 이 Cost는 Model provider 호출 후 LiteLLM이 계산한 금액입니다. 캐시된 요청은 Cost가 발생하지 않지만 input, output 토큰은 계속 발생합니다.
변수B - Model provider 캐시의 비용 집계 방식
Model provider의 캐시 비용 집계 방식에 따라, AI Gateway와 Model provider 토큰이 차이 납니다.
예를 들어 AWS Bedrock은 InputTokenCount에서 캐시 토큰을 제외합니다. 그래서 AI Gateway input 토큰과 차이가 생깁니다.
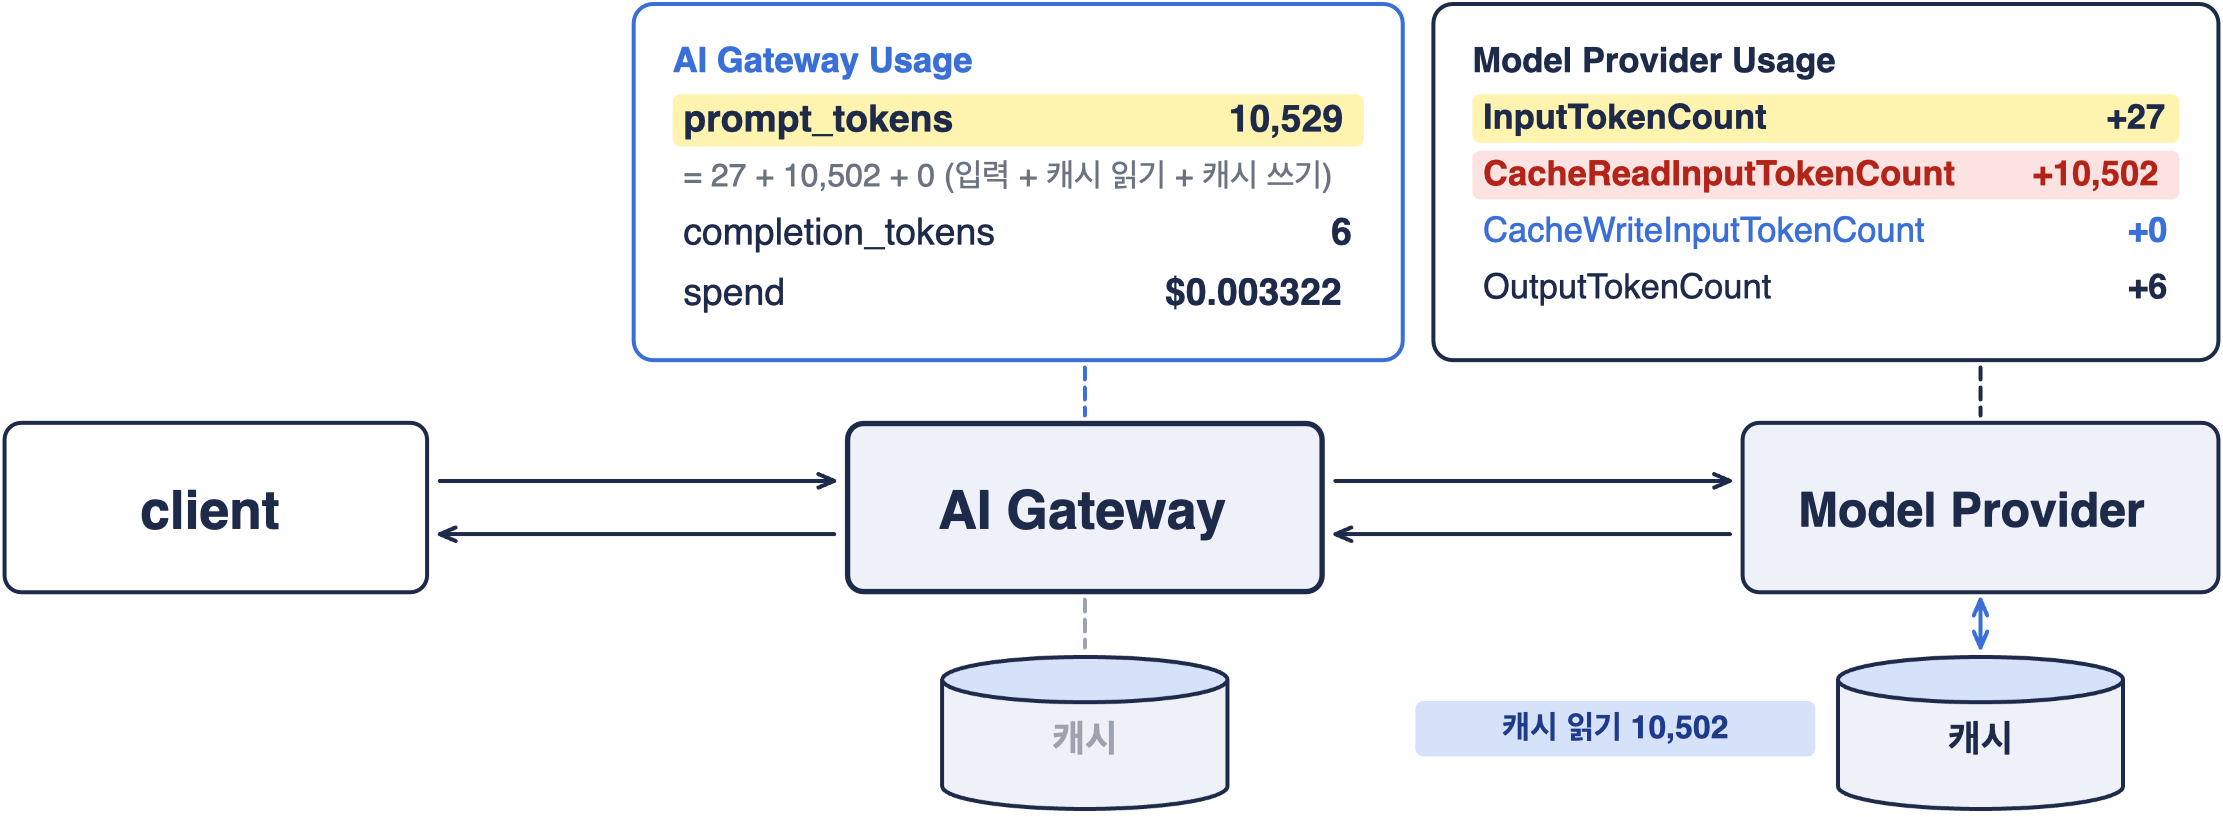
Bedrock에서 input 토큰을 계산하려면 아래 식으로 계산해야 합니다.
총 입력 토큰 = InputTokenCount + CacheReadInputTokenCount + CacheWriteInputTokenCount
변수C - AI Gateway와 client 연결 끊김
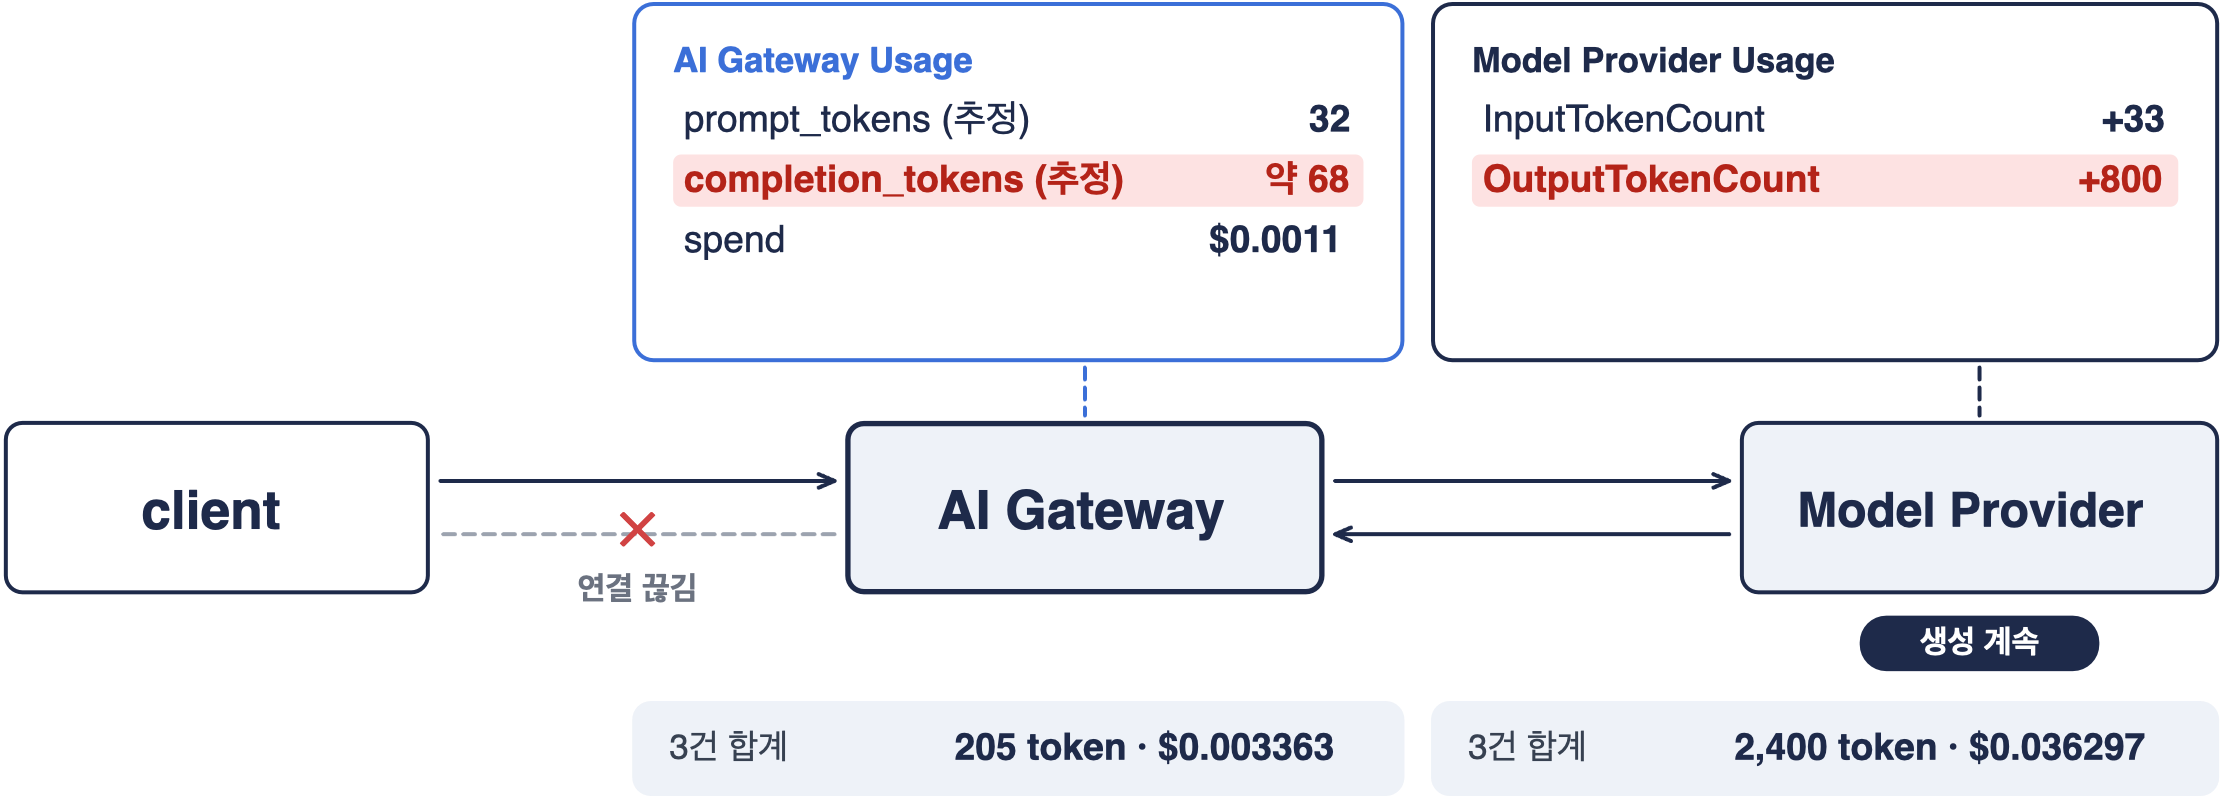
Model provider가 답변을 생성 중인데, client와 AI Gateway 연결이 끊기면 Bedrock output 토큰 개수가 더 많아집니다. AI Gateway는 client와 연결이 끊기기 전 output 토큰만 기록합니다.
변수D - AI Gateway와 Model provider 연결 끊김
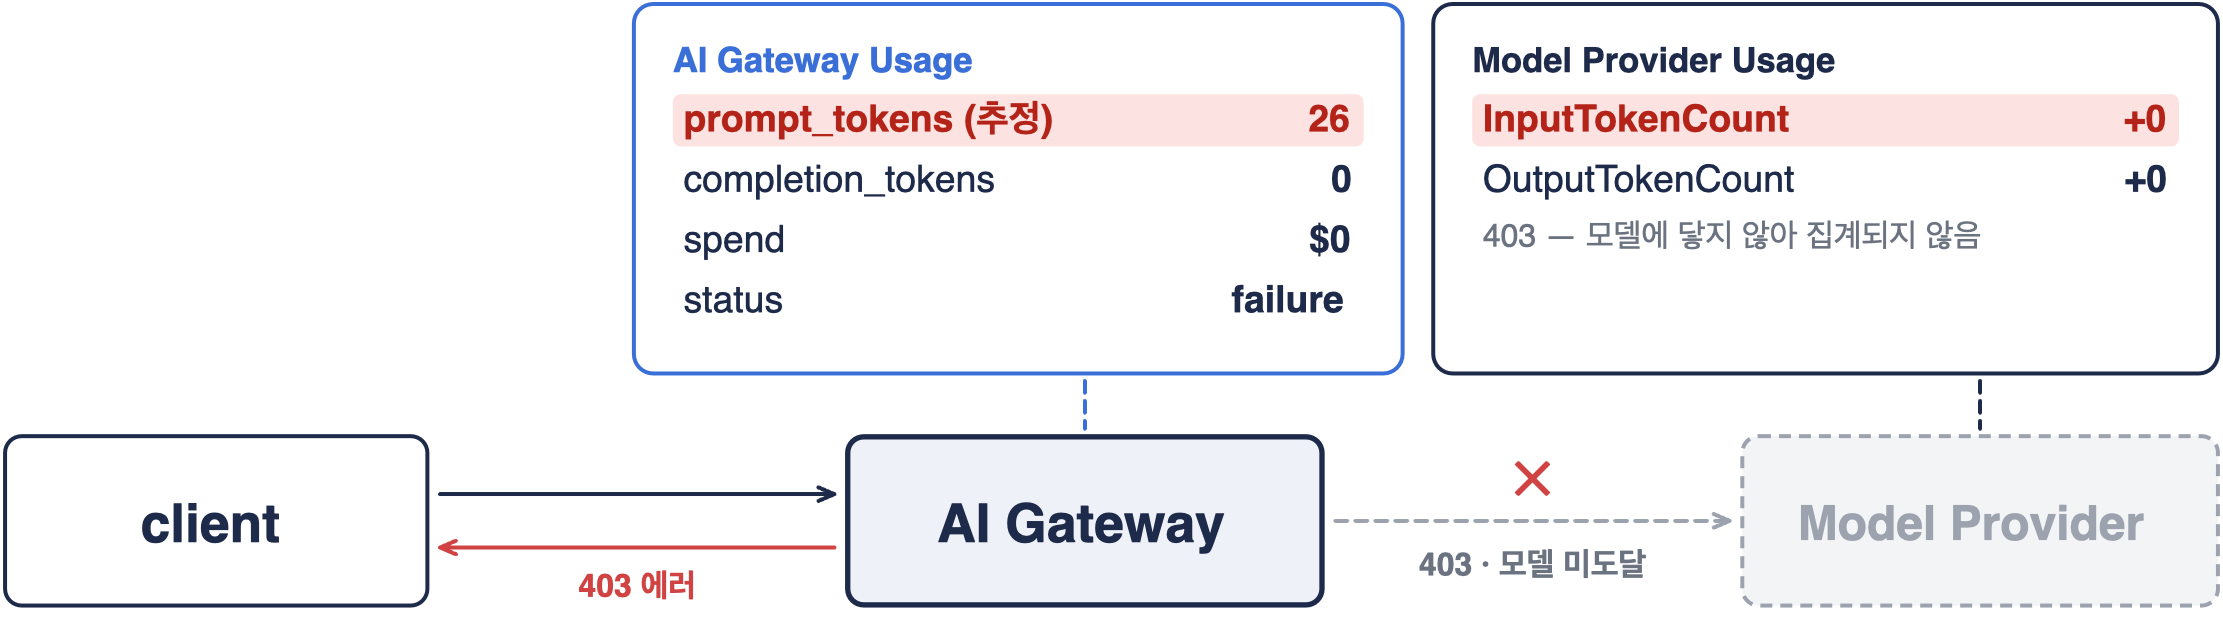
AI Gateway와 Model provider 연결이 끊겼는데, client 요청을 받으면 AI Gateway input 토큰만 증가합니다.
변수E - AI Gateway retry
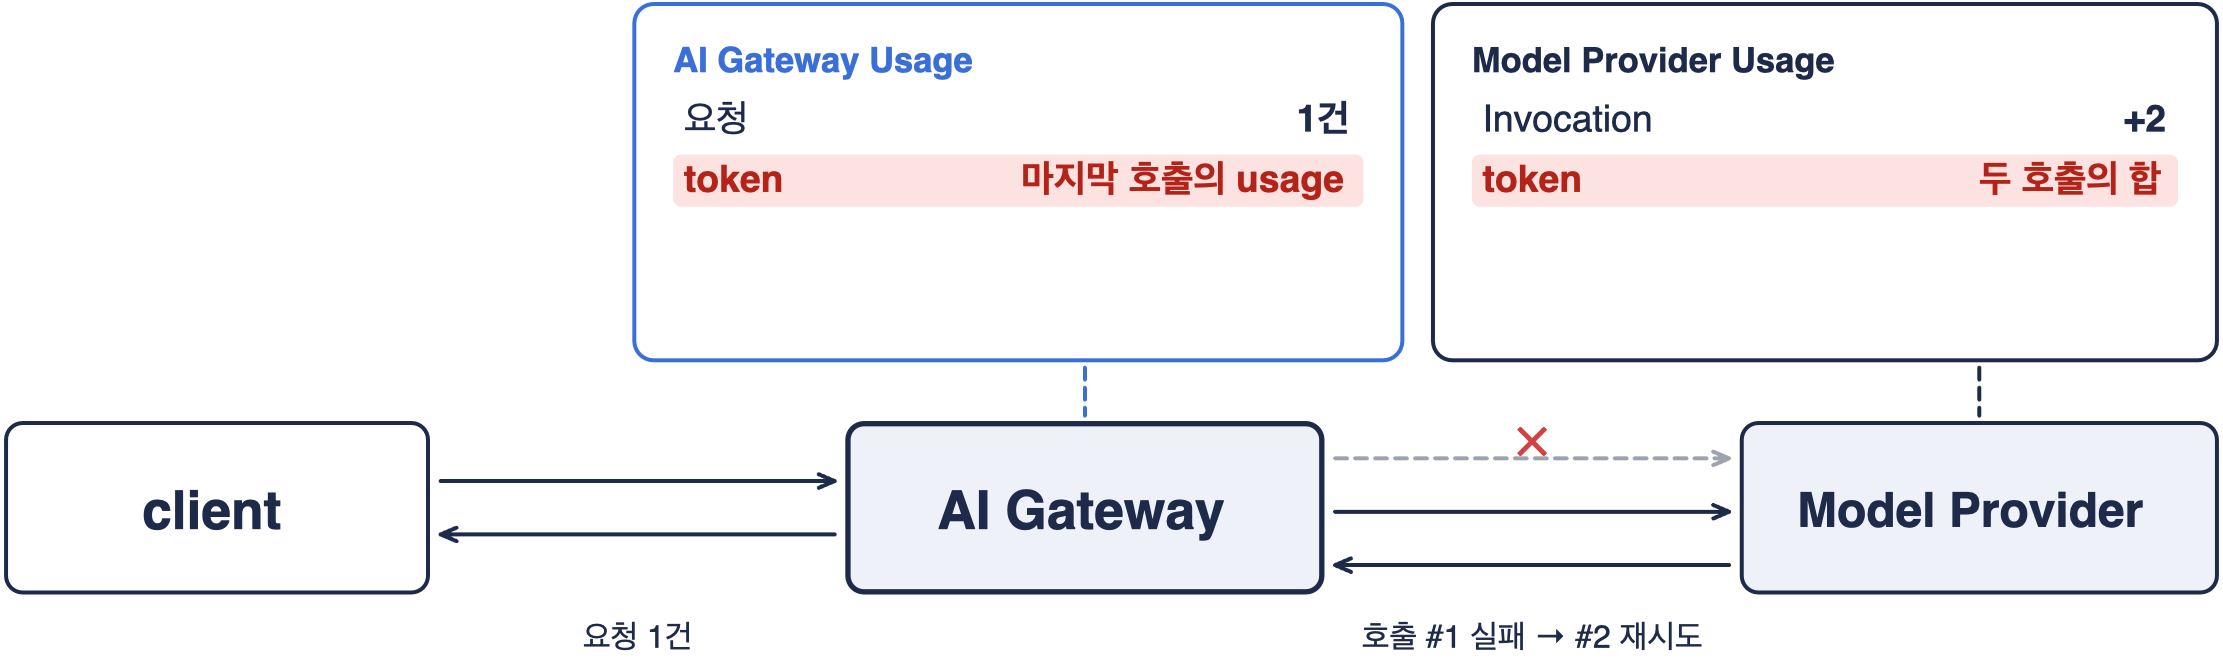
AI Gateway가 여러 가지 이유로 Model provider에 retry를 하면, Model provider의 output 토큰이 더 많아집니다.
정리
LiteLLM과 Bedrock으로 테스트한 결과를 정리
| A | LiteLLM 응답 캐시 hit | LiteLLM이 많음 | LiteLLM이 많음 | 같음 (LiteLLM 캐시 비용을 계산하지 않았을 때) |
| B | Bedrock prompt cache | LiteLLM이 많음 (InputTokenCount만 비교할 때) | 같음 | 같음 |
| C | client와 LiteLLM 연결 끊김 | 거의 같음 | Bedrock이 많음 | Bedrock이 많음 |
| D | LiteLLM과 Model provider 연결 끊김 | LiteLLM이 많음 | 같음 | 같음 |
| E | LiteLLM retry | Bedrock이 많음 | Bedrock이 많음 | Bedrock이 많음 |
'전공영역 공부 기록' 카테고리의 다른 글
| ECS 배포 파이프라인에서 고민한 것 (0) | 2026.10.05 |
|---|---|
| kubernetes sidecar가 왜 initContainers로 구현가능하게 했을까? Kubernetes native sidecar 간단 정리 (0) | 2026.09.13 |
| IP 기반 아웃바운드 방화벽에서 AWS 서비스 호출하는 방법 (2) | 2026.09.06 |
| vLLM 처리량 설정 옵션 - max_num_seqs(batch size) (0) | 2026.08.30 |
| vLLM KV Cache pool 크기는 무엇으로 결정될까? (0) | 2026.08.30 |