안녕하세요. 이 글은 스터디 2주차 내용을 정리했습니다. 스터디 2주차에는 ML 플랫폼이 일반적으로 제공하는 기능을 공부하면서 MLOps 사이클을 살펴봅니다.
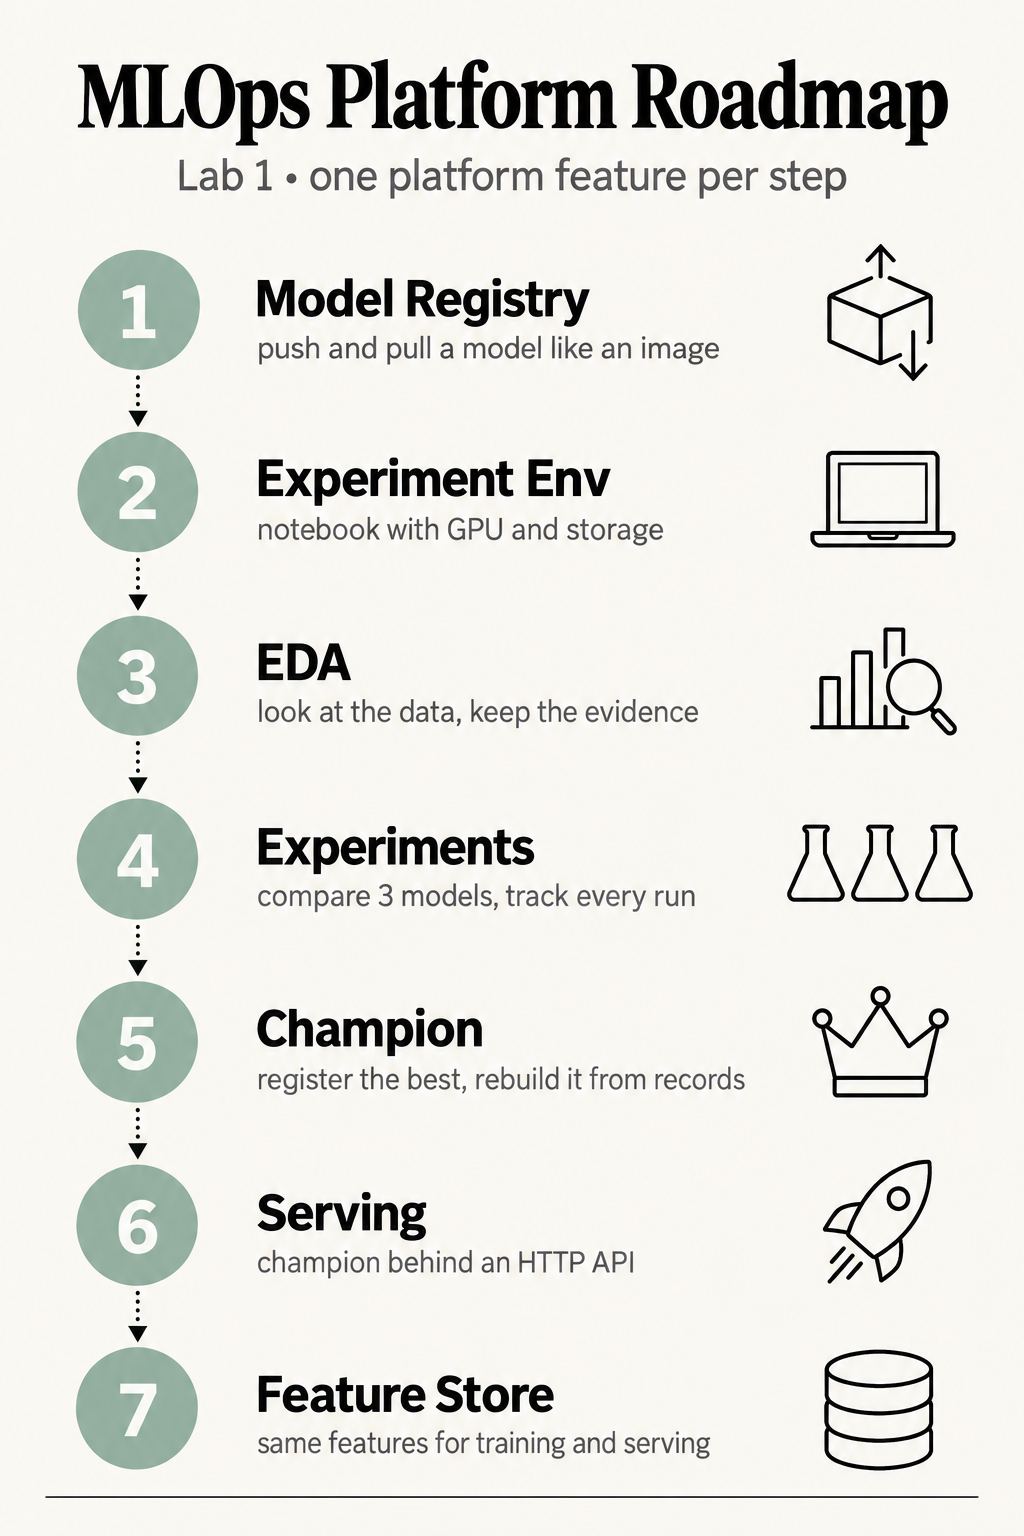
2주차에서는 아래 내용을 실습했습니다.
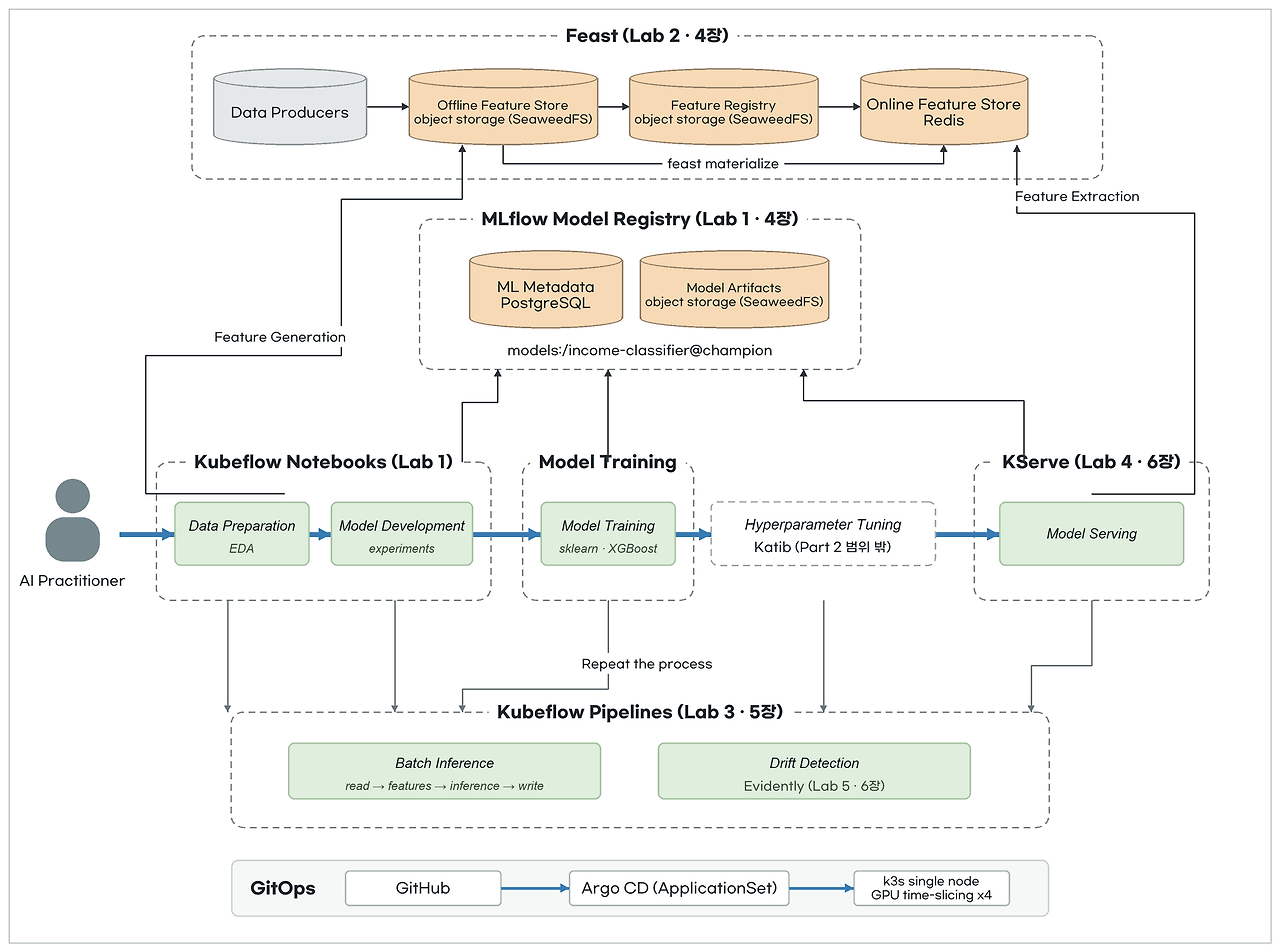
실습내용을 아키텍처로 펼치면 아래와 같습니다.
ML 플랫폼
ML 플랫폼이란 ML을 개발하고 배포하고 운영하기 위한 환경을 말합니다. 이 글에서는 Kubeflow, MLflow, feature store로 ML 플랫폼을 구축했습니다.
실습환경
| 이름 | 버전 | 기타 |
|---|---|---|
| Ubuntu | 24.04 LTS | GPU 서버 1대 |
| GPU | NVIDIA RTX 5060 Ti 16GB | 드라이버 595.71.05, time-slicing으로 4개로 나눔 |
| k3s(Kubernetes) | v1.36.5+k3s1 | 단일 노드, containerd 2.3.4 |
| NVIDIA device plugin | v0.20.1 | Helm chart 0.20.1 |
| Argo CD | v3.5.6 | ApplicationSet 3개, Application 21개 |
| Kubeflow | 26.03.1 | Community Distribution, 구성요소 16개 |
| Kubeflow Notebooks | v1.11.0 | 이미지 jupyter-scipy v1.11.0, Python 3.12.13 |
| Kubeflow Pipelines | 2.17.0 | SDK kfp 2.16.1, 실행 엔진 Argo Workflows v4.0.5 |
| KServe | v0.19.0 | Standard 모드, 런타임 직접 정의(mlflow-serve) |
| Istio | 1.30.2 | Kubeflow 배포판 포함 |
| Dex | v2.45.1 | Kubeflow 로그인 |
| cert-manager | v1.20.2 | Kubeflow 배포판 포함 |
| MLflow | 3.17.2 | community-charts Helm chart 1.11.7 |
| PostgreSQL | 18.6 | MLflow 메타데이터 |
| SeaweedFS | 4.34 | object storage(S3 호환), KFP 배포판 포함 |
| Feast | 0.67.0 | SDK와 UI(Helm chart feast-feature-server 0.67.0) |
| Redis | 8.10.2 | Feast 온라인 스토어 |
| scikit-learn, XGBoost | 1.8.0, 3.4.1 | 학습 라이브러리 |
ML 플랫폼 기능1 - IDE 제공
이론
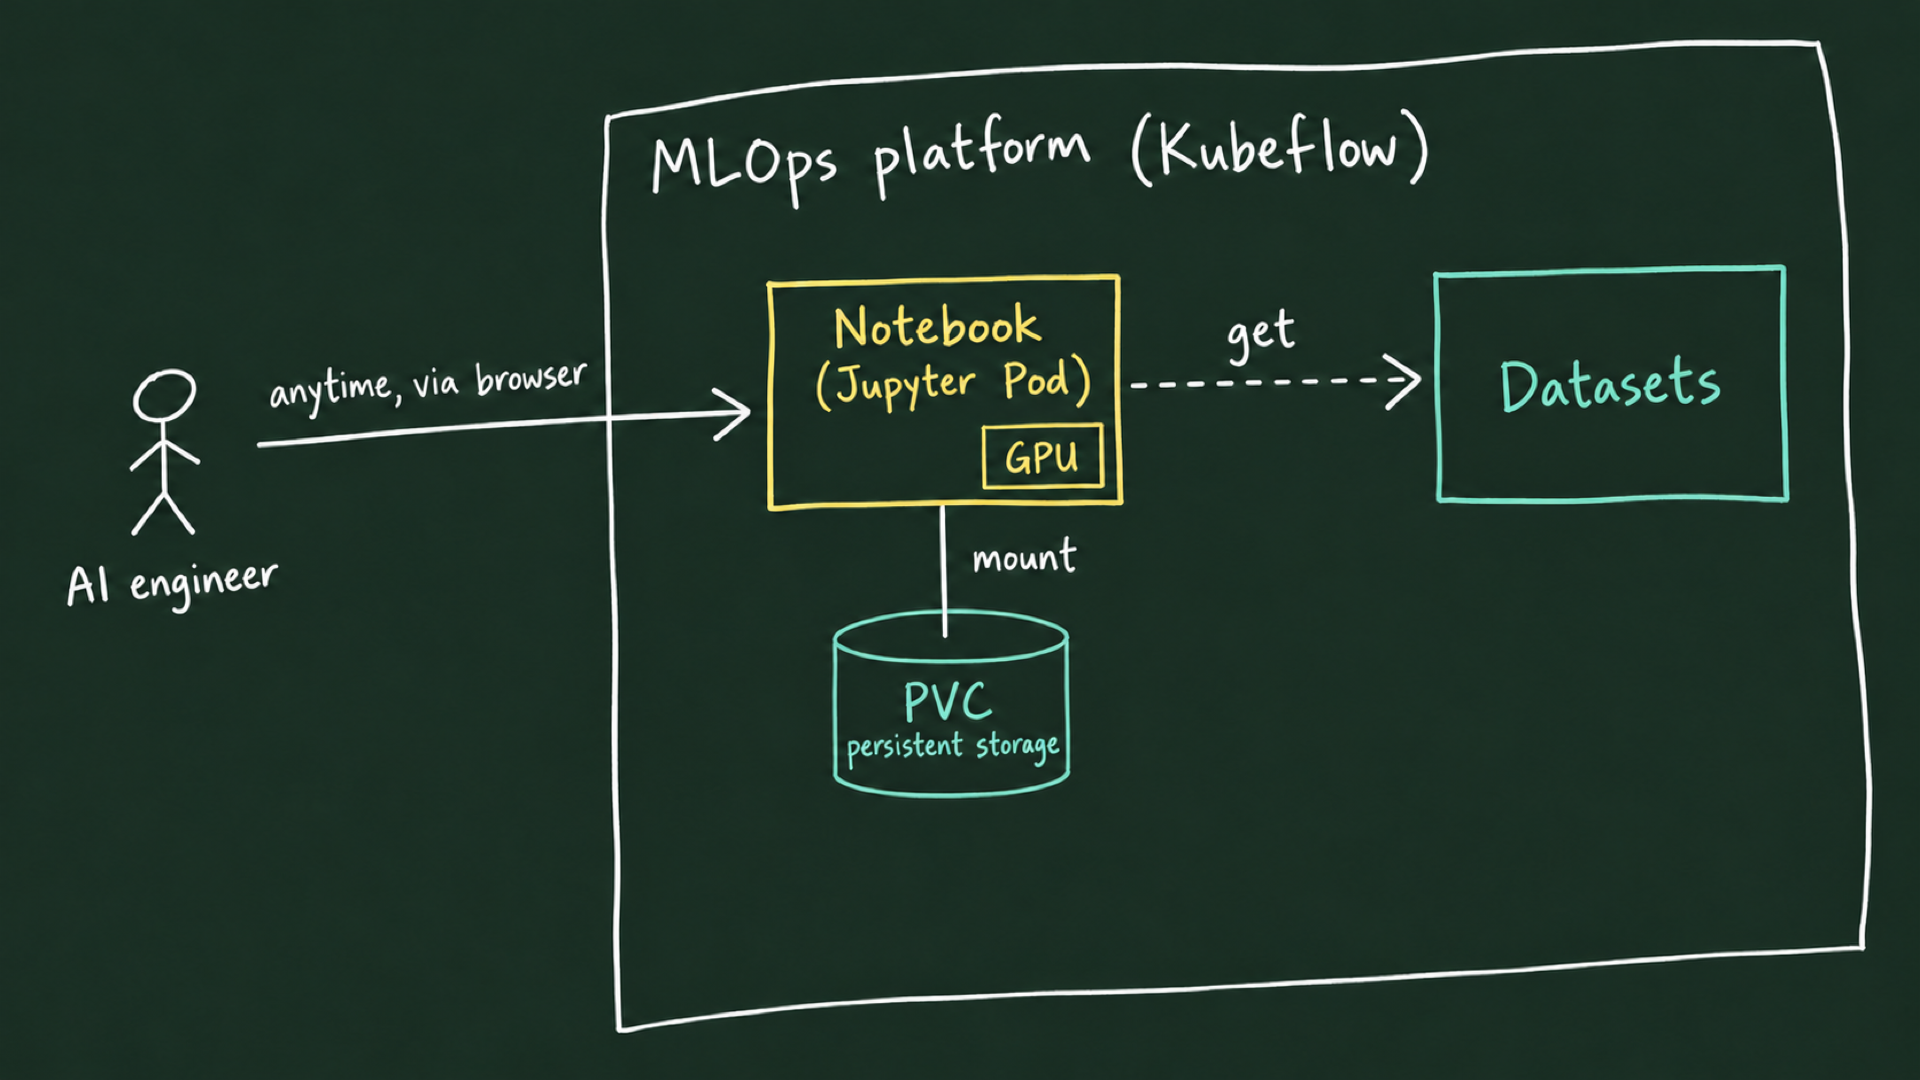
ML 플랫폼은 모델을 돌리는 인프라뿐 아니라 AI 엔지니어에게 IDE도 제공합니다. AI 엔지니어는 인터넷만 되는 환경이라면 IDE에 온라인으로 접속하여 연구할 수 있습니다. 보통 소프트웨어는 개발자가 자기 PC에서 개발하지만, 모델은 GPU와 데이터셋 등 소프트웨어와 다른 조건 때문에 로컬에서 연구하지 못할 수 있어서 IDE를 제공하는 경우가 많습니다.
예제
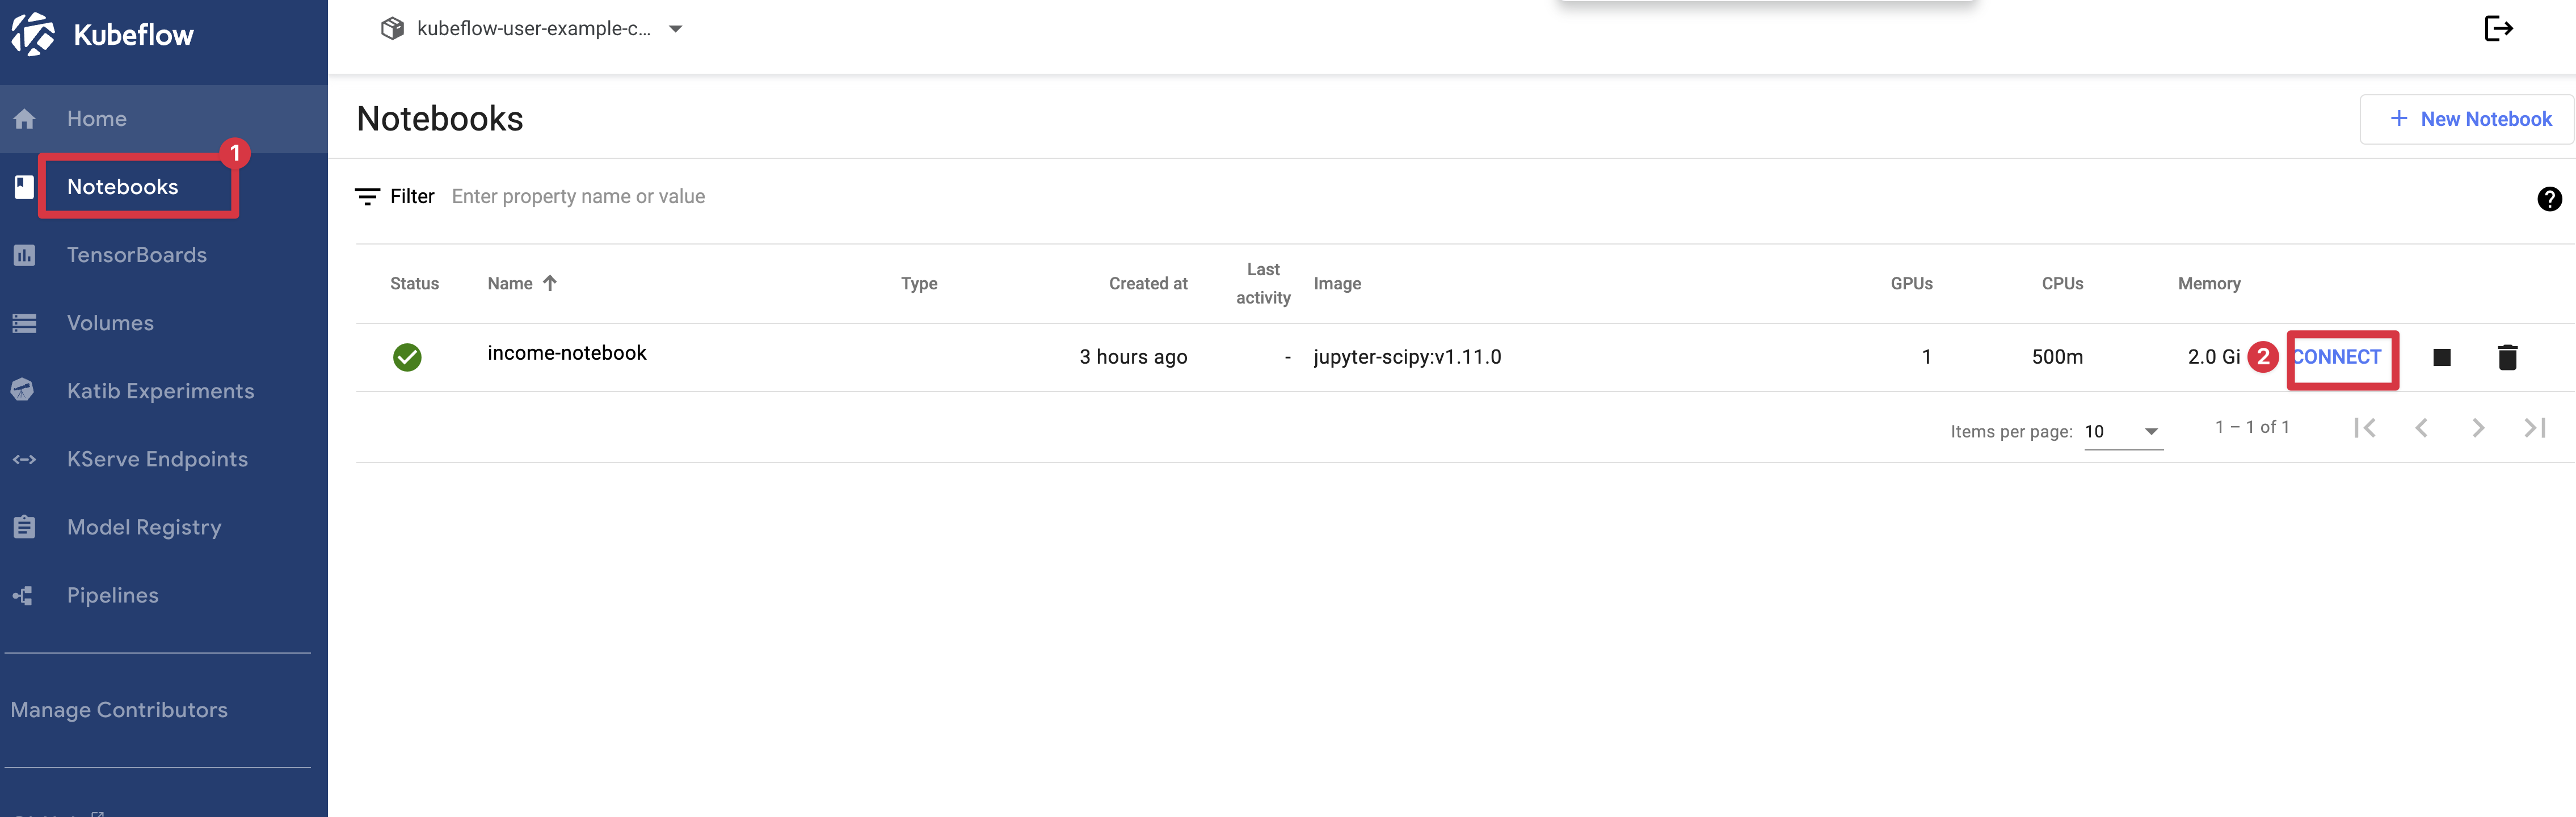
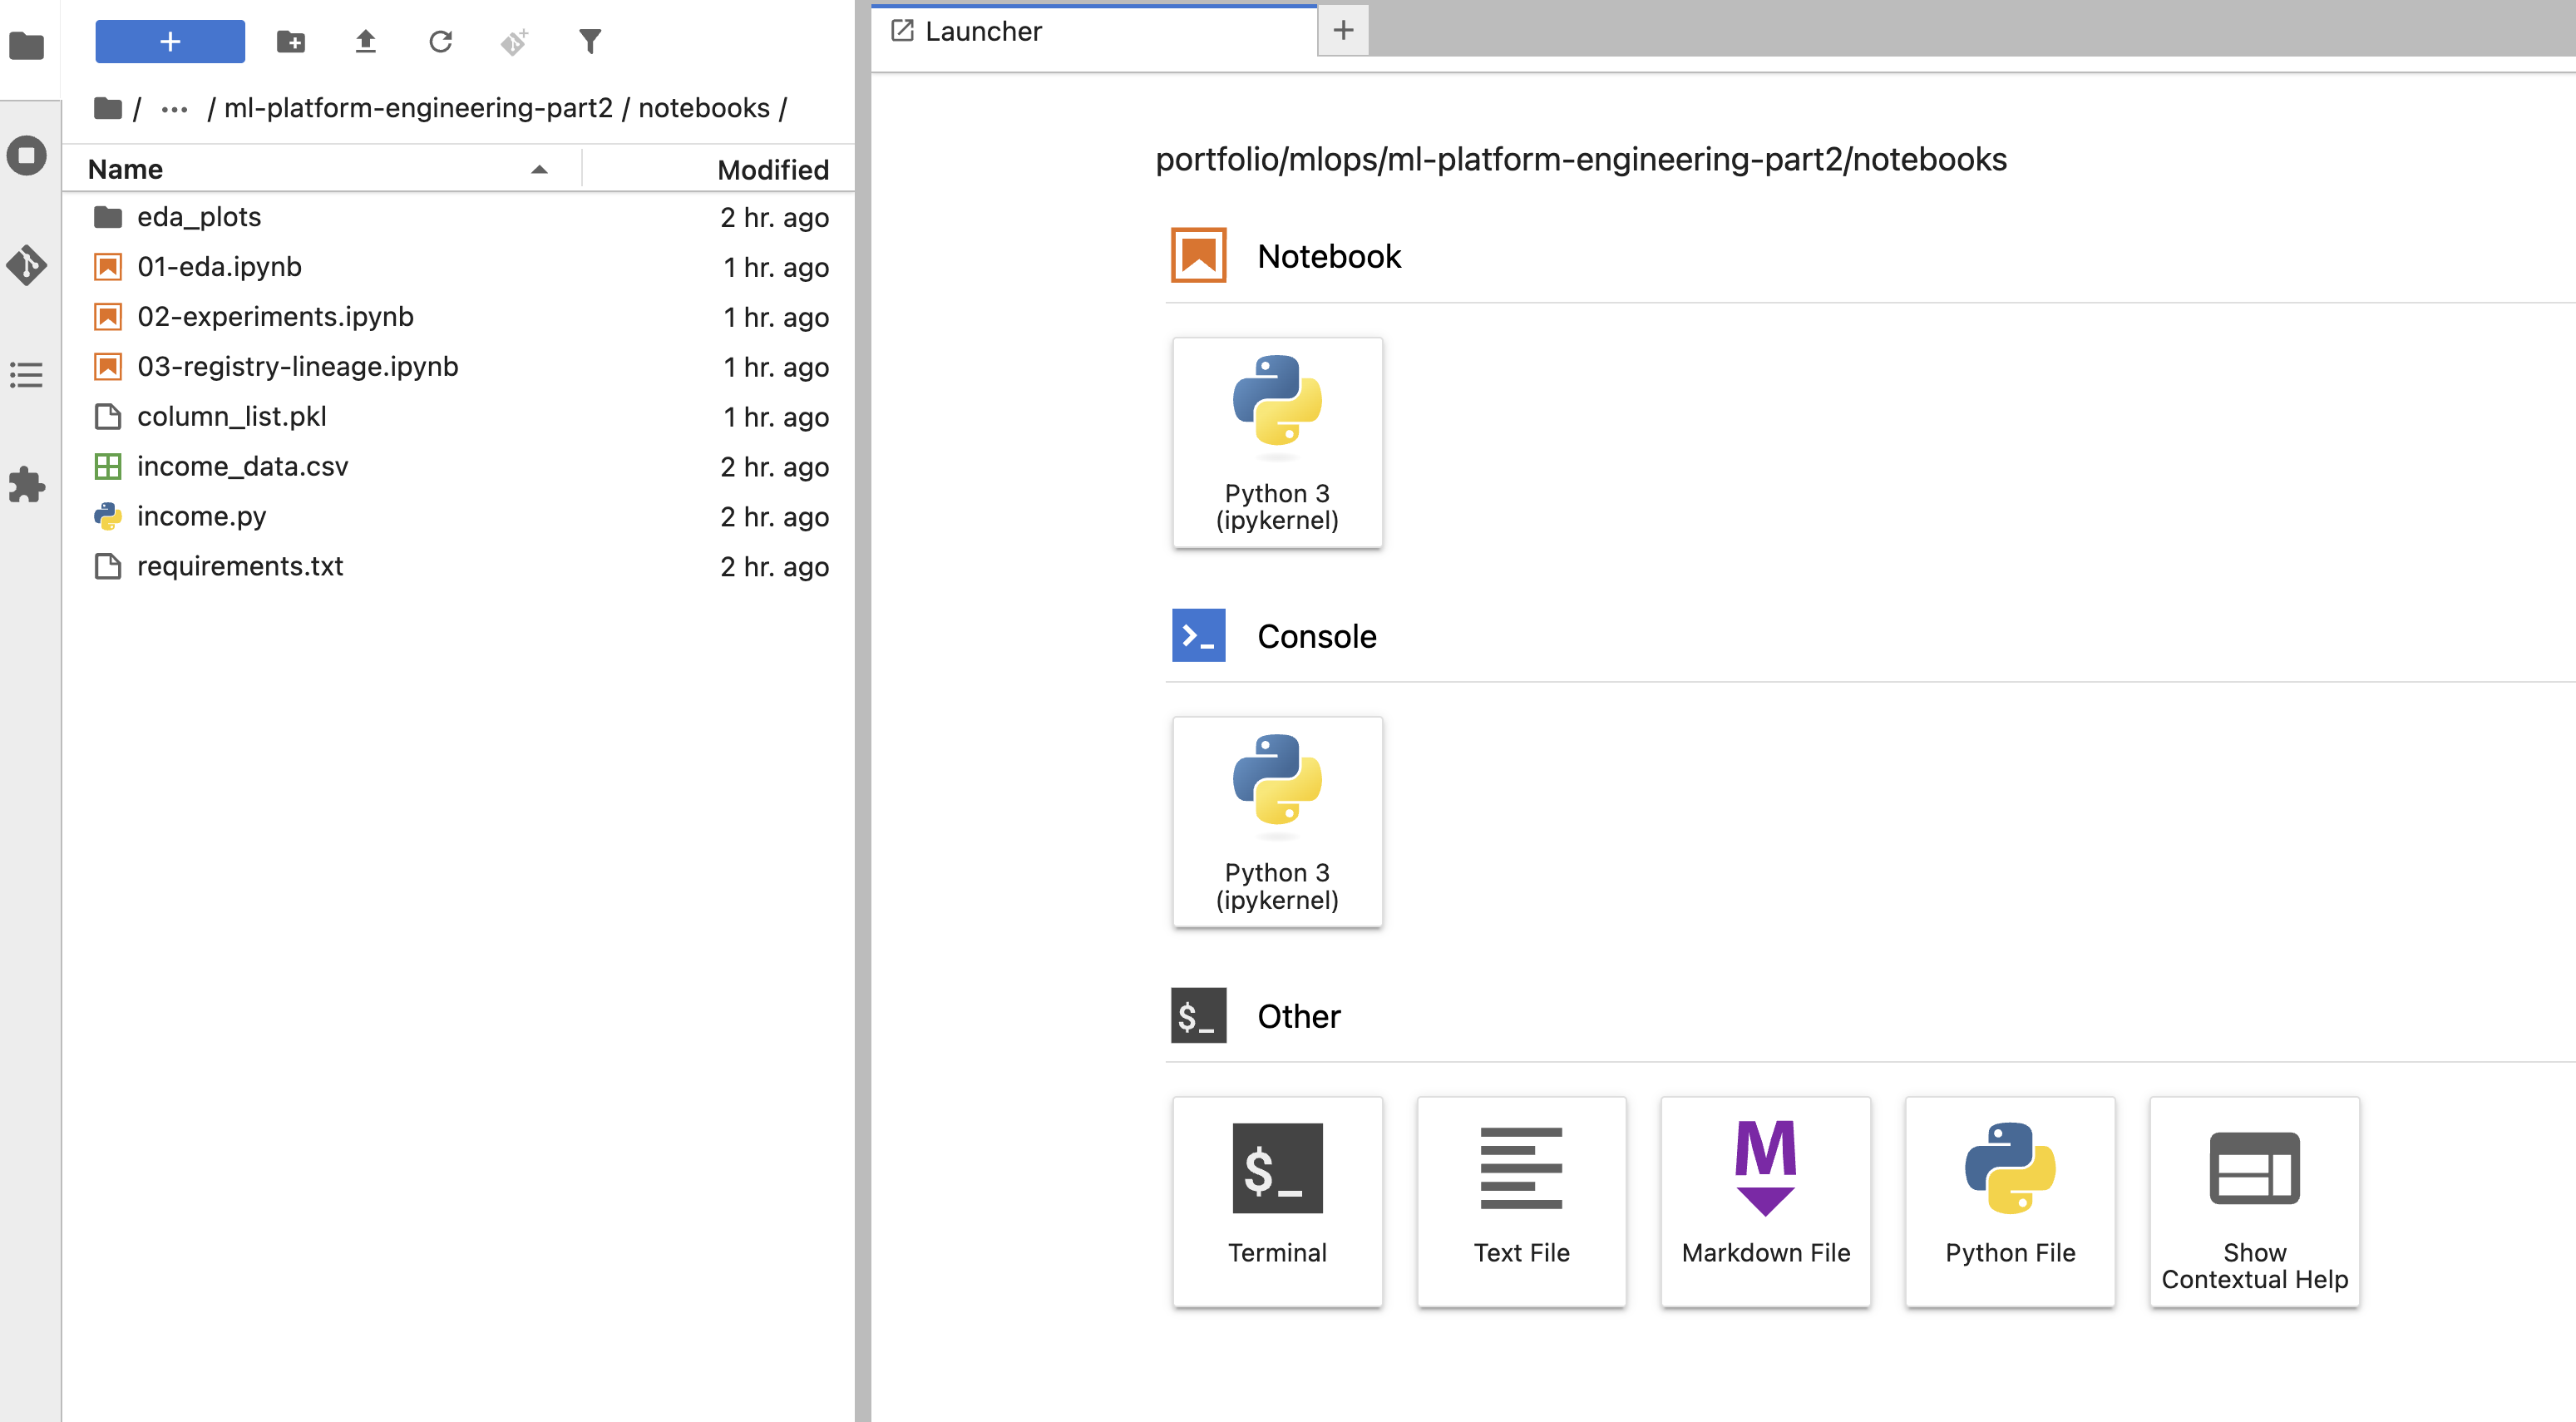
IDE로는 VS Code, JupyterLab, Jupyter Notebook 등을 제공할 수 있는데, Kubeflow는 기본값으로 JupyterLab이 설정됩니다. Kubeflow 왼쪽 메뉴에서 Notebook을 클릭하면 IDE 목록이 표시되고, Connect 버튼을 클릭하면 JupyterLab에 접속됩니다.
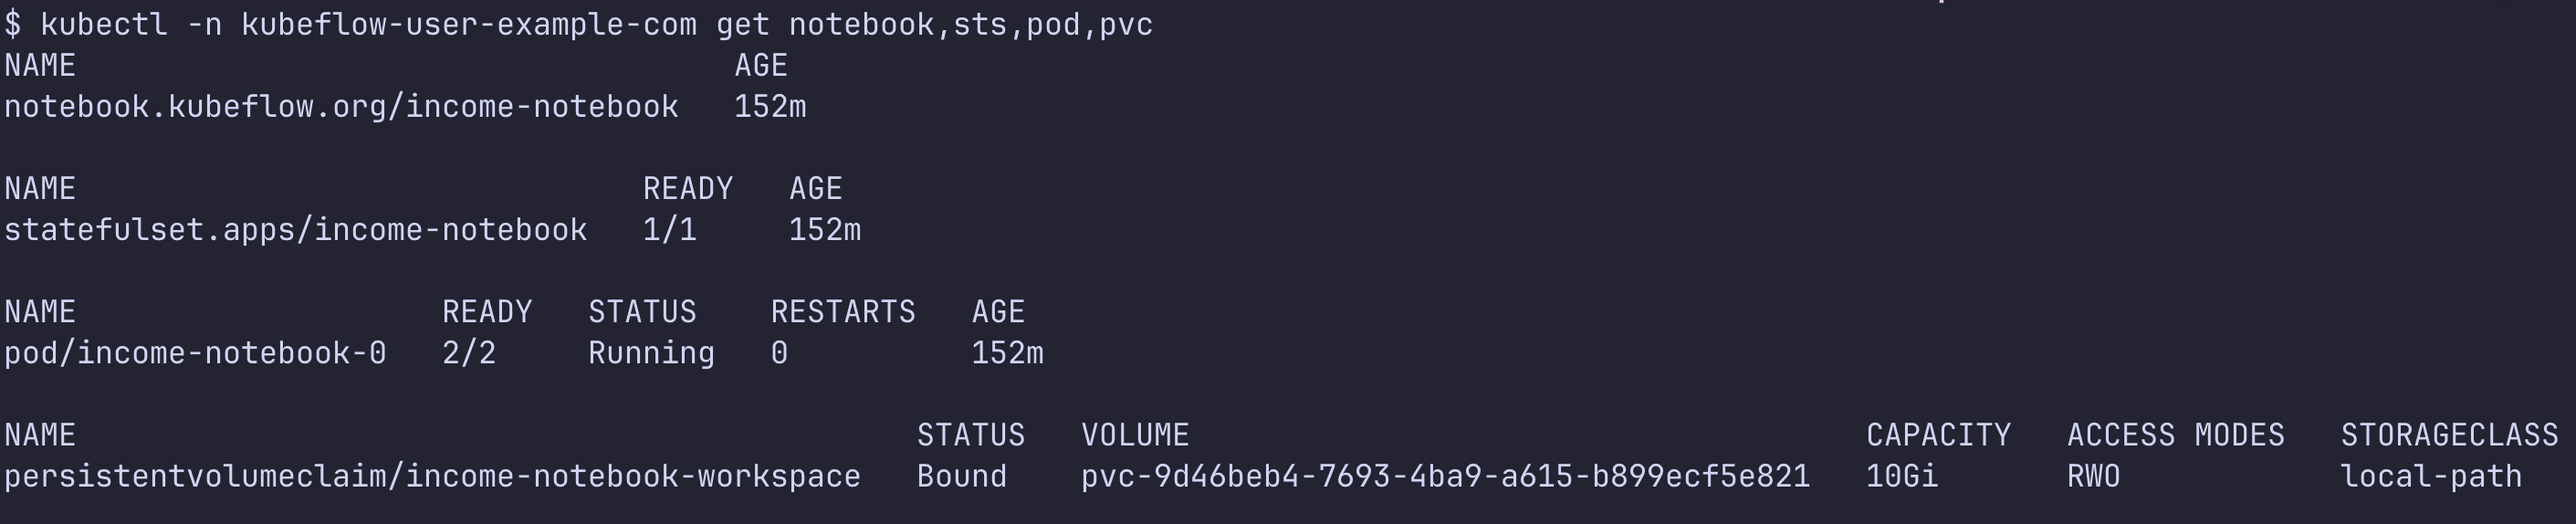
Kubeflow의 Notebook은 CRD로 관리됩니다. Notebook이 생성되면 StatefulSet, storage, network
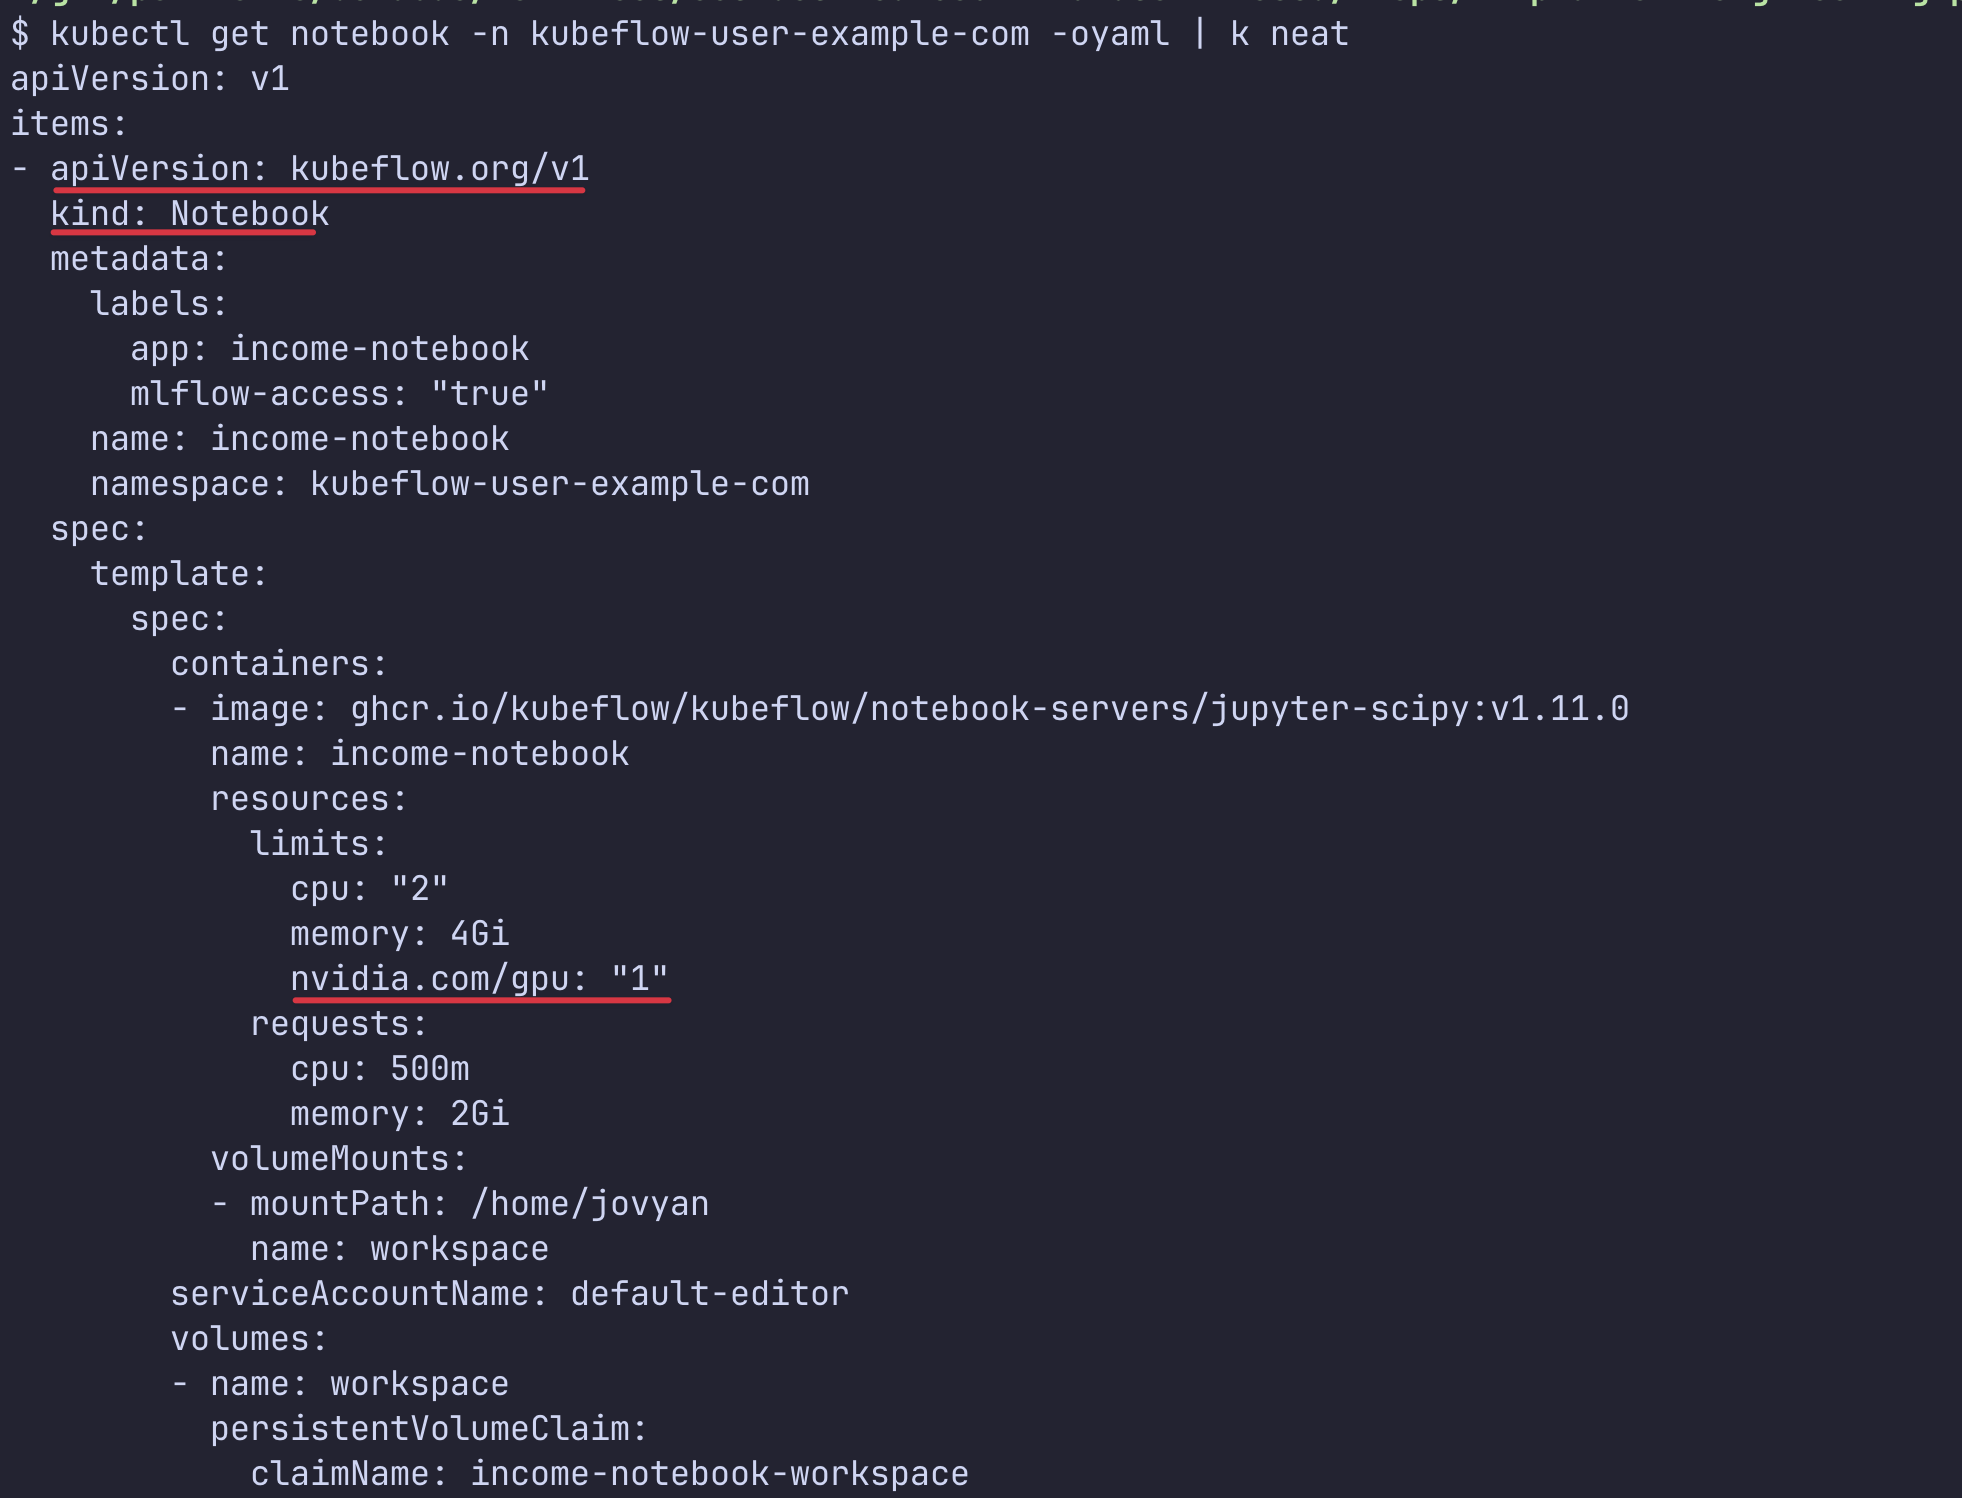
Notebook 리소스는 Notebook Controller가 관리합니다. Notebook Controller는 StatefulSet, 네트워크 설정 등을 제어합니다.

ML 플랫폼 기능2 - 모델 레지스트리
이론
IDE에서 만든 모델은 IDE에만 존재하기 때문에 다른 사람에게 공유하거나 서빙하려면 저장소에 모델을 저장해야 합니다. 모델을 저장하고 관리하는 구성 요소를 모델 레지스트리라고 합니다.
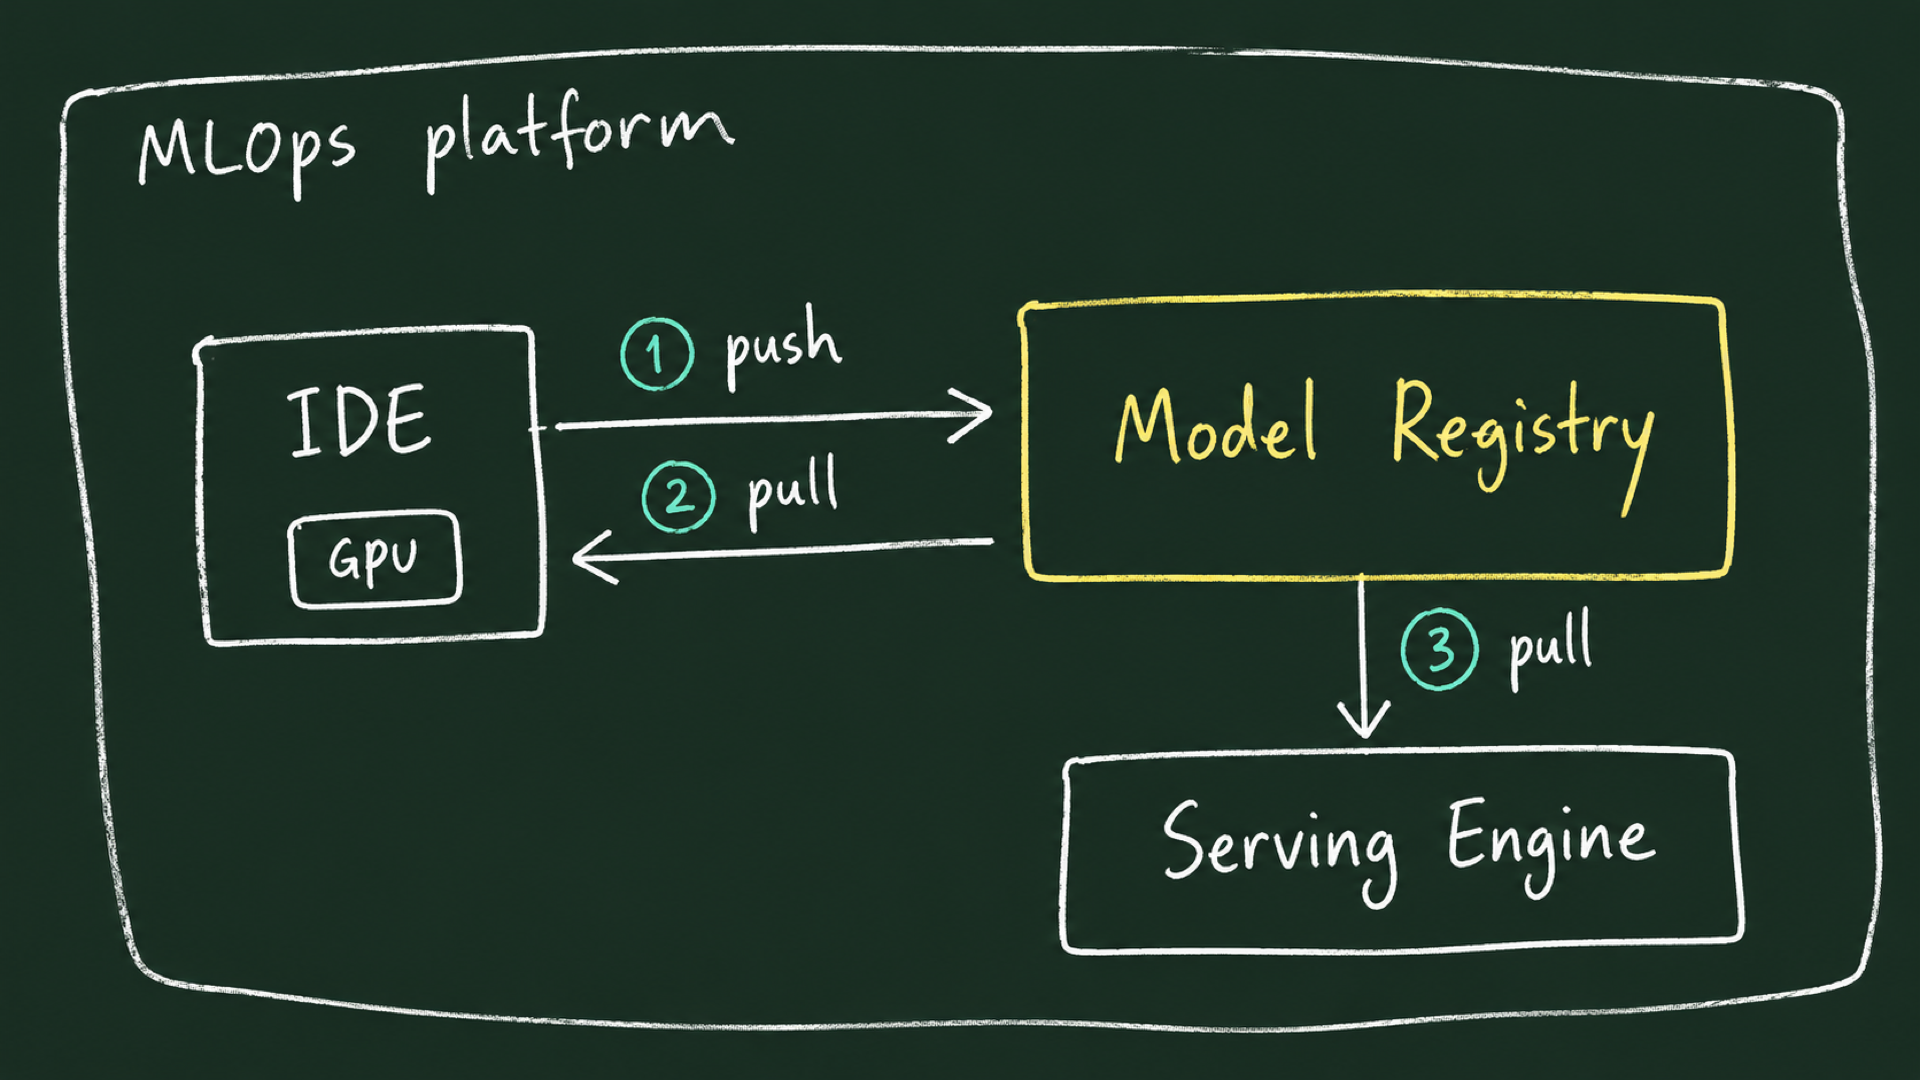
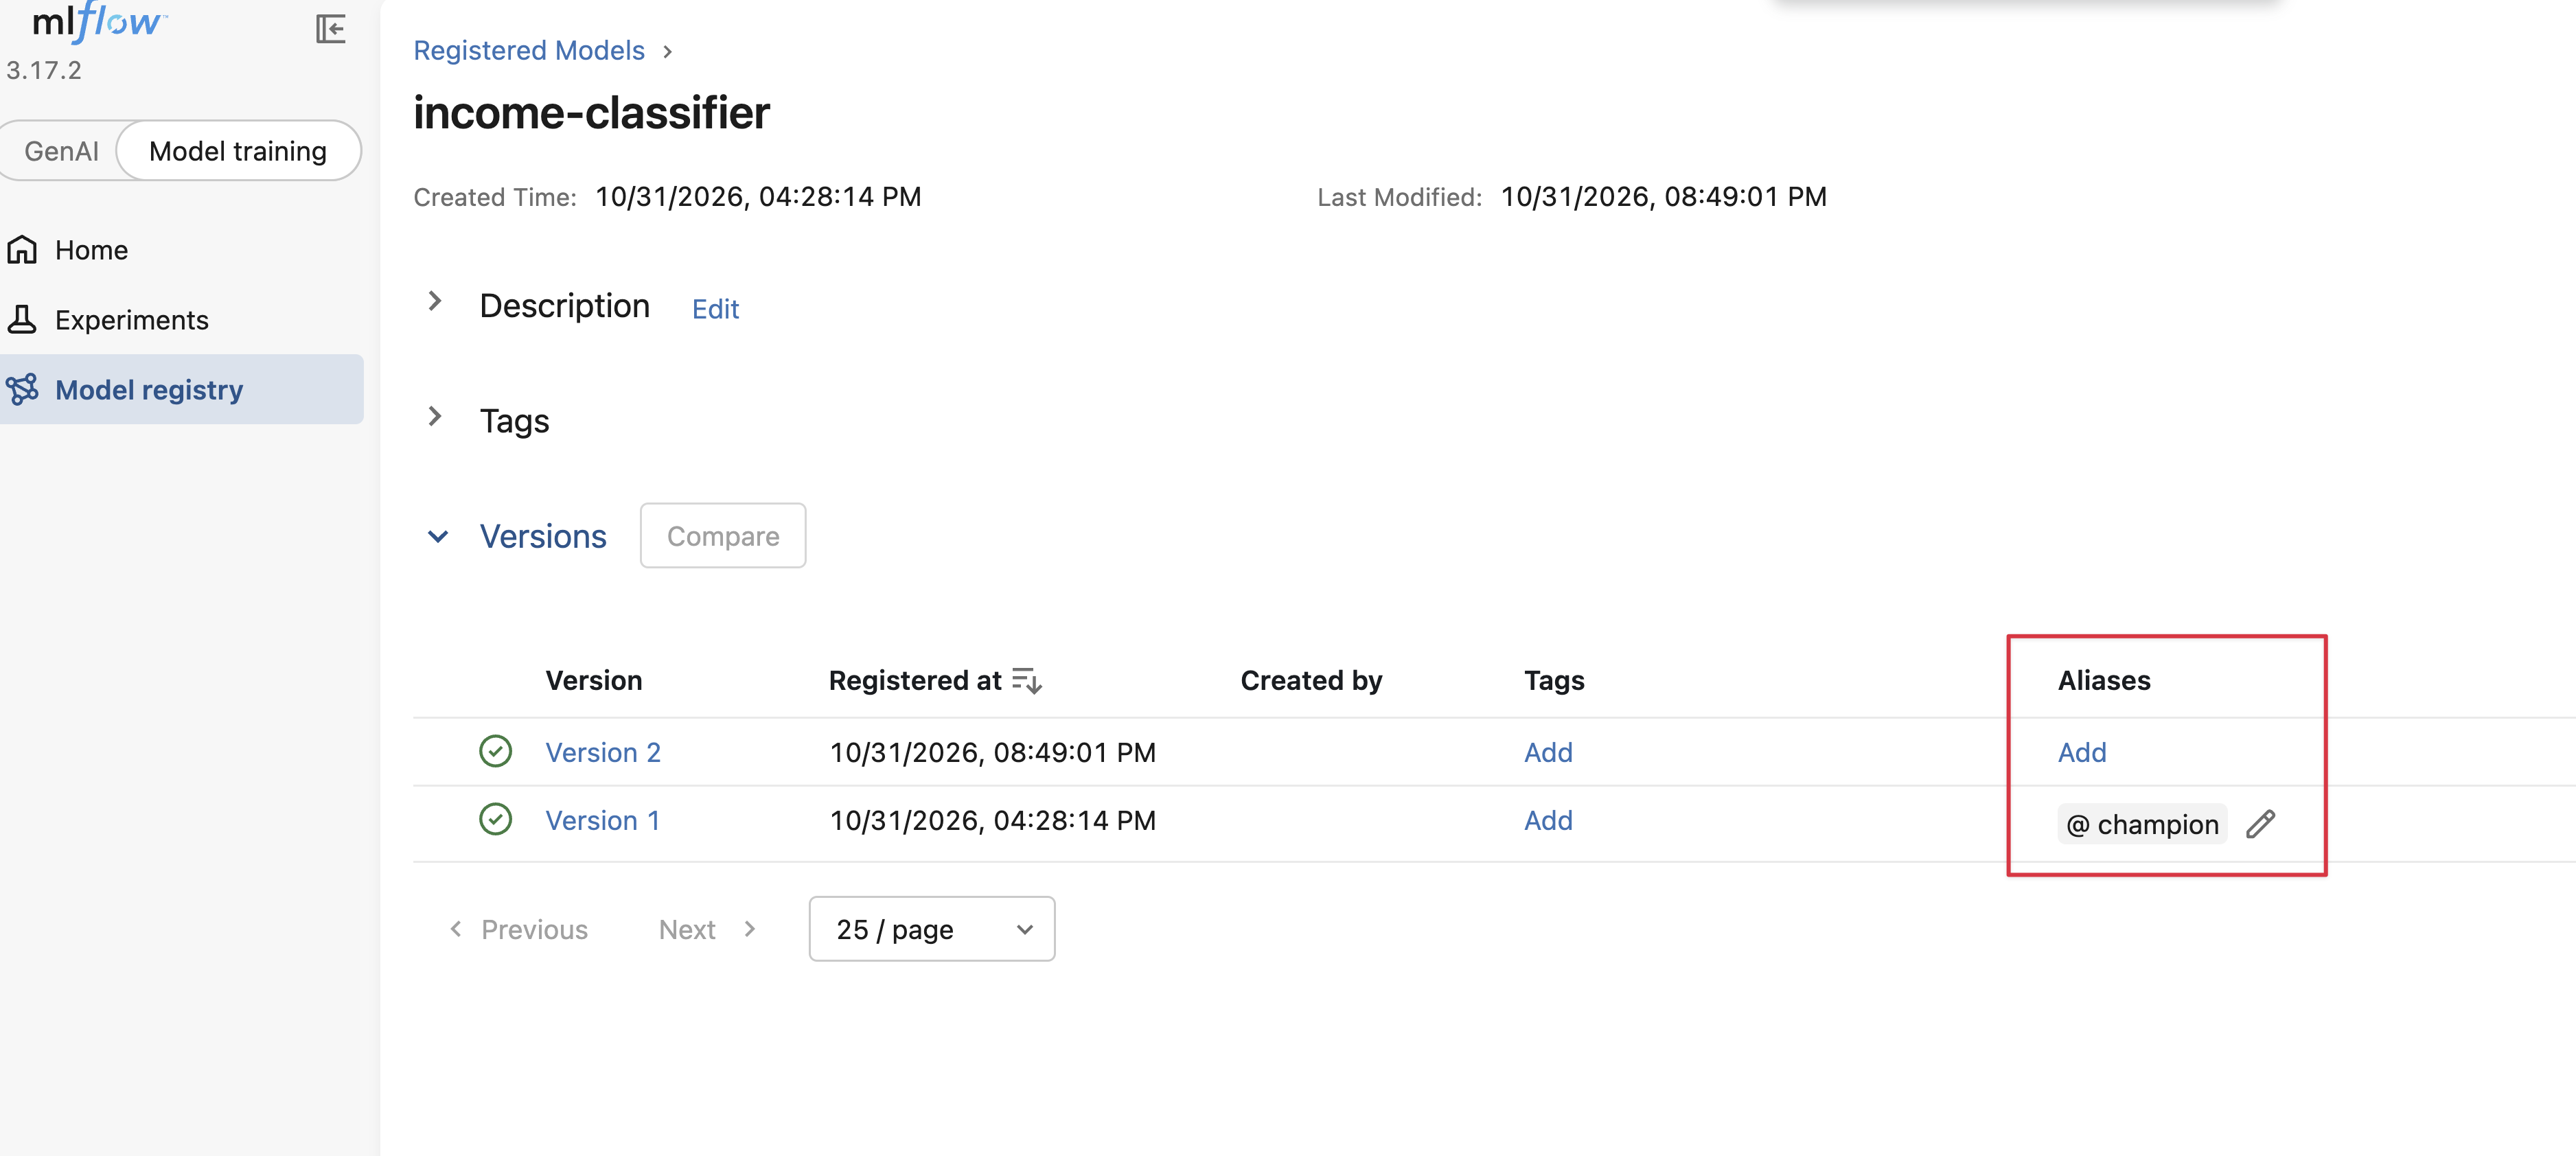
모델 레지스트리에는 소프트웨어 버전 관리와 비교하면 낯선 관례가 있습니다. 모델도 소프트웨어처럼 버전을 매기는데, 버전과 함께 alias도 관리합니다. 현재 서빙하는 모델은 champion, 후보는 challenger라고 부릅니다.
| 이름 | 종류 | 뜻 | 소프트웨어 배포에서 비슷한 것 |
|---|---|---|---|
champion |
alias | 지금 서빙하는 버전 | stable, prod tag |
challenger |
alias | champion과 비교 중인 후보 | canary, rc |
예제: MLflow Model Registry
실습은 MLflow Model Registry를 사용합니다. 모델을 MLflow Model Registry에 push하는 방법은 다양한데, 아래에서는 모델을 만드는 과정에서 log_model 함수로 push했습니다. 그리고 set_registered_model_alias로 alias를 설정했습니다.
x, y = load_breast_cancer(return_X_y=True, as_frame=True)
model = LogisticRegression(max_iter=5000).fit(x, y)
mlflow.set_experiment("registry-quickstart")
with mlflow.start_run(run_name="push"):
    info = mlflow.sklearn.log_model(model, name="model", input_example=x.head(3),
                                     registered_model_name=MODEL_NAME)
    version = info.registered_model_version

MlflowClient().set_registered_model_alias(MODEL_NAME, ALIAS, version)
print(f"pushed {MODEL_NAME} v{version} @{ALIAS}")
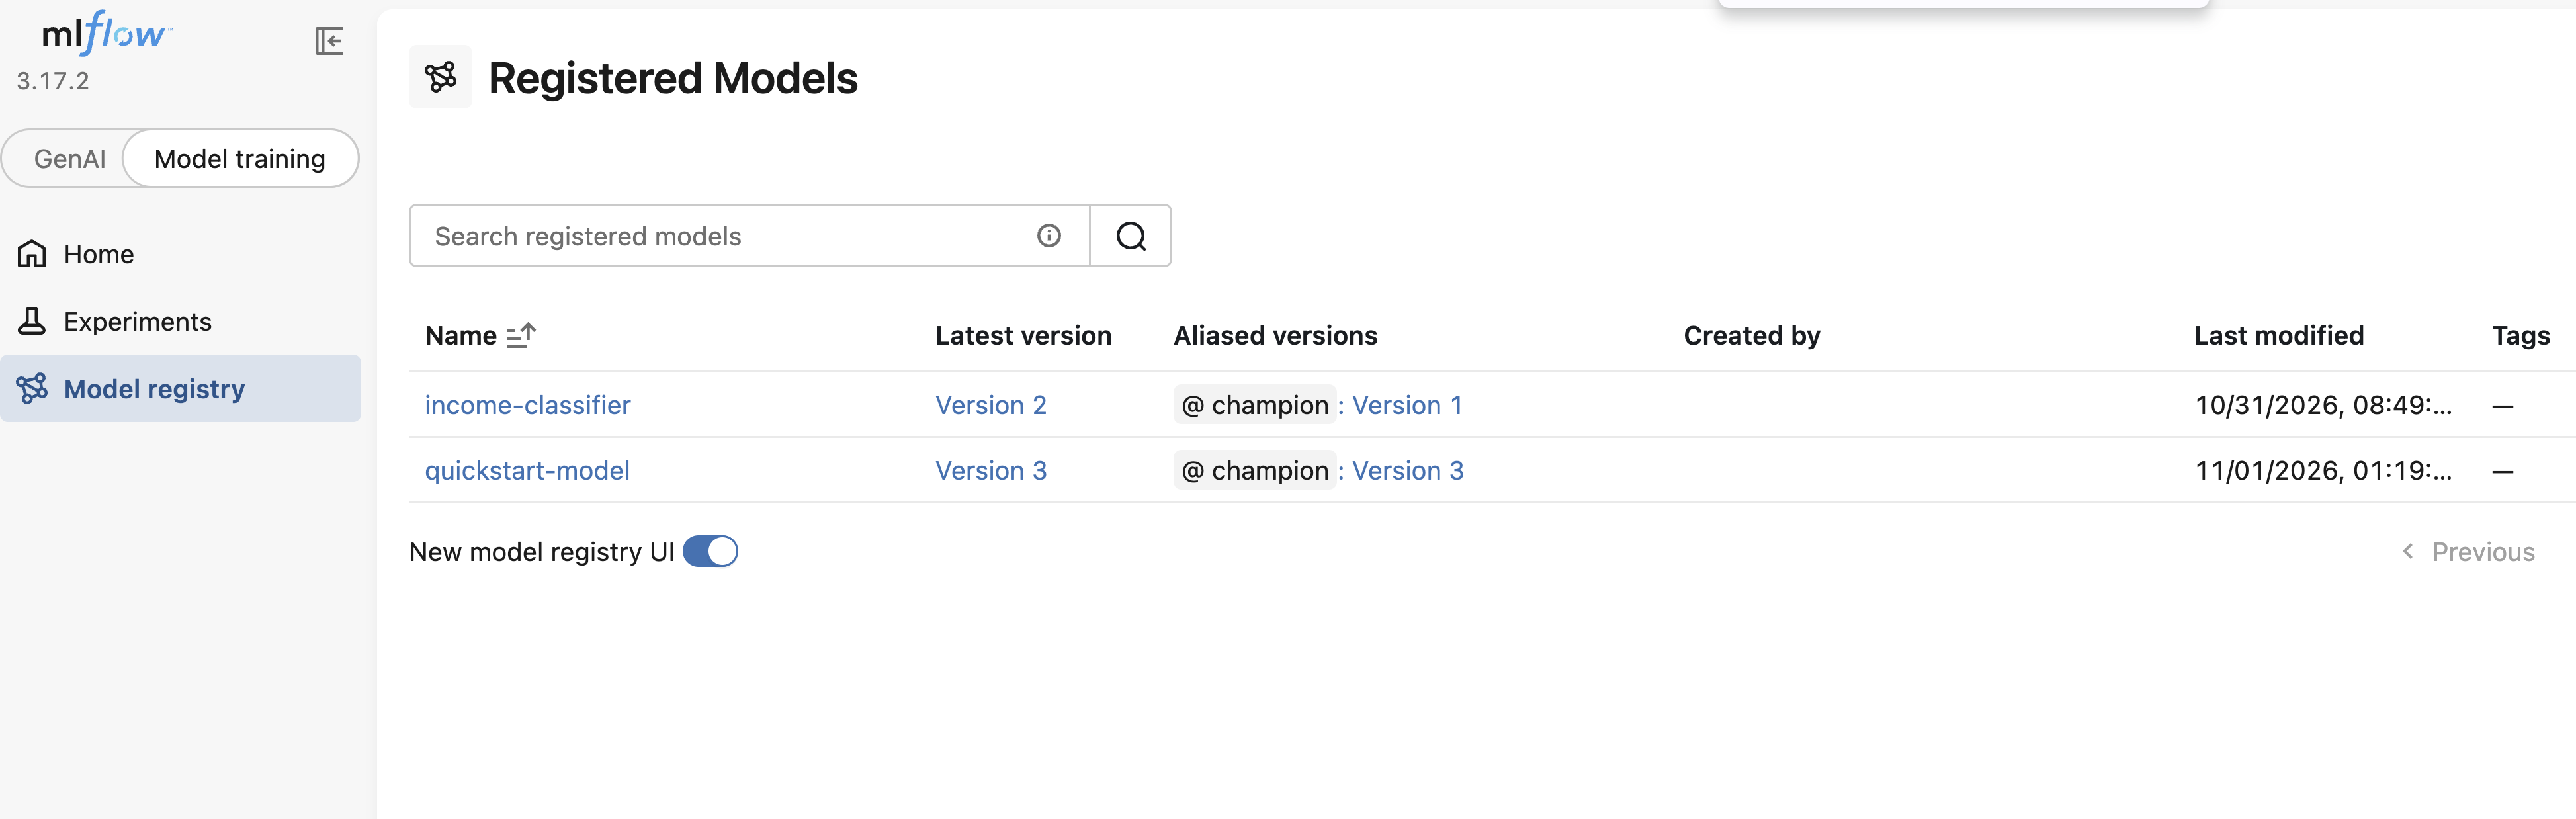
MLflow에서는 model registry라는 메뉴에 push한 모델이 표시됩니다.
MLflow Model Registry가 관리하는 모델을 다운로드하는 방법도 다양한데, 아래에서는 load_model 함수를 사용했습니다.
uri = f"models:/{MODEL_NAME}@{ALIAS}"
model = mlflow.pyfunc.load_model(uri)
x, _ = load_breast_cancer(return_X_y=True, as_frame=True)

version = MlflowClient().get_model_version_by_alias(MODEL_NAME, ALIAS).version

print(f"pulled {uri} (v{version}) predict={model.predict(x.head(3)).tolist()}")
ML 플랫폼 기능3 - EDA
이론
ML 플랫폼은 EDA 결과를 저장하는 기능을 제공해야 합니다.
AI 엔지니어는 모델을 만들거나 개선하기 위해 데이터를 탐색하고 분석합니다. 이 탐색과 분석 작업을 EDA(Exploratory Data Analysis, 탐색적 데이터 분석)라고 합니다.
EDA에서는 탐색하거나 분석한 결과를 안전하게 저장하는 일이 중요합니다. IDE에서 EDA 결과를 저장할 수 있지만, 결과가 IDE 실행 출력에만 있기 때문에 IDE를 다시 시작하는 순간 EDA 관련 자료가 사라집니다. 또한 IDE에 있는 EDA 자료는 공유가 안 되고 버저닝하기도 힘듭니다.
따라서 ML 플랫폼은 EDA 결과를 저장하는 기능을 제공해야 합니다. 많이 쓰이는 오픈소스는 MLflow입니다.
예제
이 책 예제에서는 연소득이 5만 달러가 넘는지 예측하기 위해, 미국 인구조사에서 뽑은 성인 데이터를 탐색합니다. 데이터를 불러와서 plot으로 분석합니다.
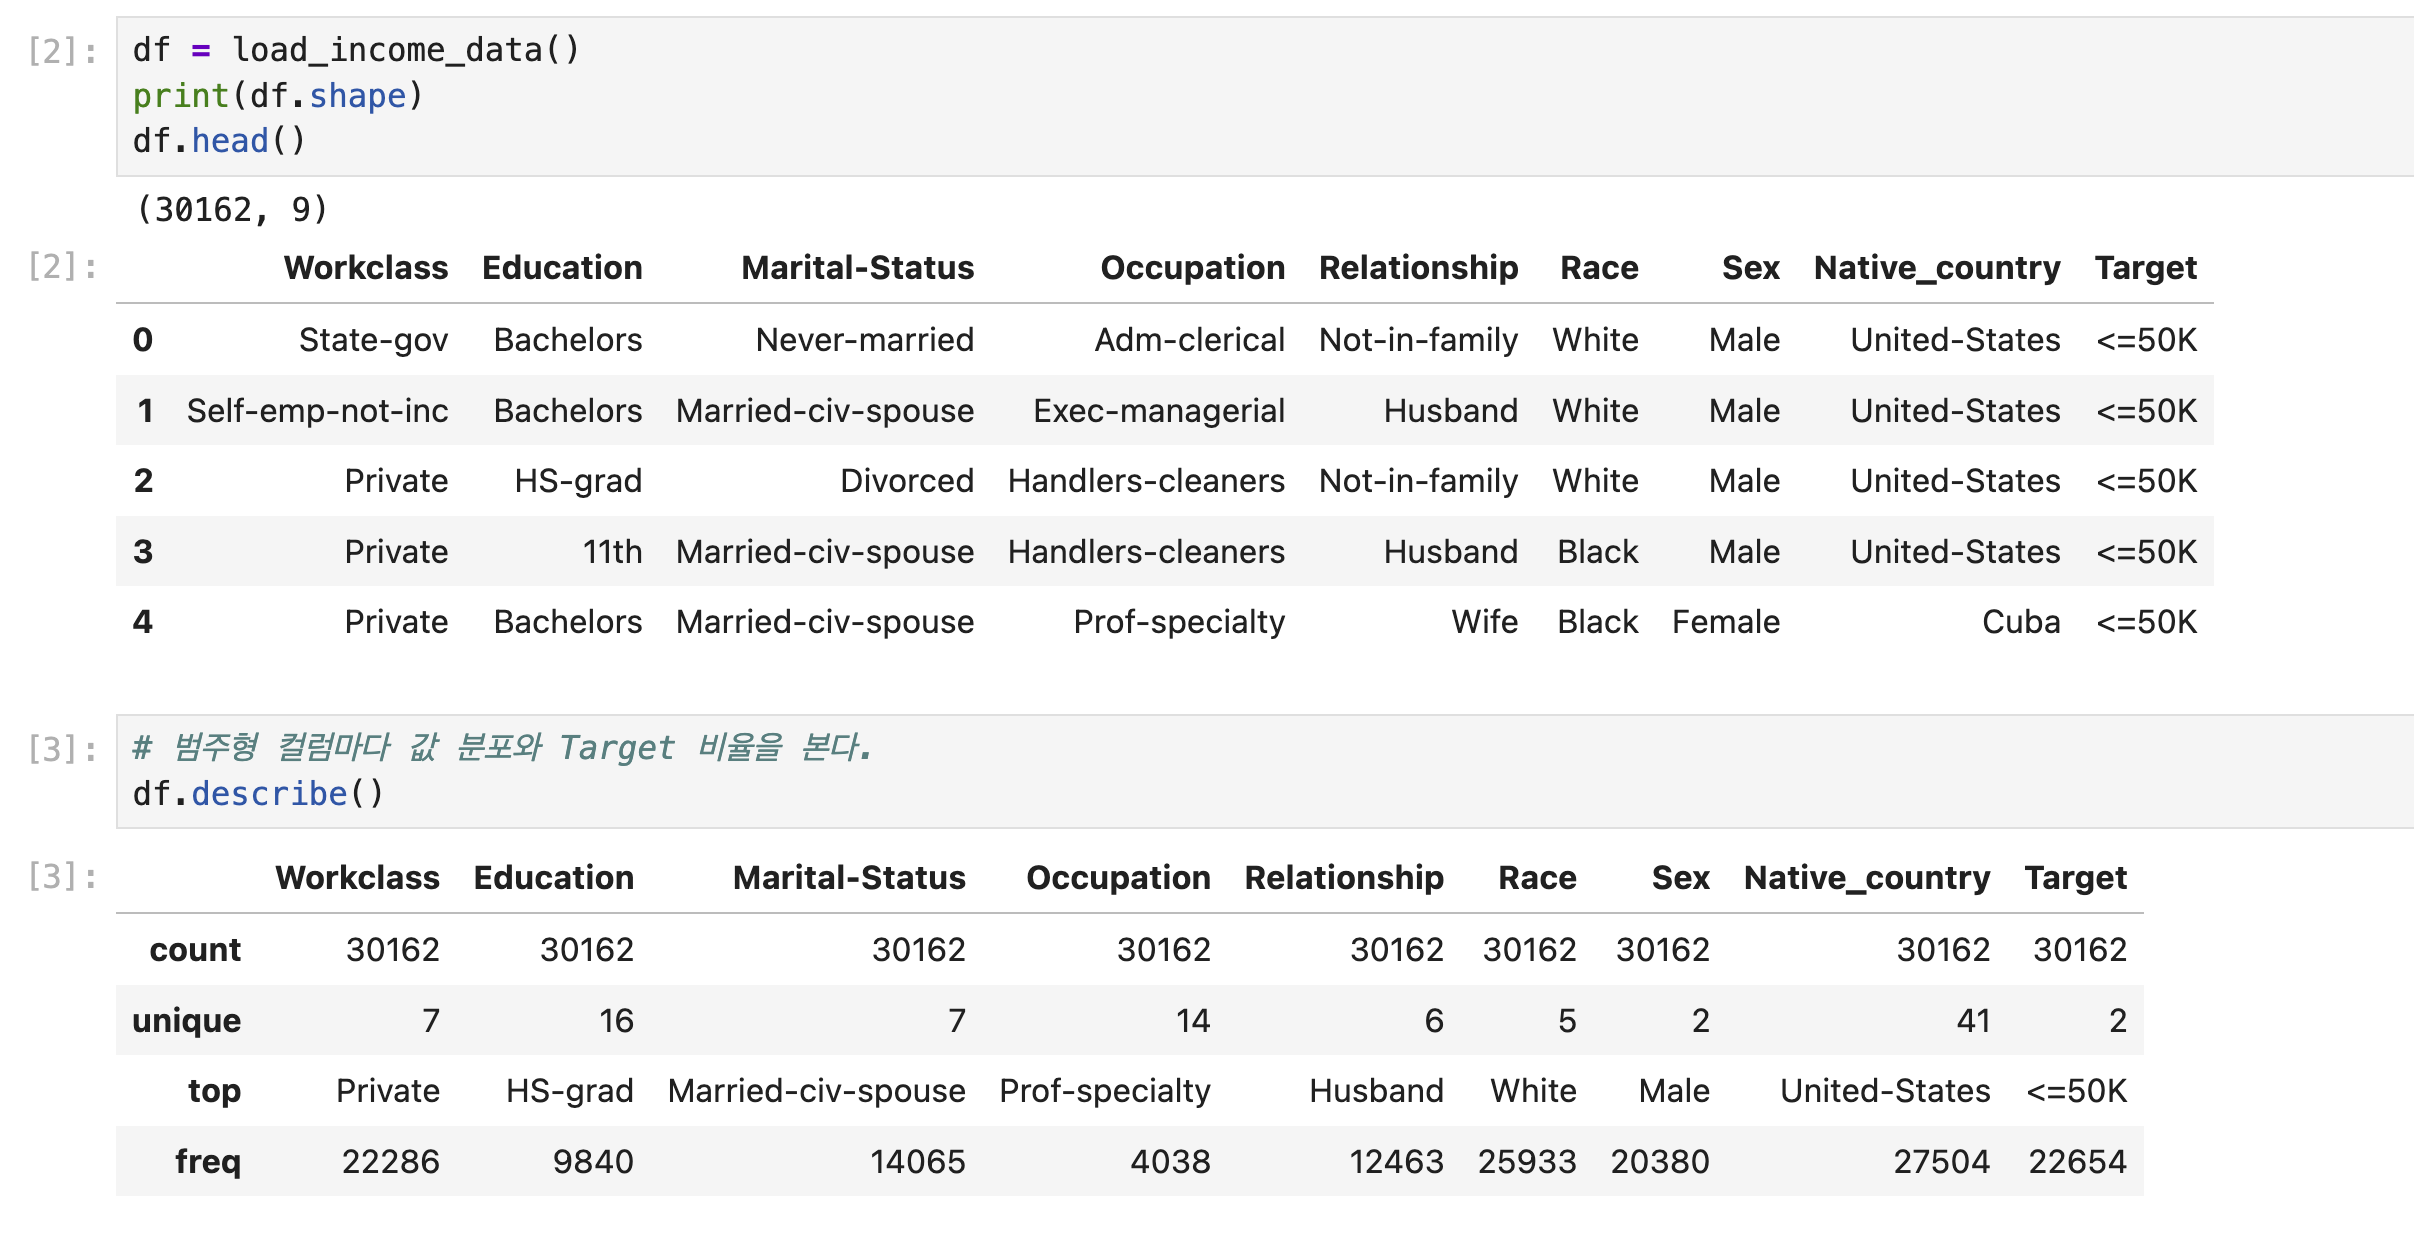
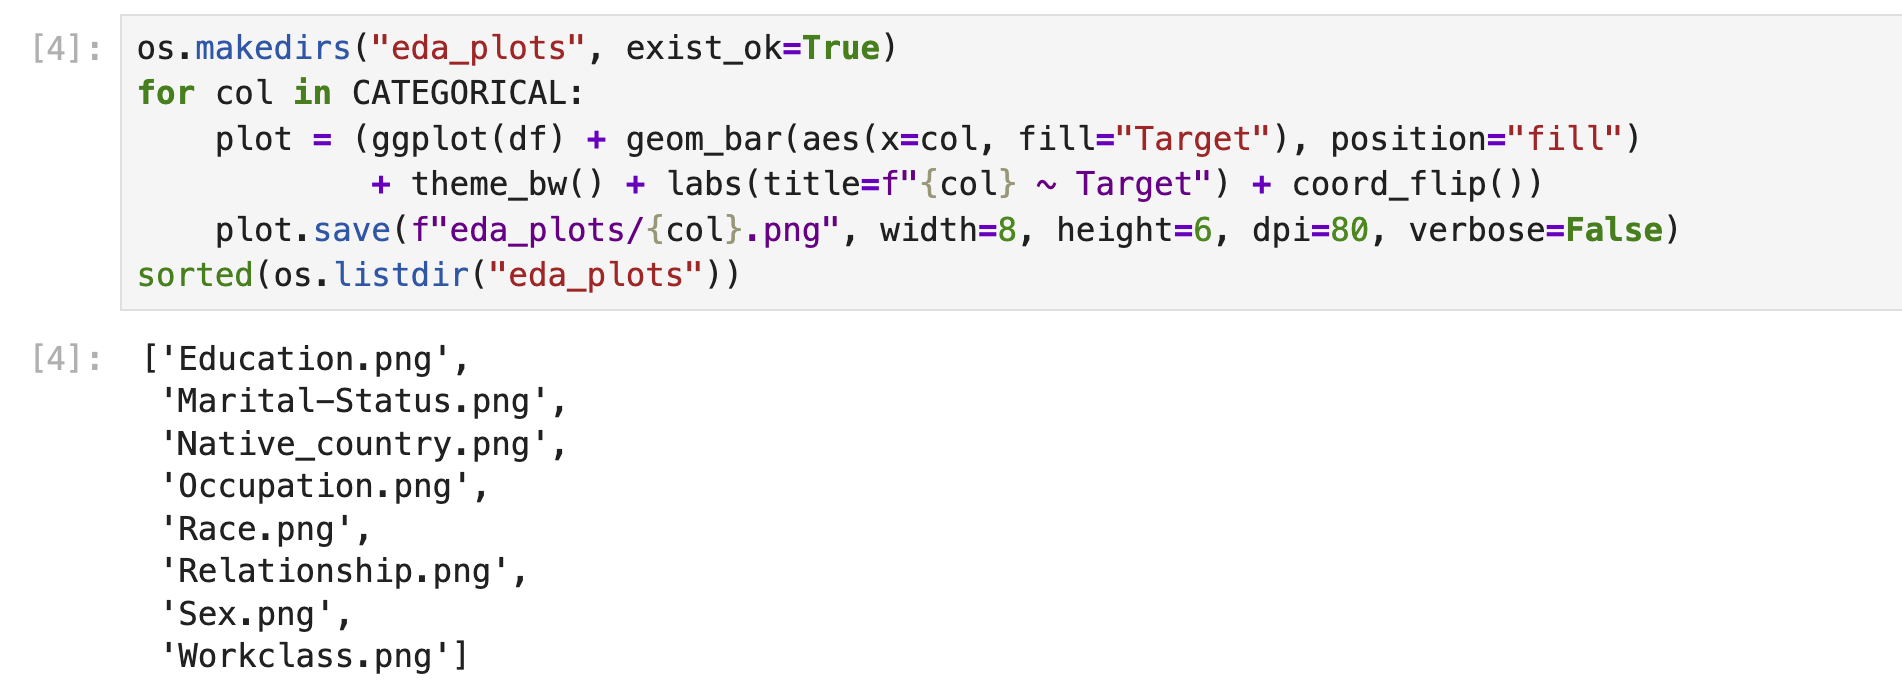
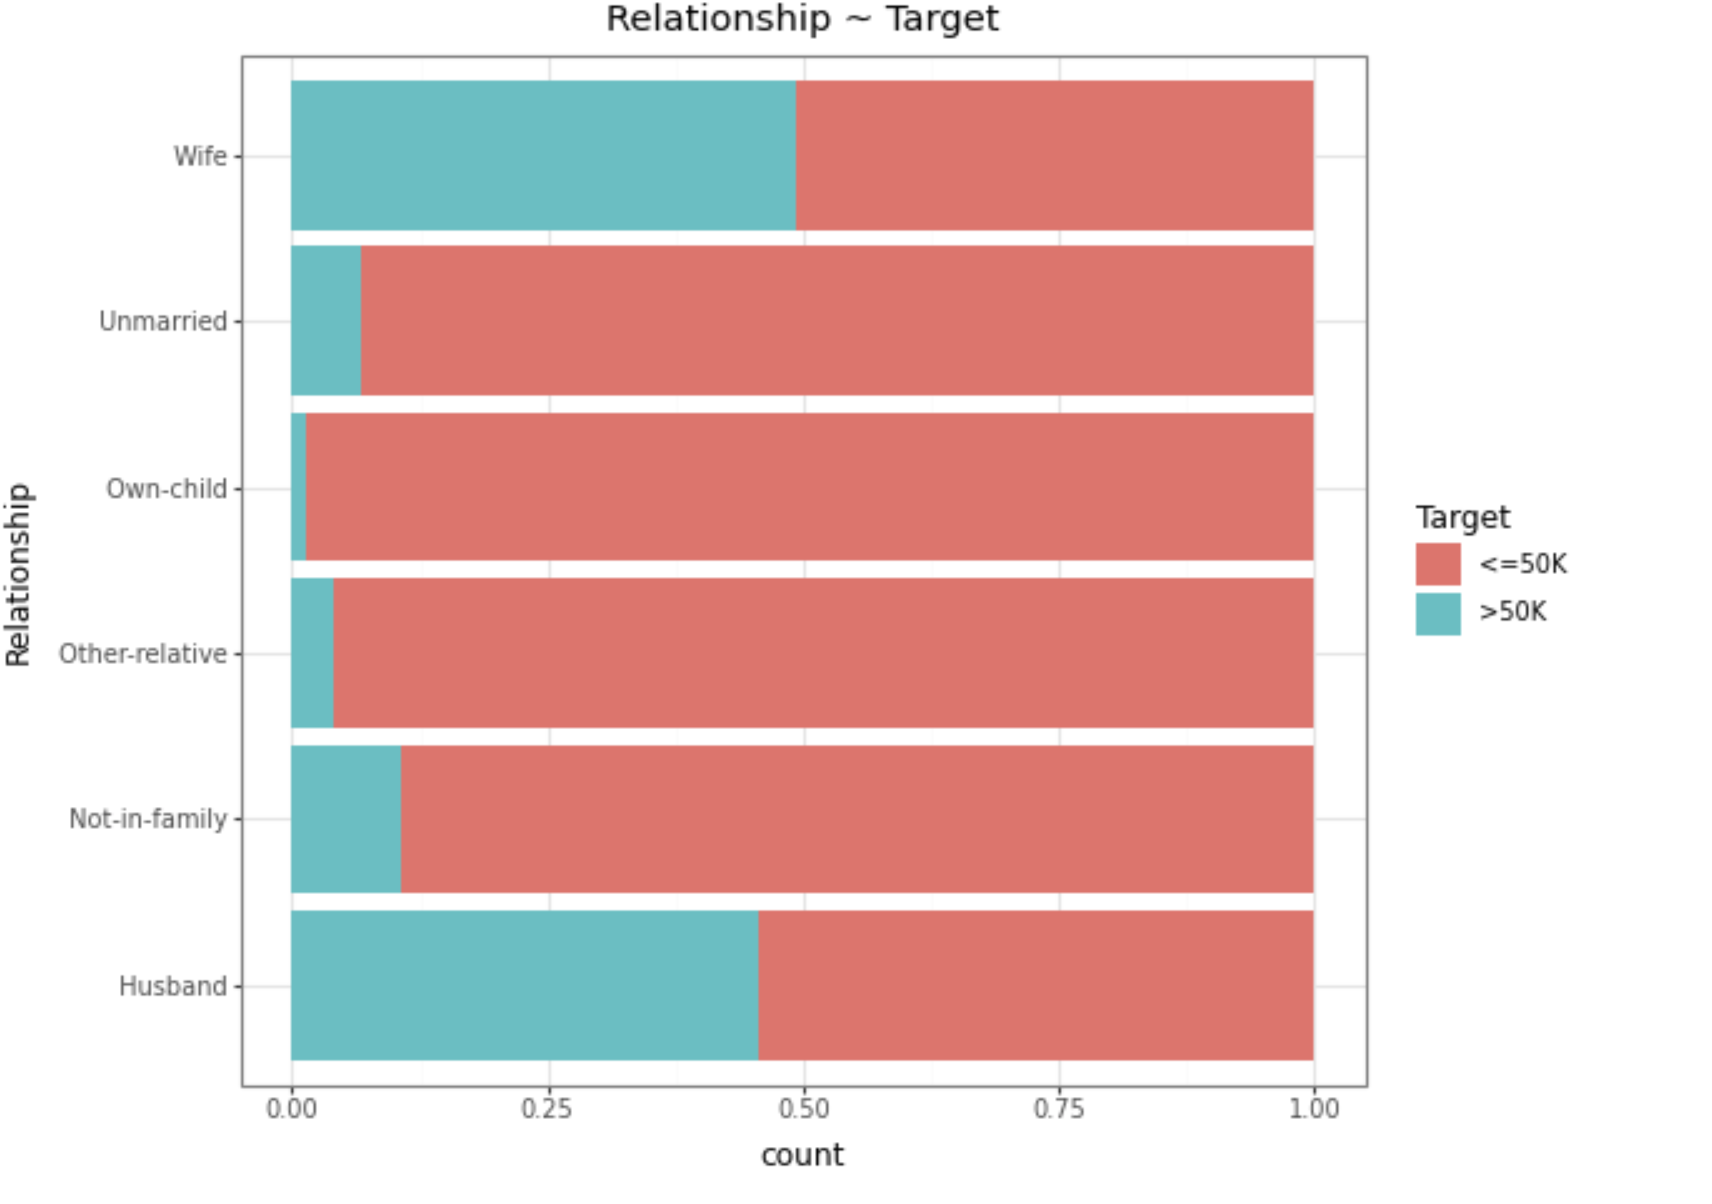
위 분석 데이터는 IDE에만 존재합니다. 따라서 IDE를 재부팅하거나 알 수 없는 이유로 오류가 발생하면 EDA 결과가 사라질 수 있습니다.
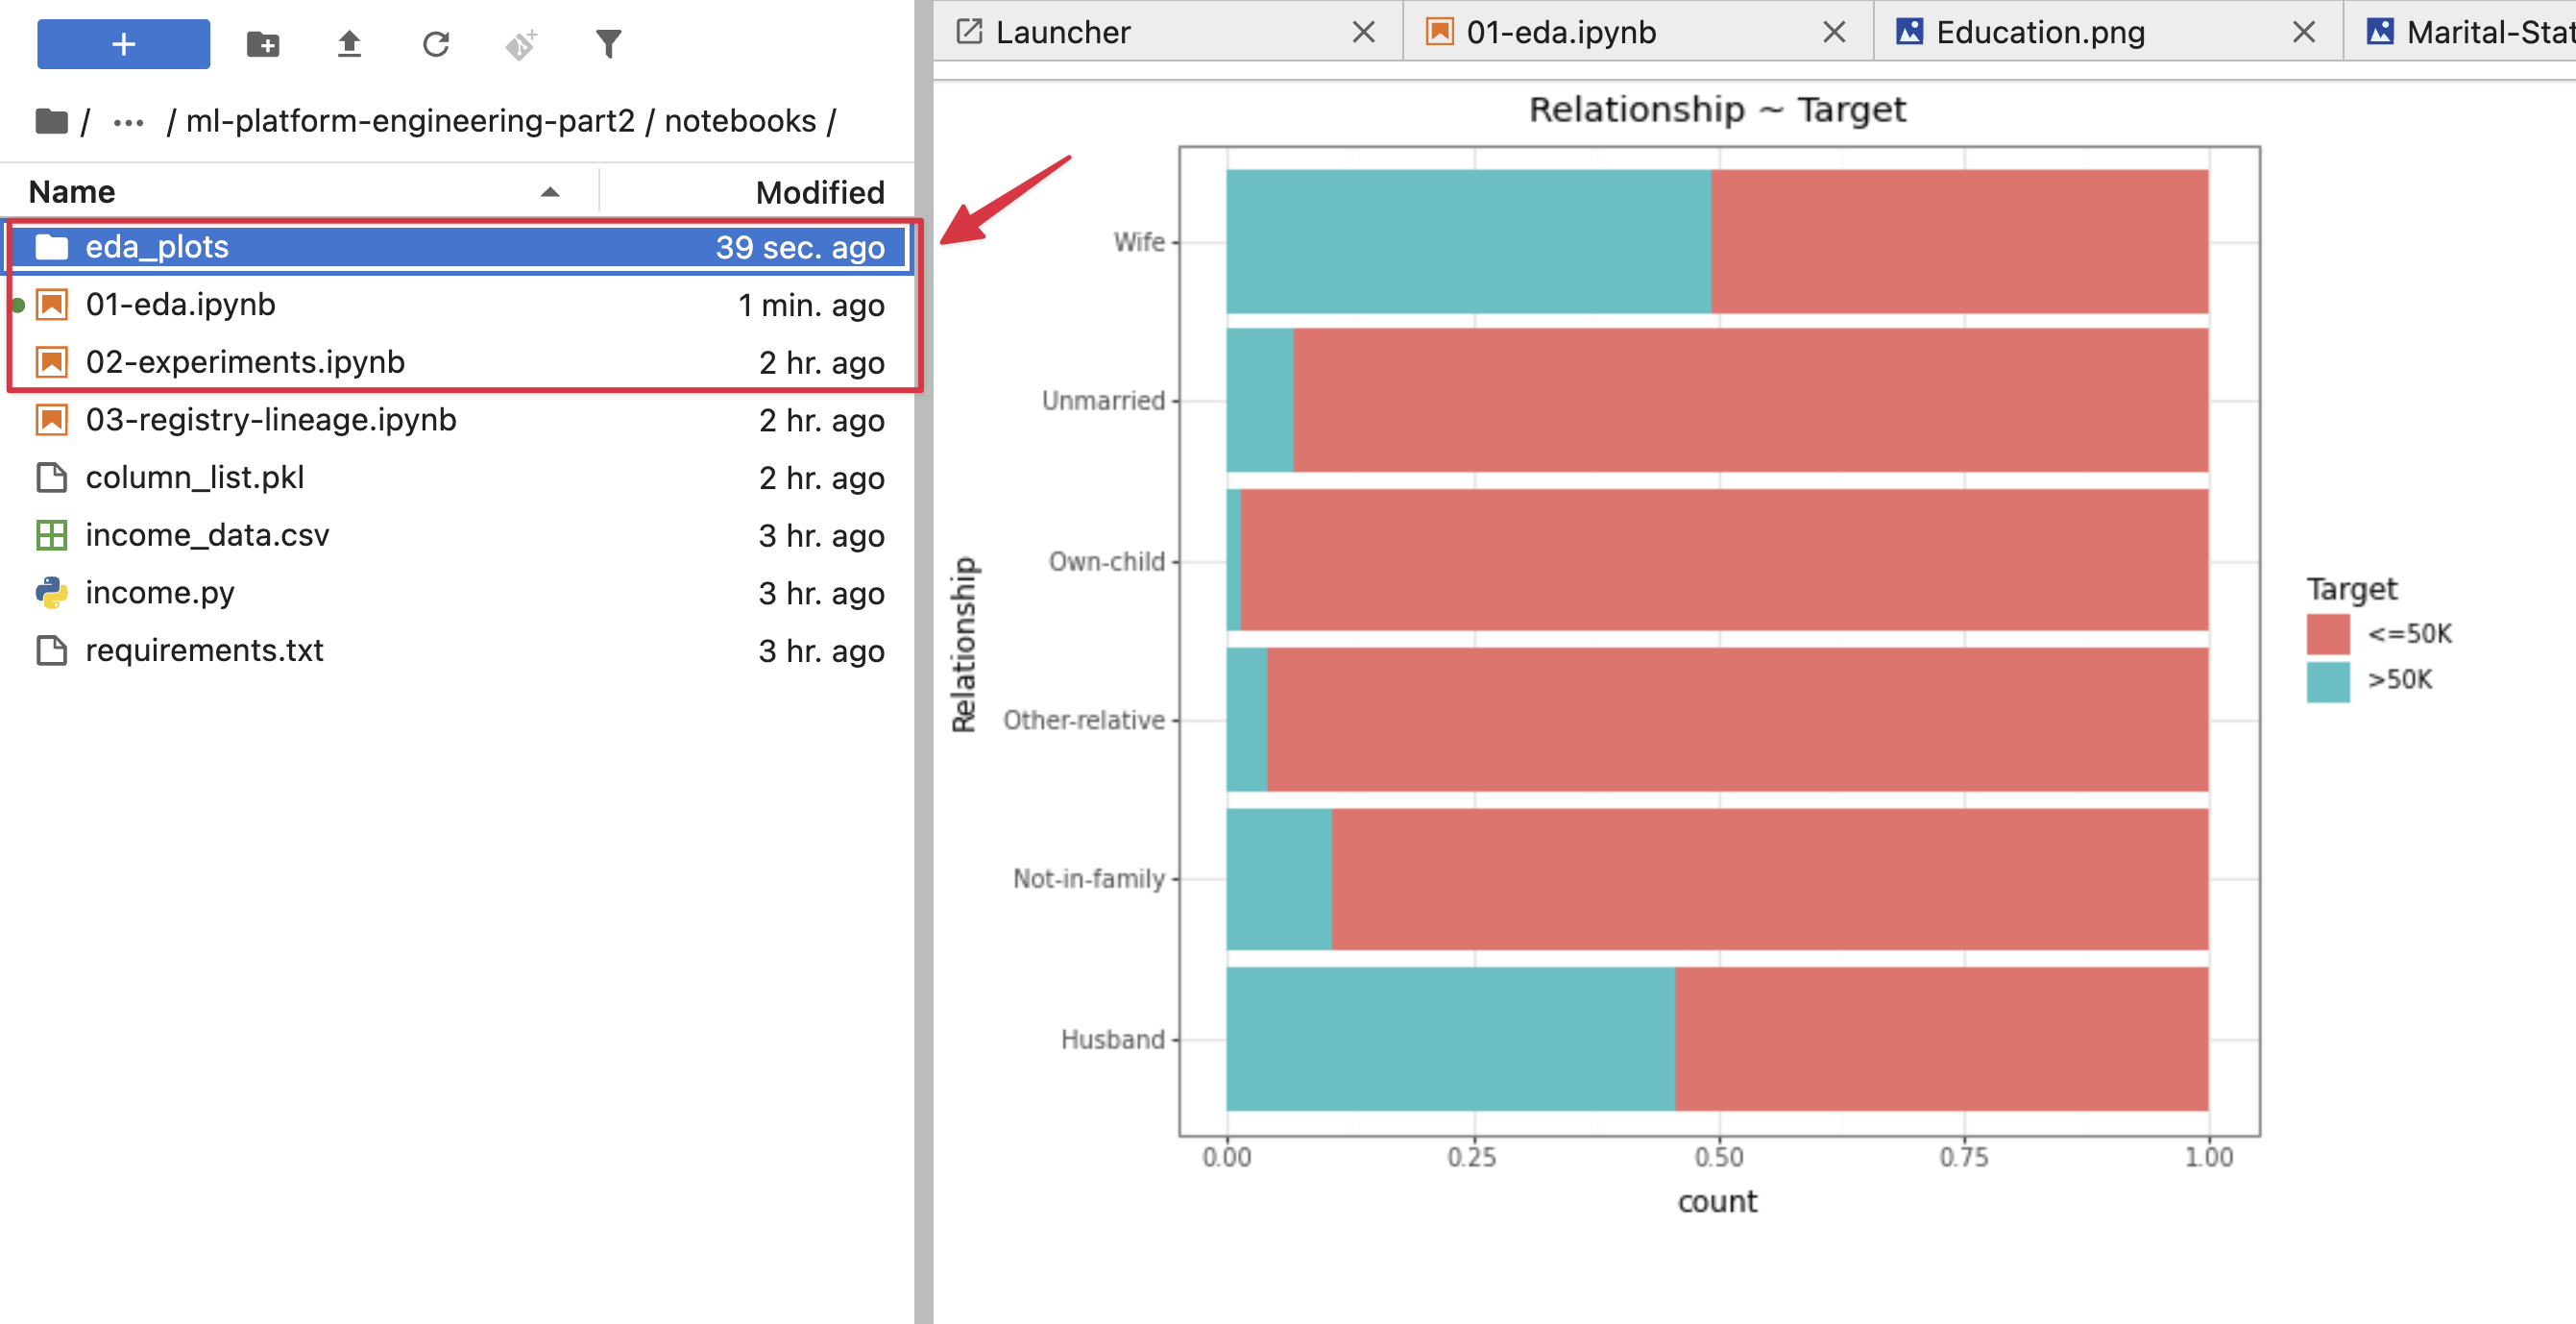
예제: MLflow
EDA 데이터는 MLflow run으로 MLflow에 저장할 수 있습니다.
mlflow.set_experiment("income-classifier")

with mlflow.start_run(run_name="eda") as run:
    raw_uri = upload_df(df, "mlflow-datasets", "income-classifier/raw/income_data.csv")
    mlflow.log_input(mlflow.data.from_pandas(df, source=raw_uri, name="income_data"), context="raw")
    mlflow.log_param("rows", len(df))
    mlflow.log_artifacts("eda_plots", artifact_path="eda_plots")

print("run_id :", run.info.run_id)
print("raw    :", raw_uri)
print("artifacts:", [a.path for a in mlflow.MlflowClient().list_artifacts(run.info.run_id, "eda_plots")])
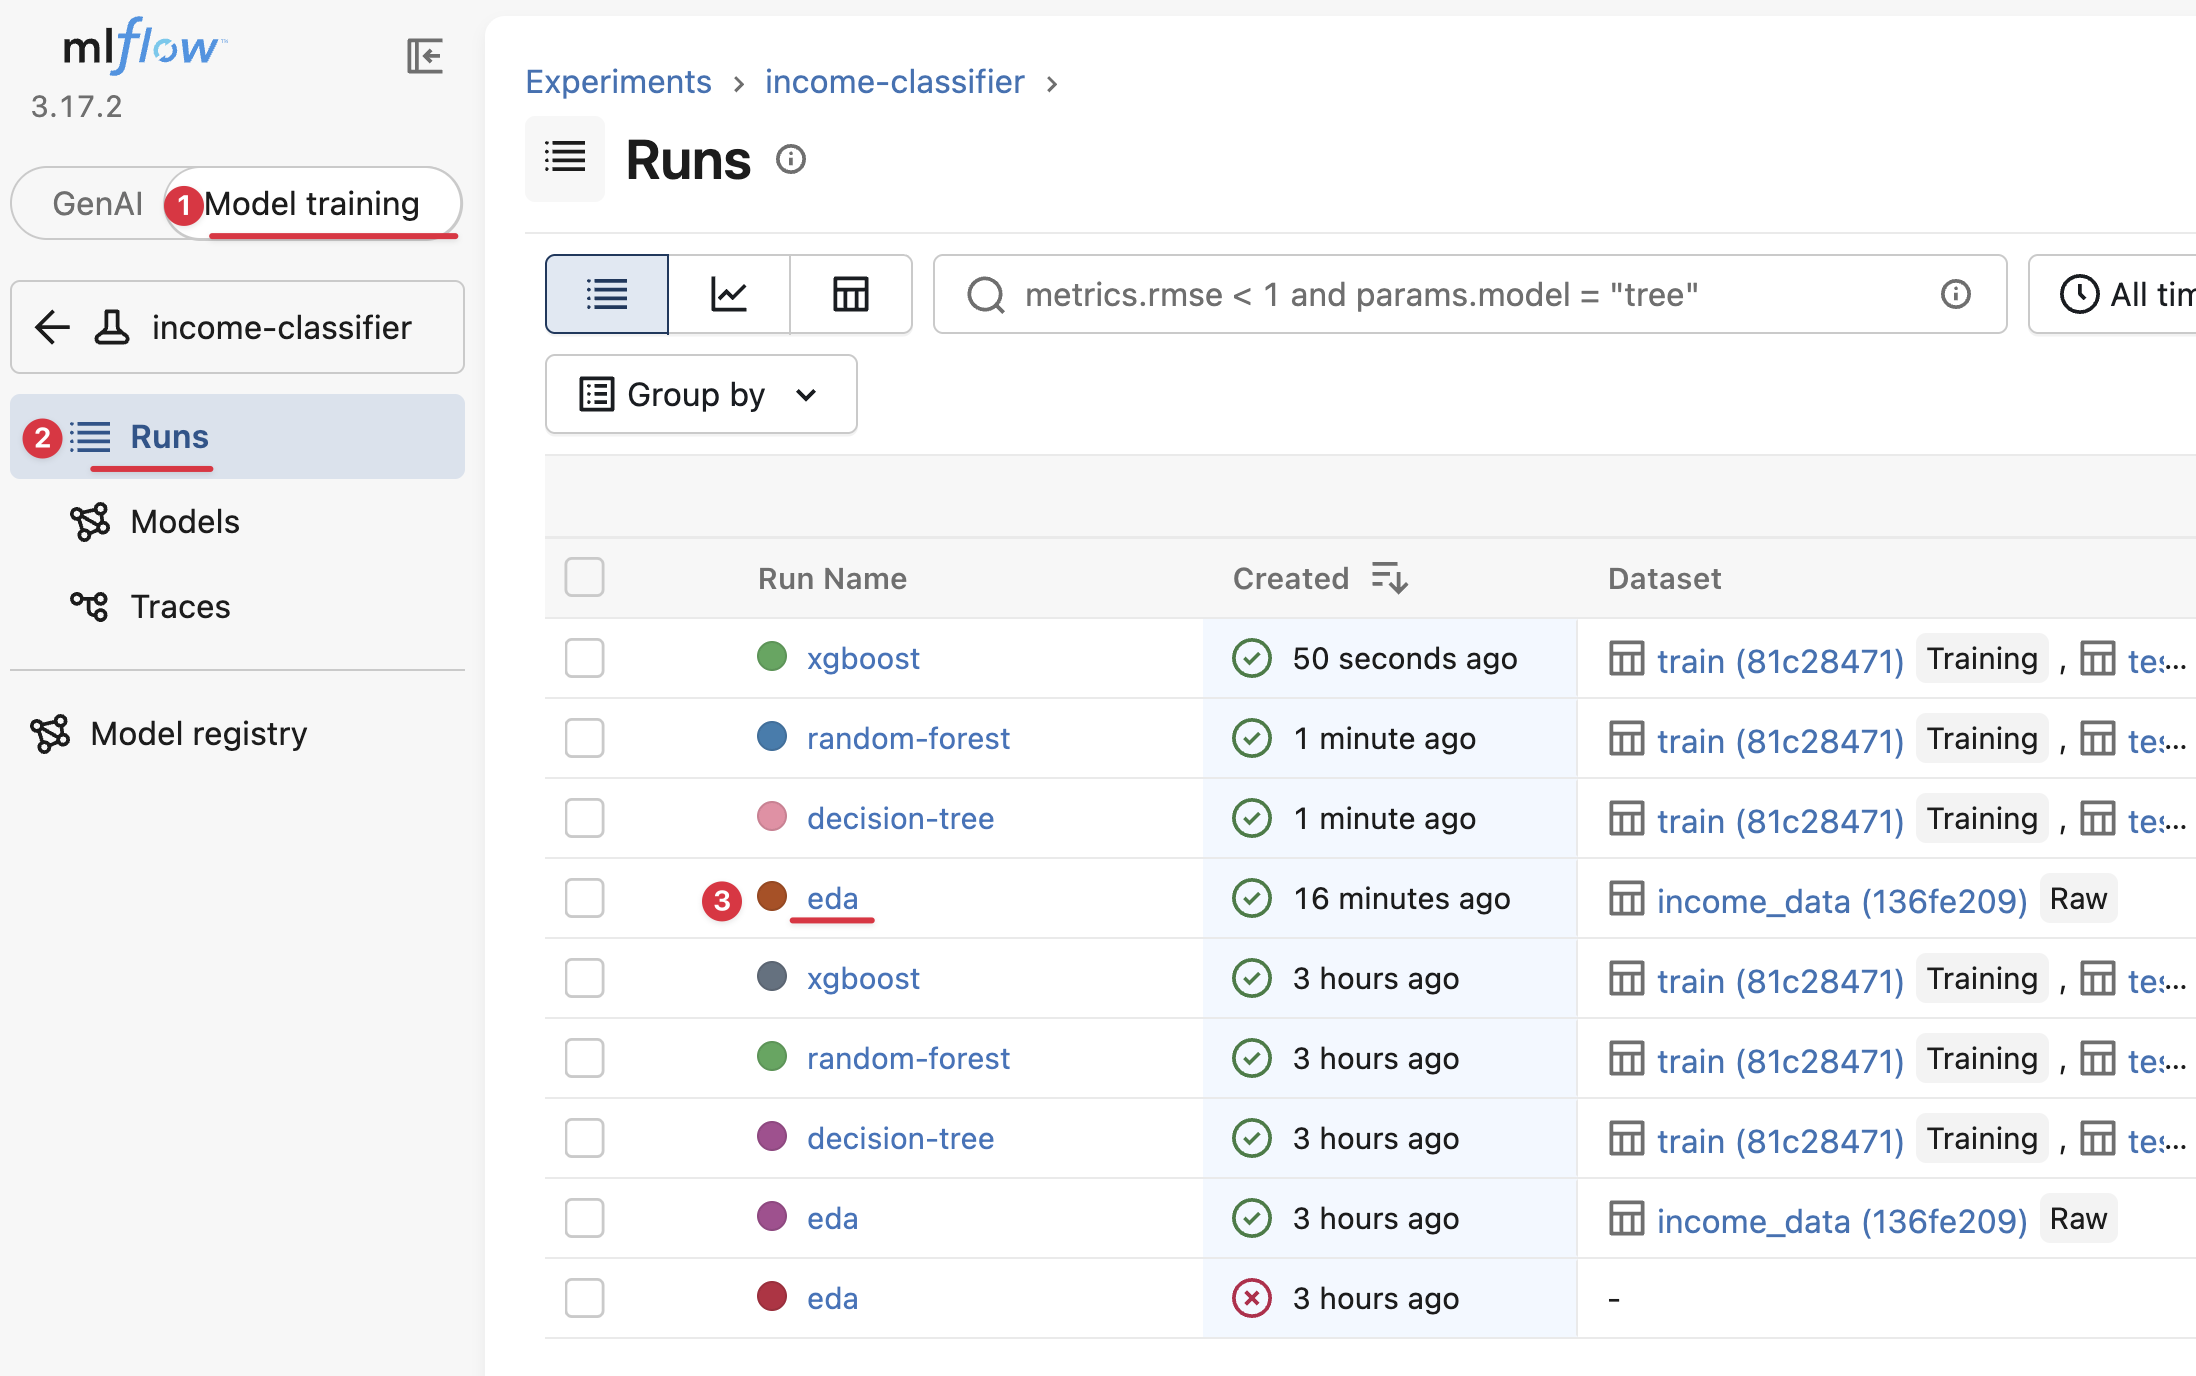
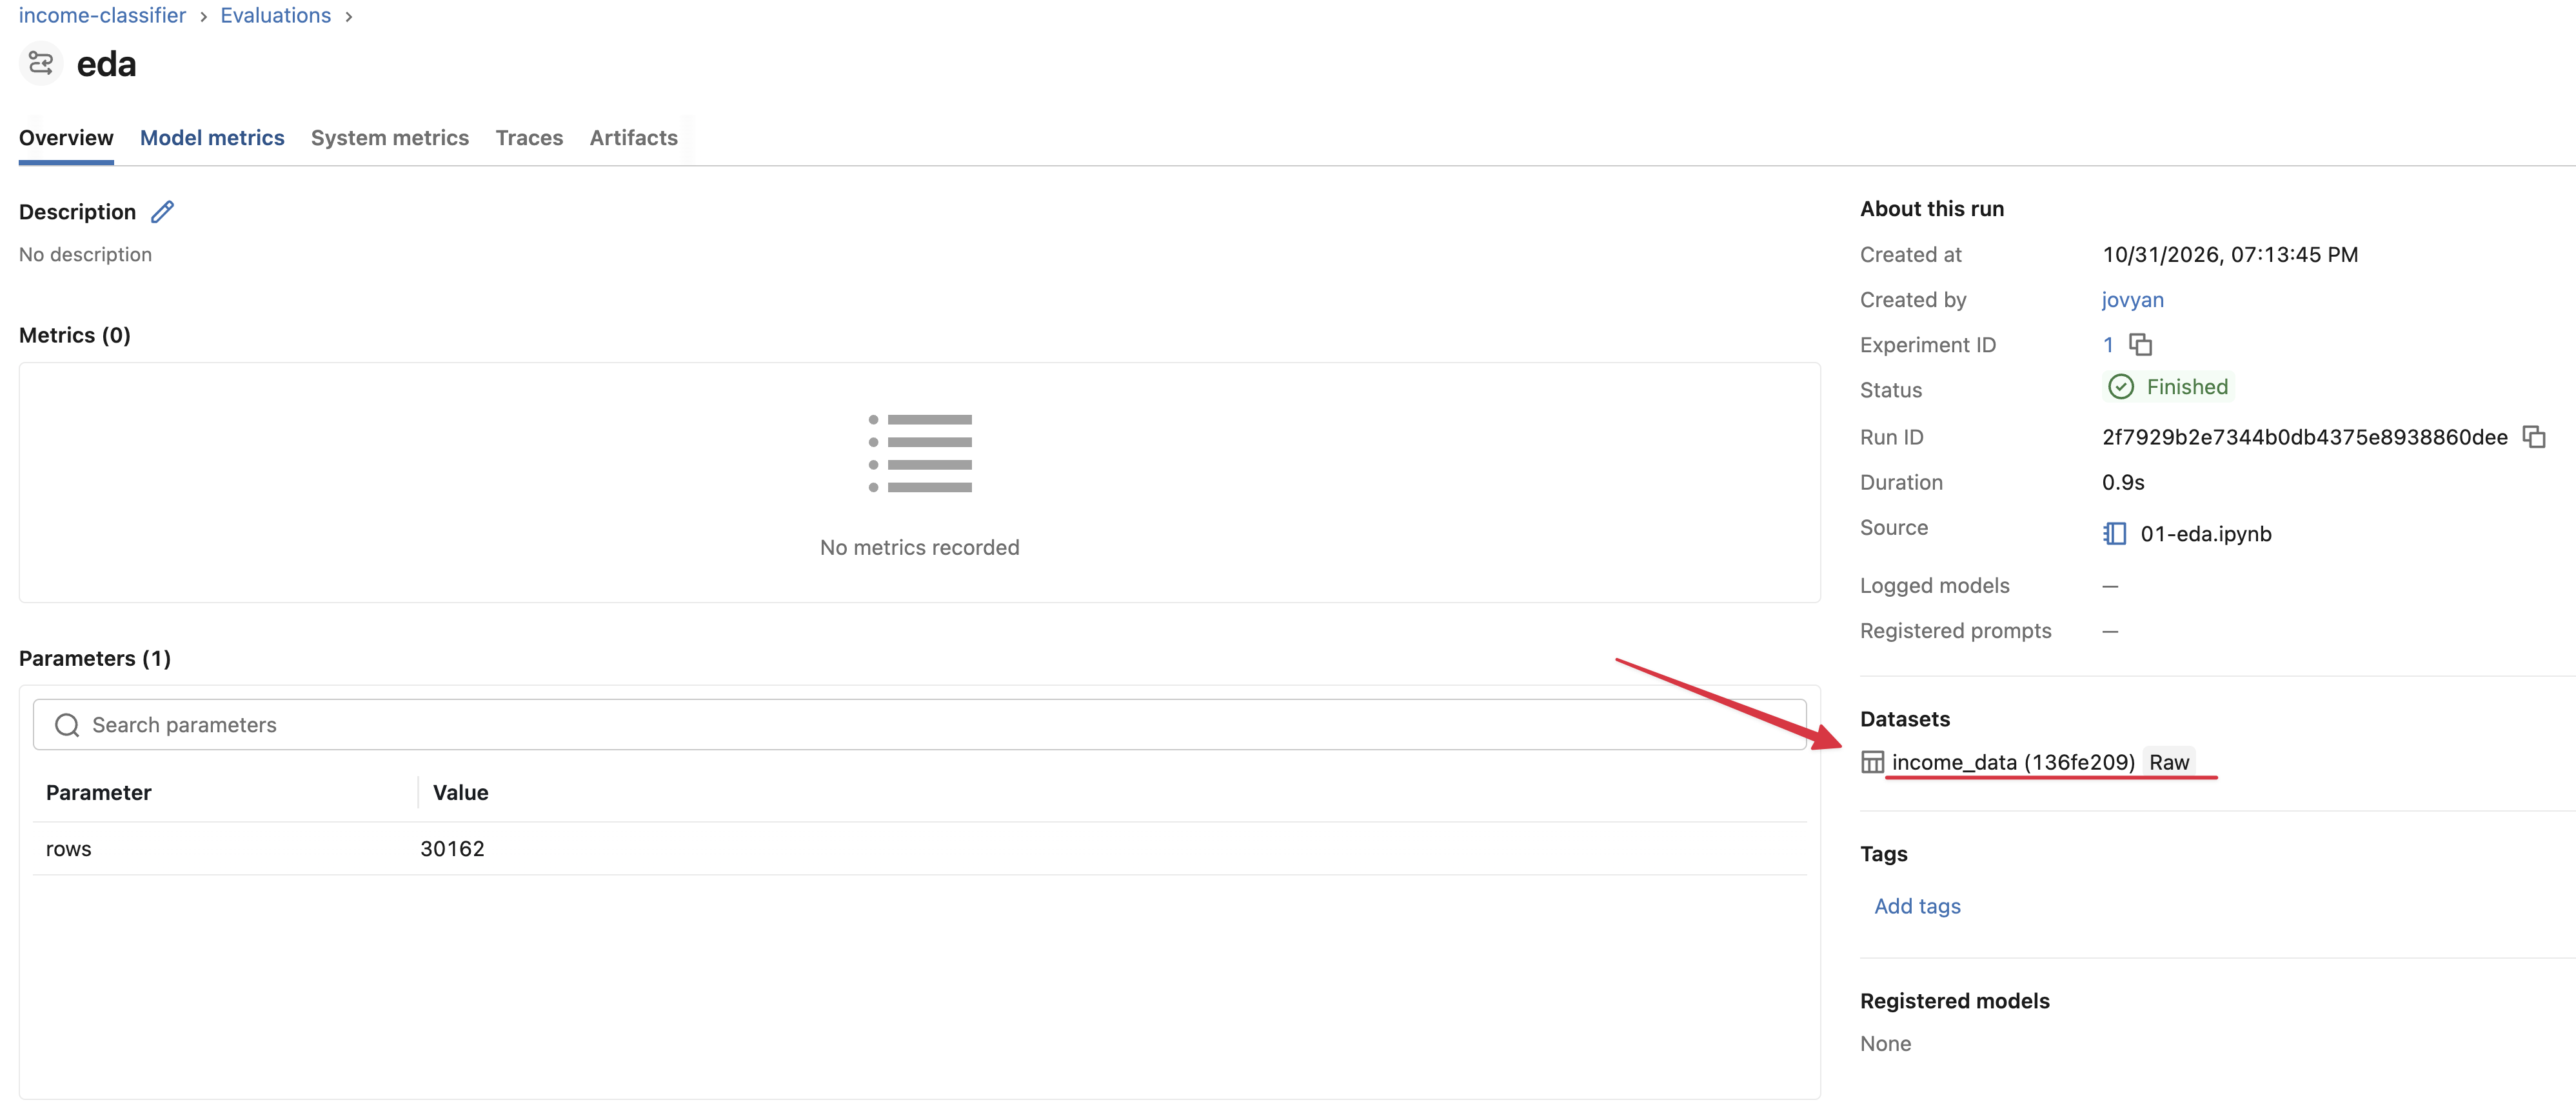
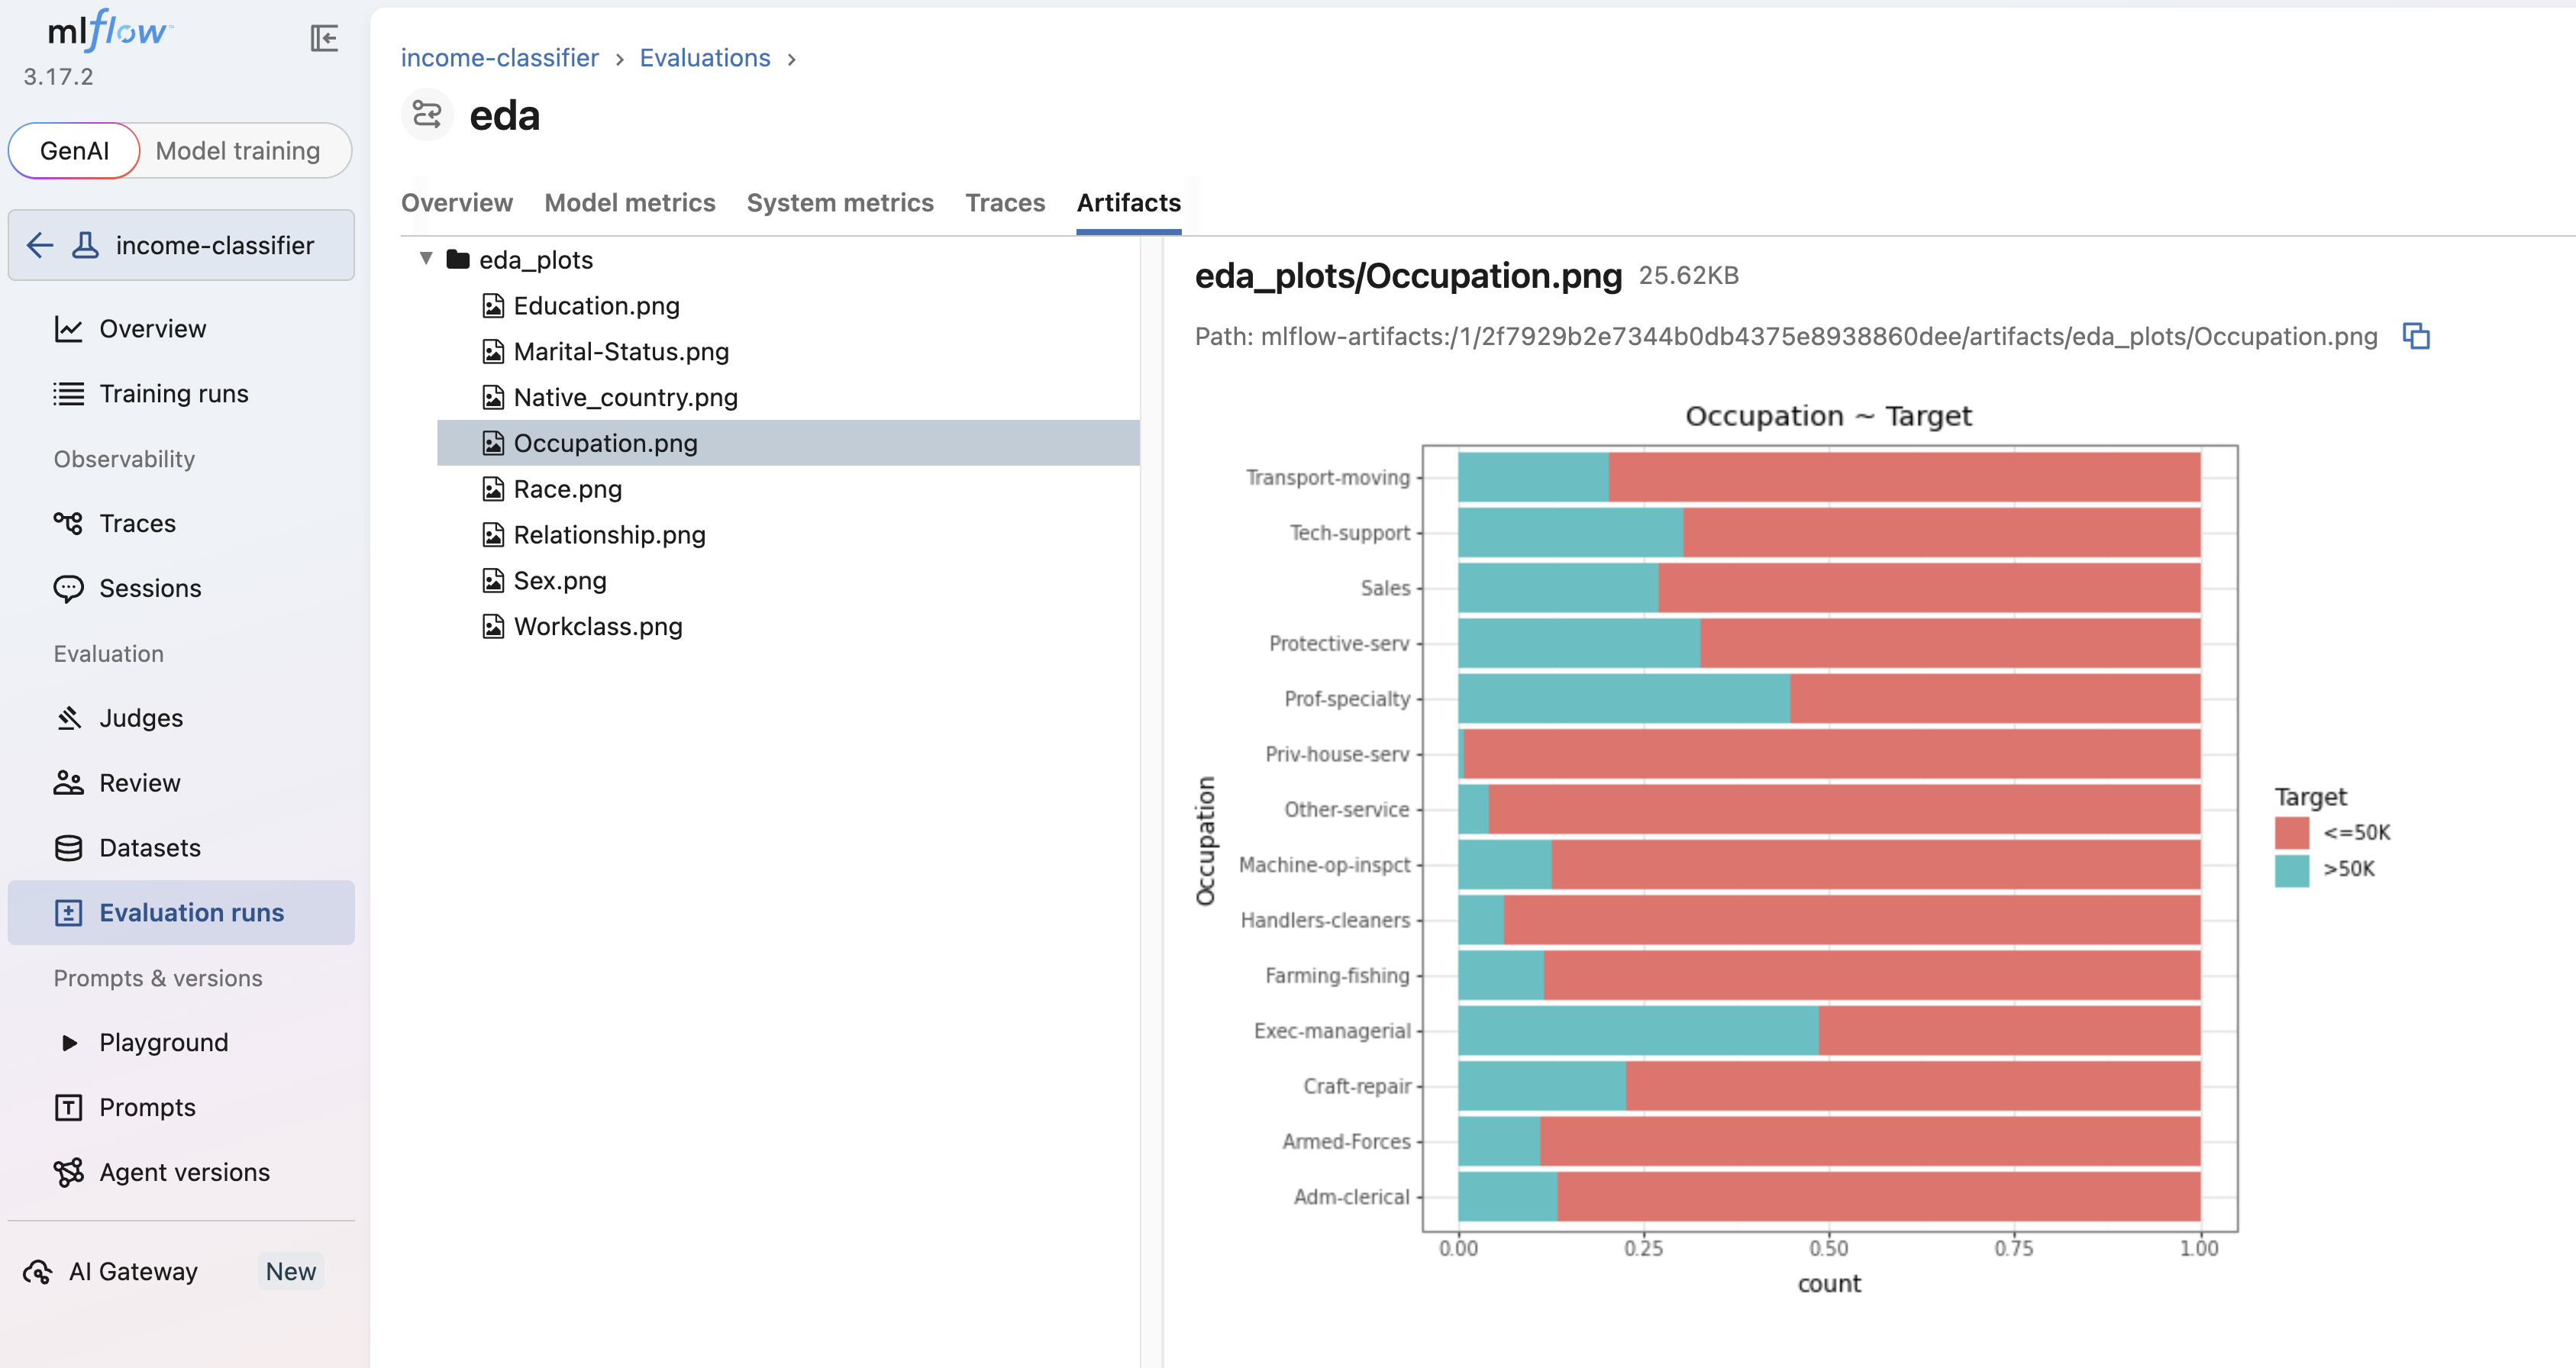
MLflow에 접속하면 Experiments 메뉴에서 IDE가 전송한 EDA 자료를 볼 수 있습니다. 이 예제에서는 데이터셋과 PNG 파일을 MLflow에 저장했습니다.
ML 플랫폼 기능4 - 실험과 모델 저장
이론
EDA 과정이 끝나면 모델을 만들기 위해 여러 실험을 해야 하는데, ML 플랫폼은 실험할 수 있는 환경을 제공해야 합니다. IDE에서 데이터셋을 불러올 수 있도록 설정해야 하고, 실험에 사용한 기록(모델 파라미터 등)과 모델을 저장하는 기능 등을 제공해야 합니다.
예제
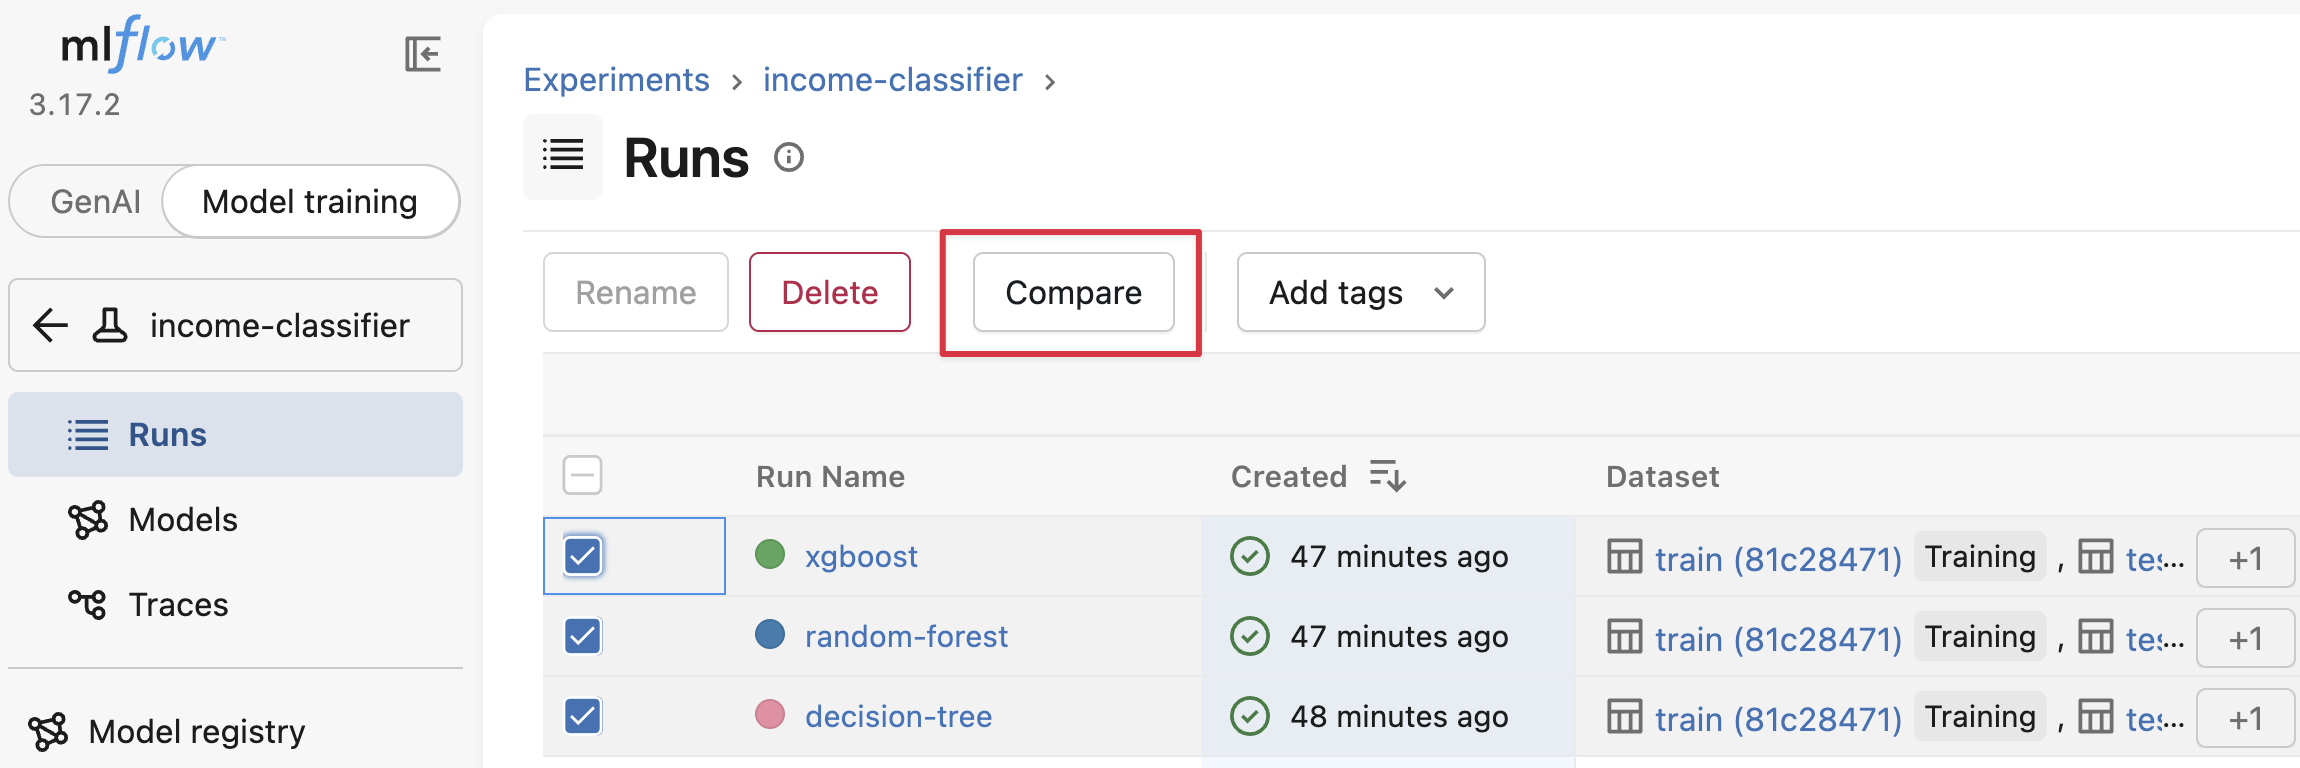
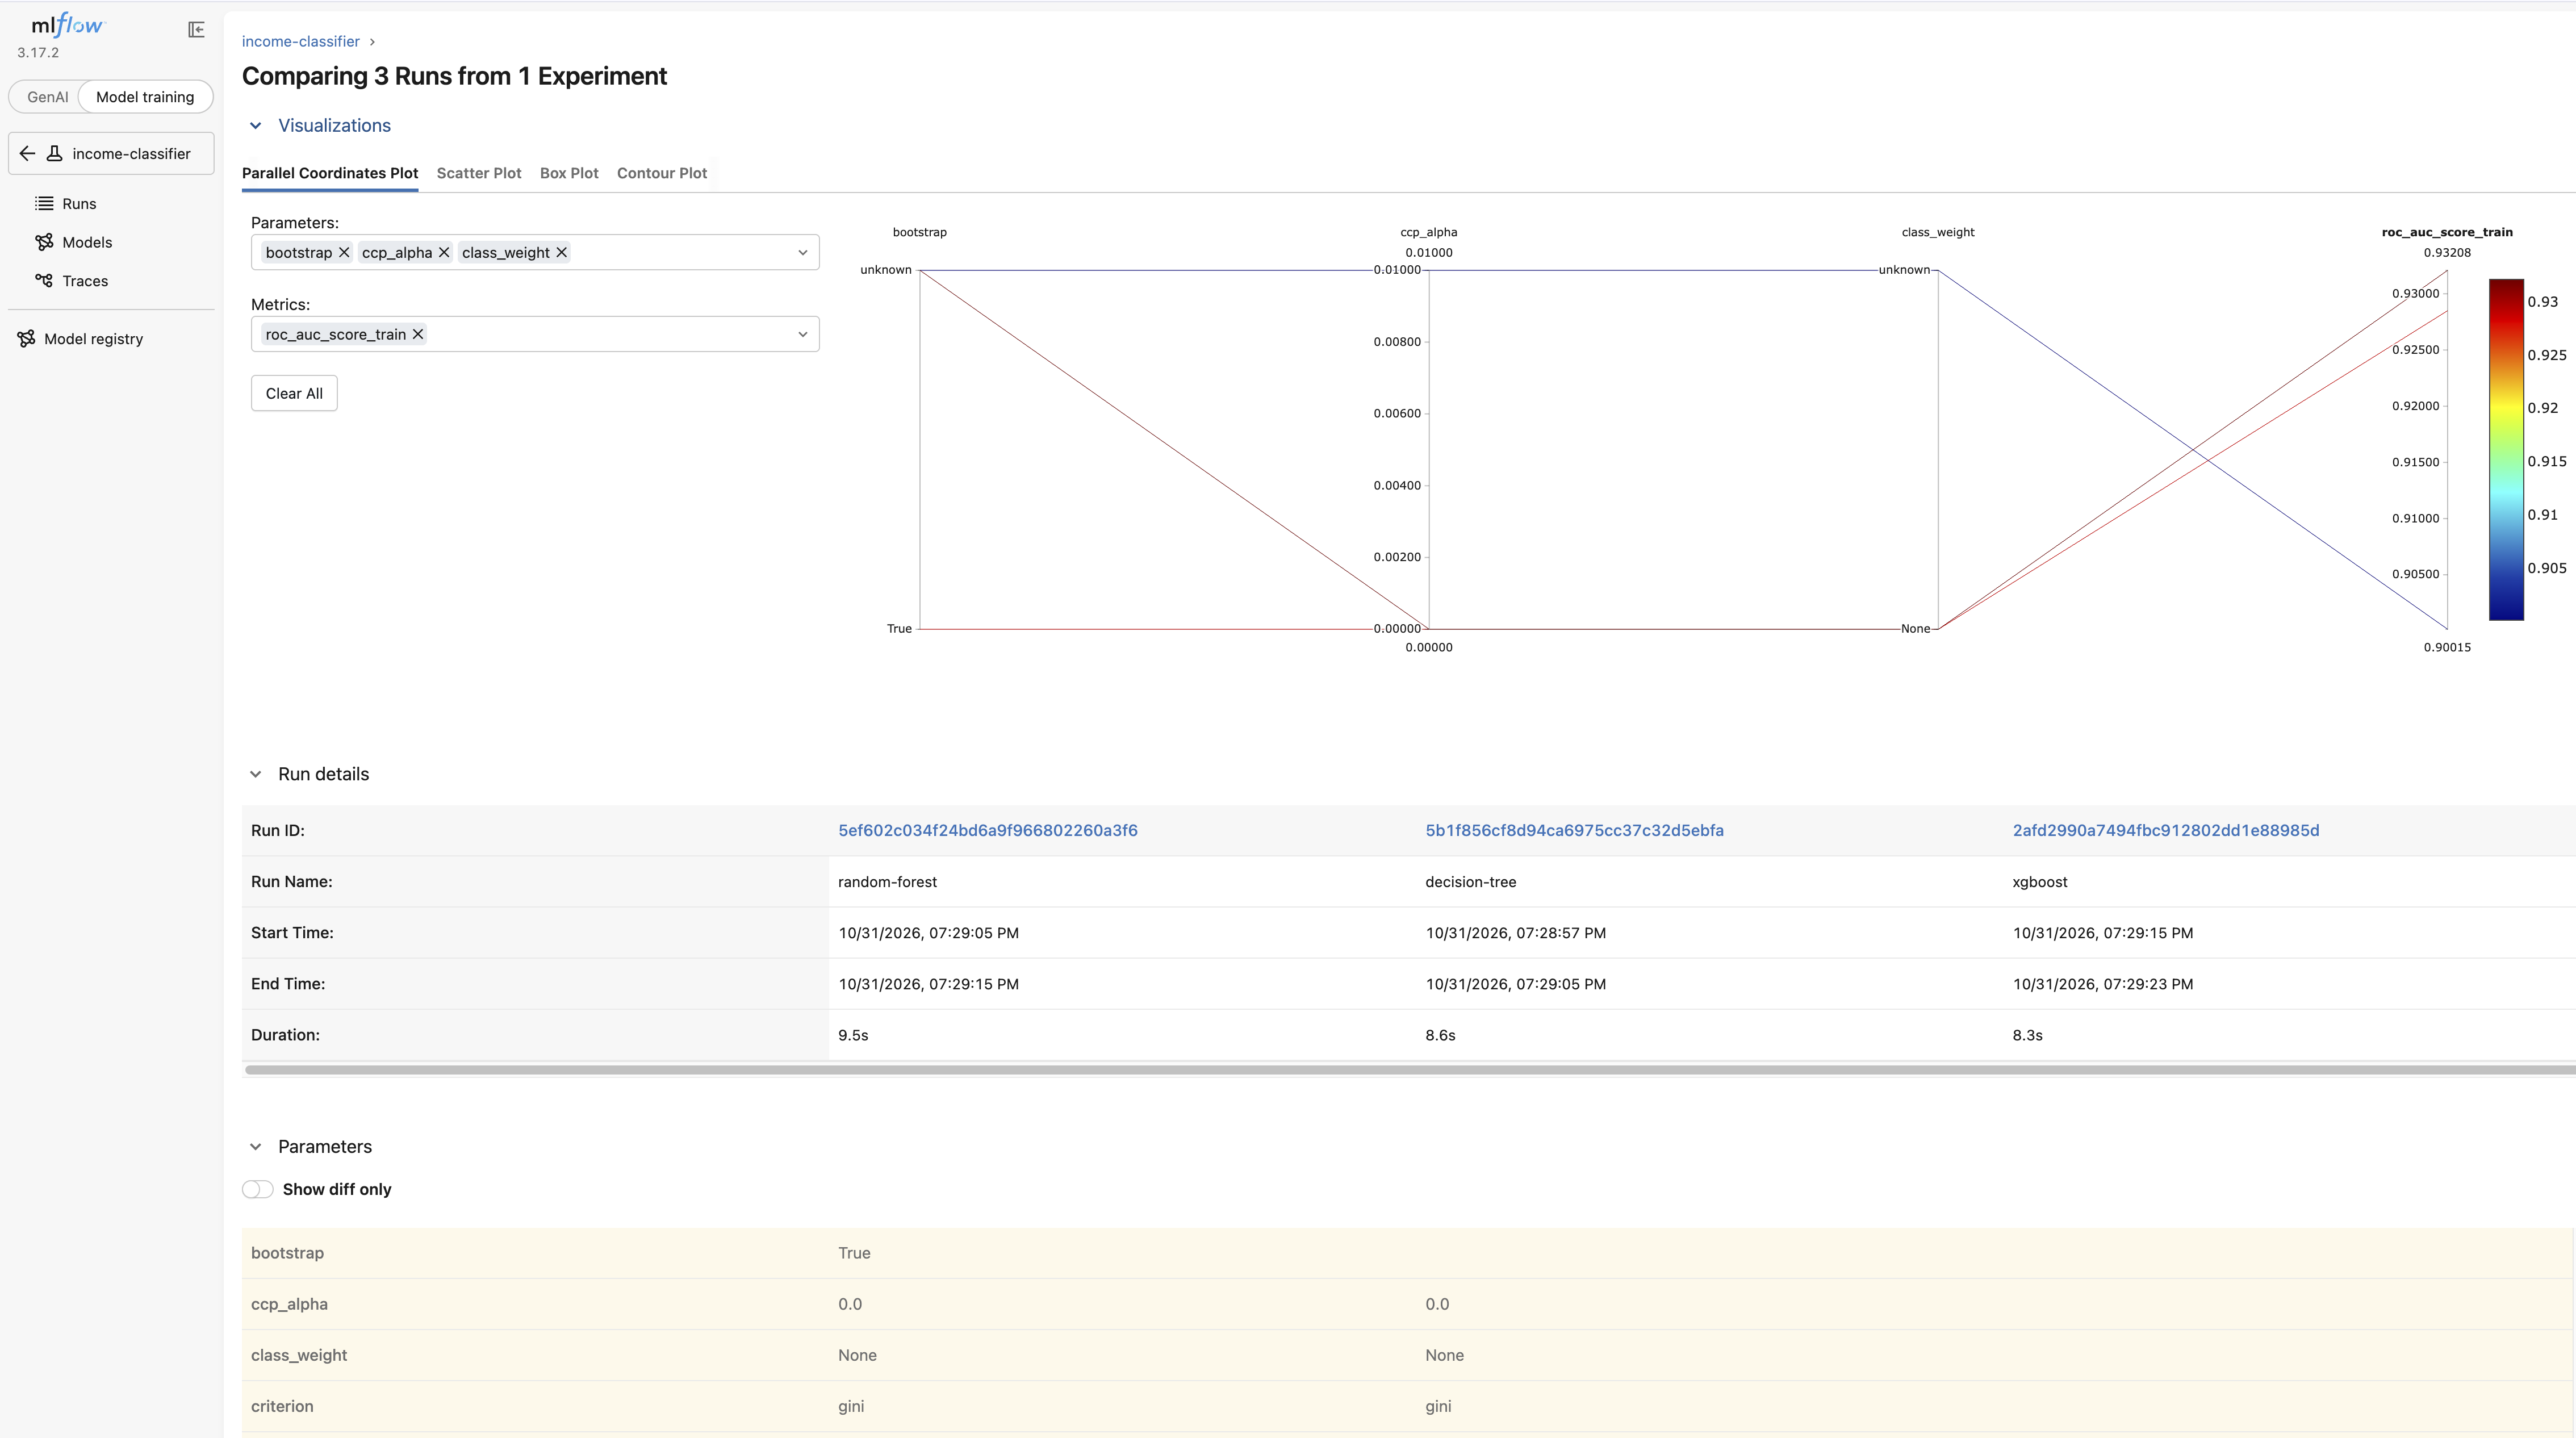
아래 예제는 EDA에서 본 컬럼으로 소득 구간(>50K)을 맞히는 모델 3개를 학습하고, MLflow로 비교해 가장 좋은 모델을 고르는 과정입니다. 모델은 Decision Tree, Random Forest, XGBoost를 사용합니다.
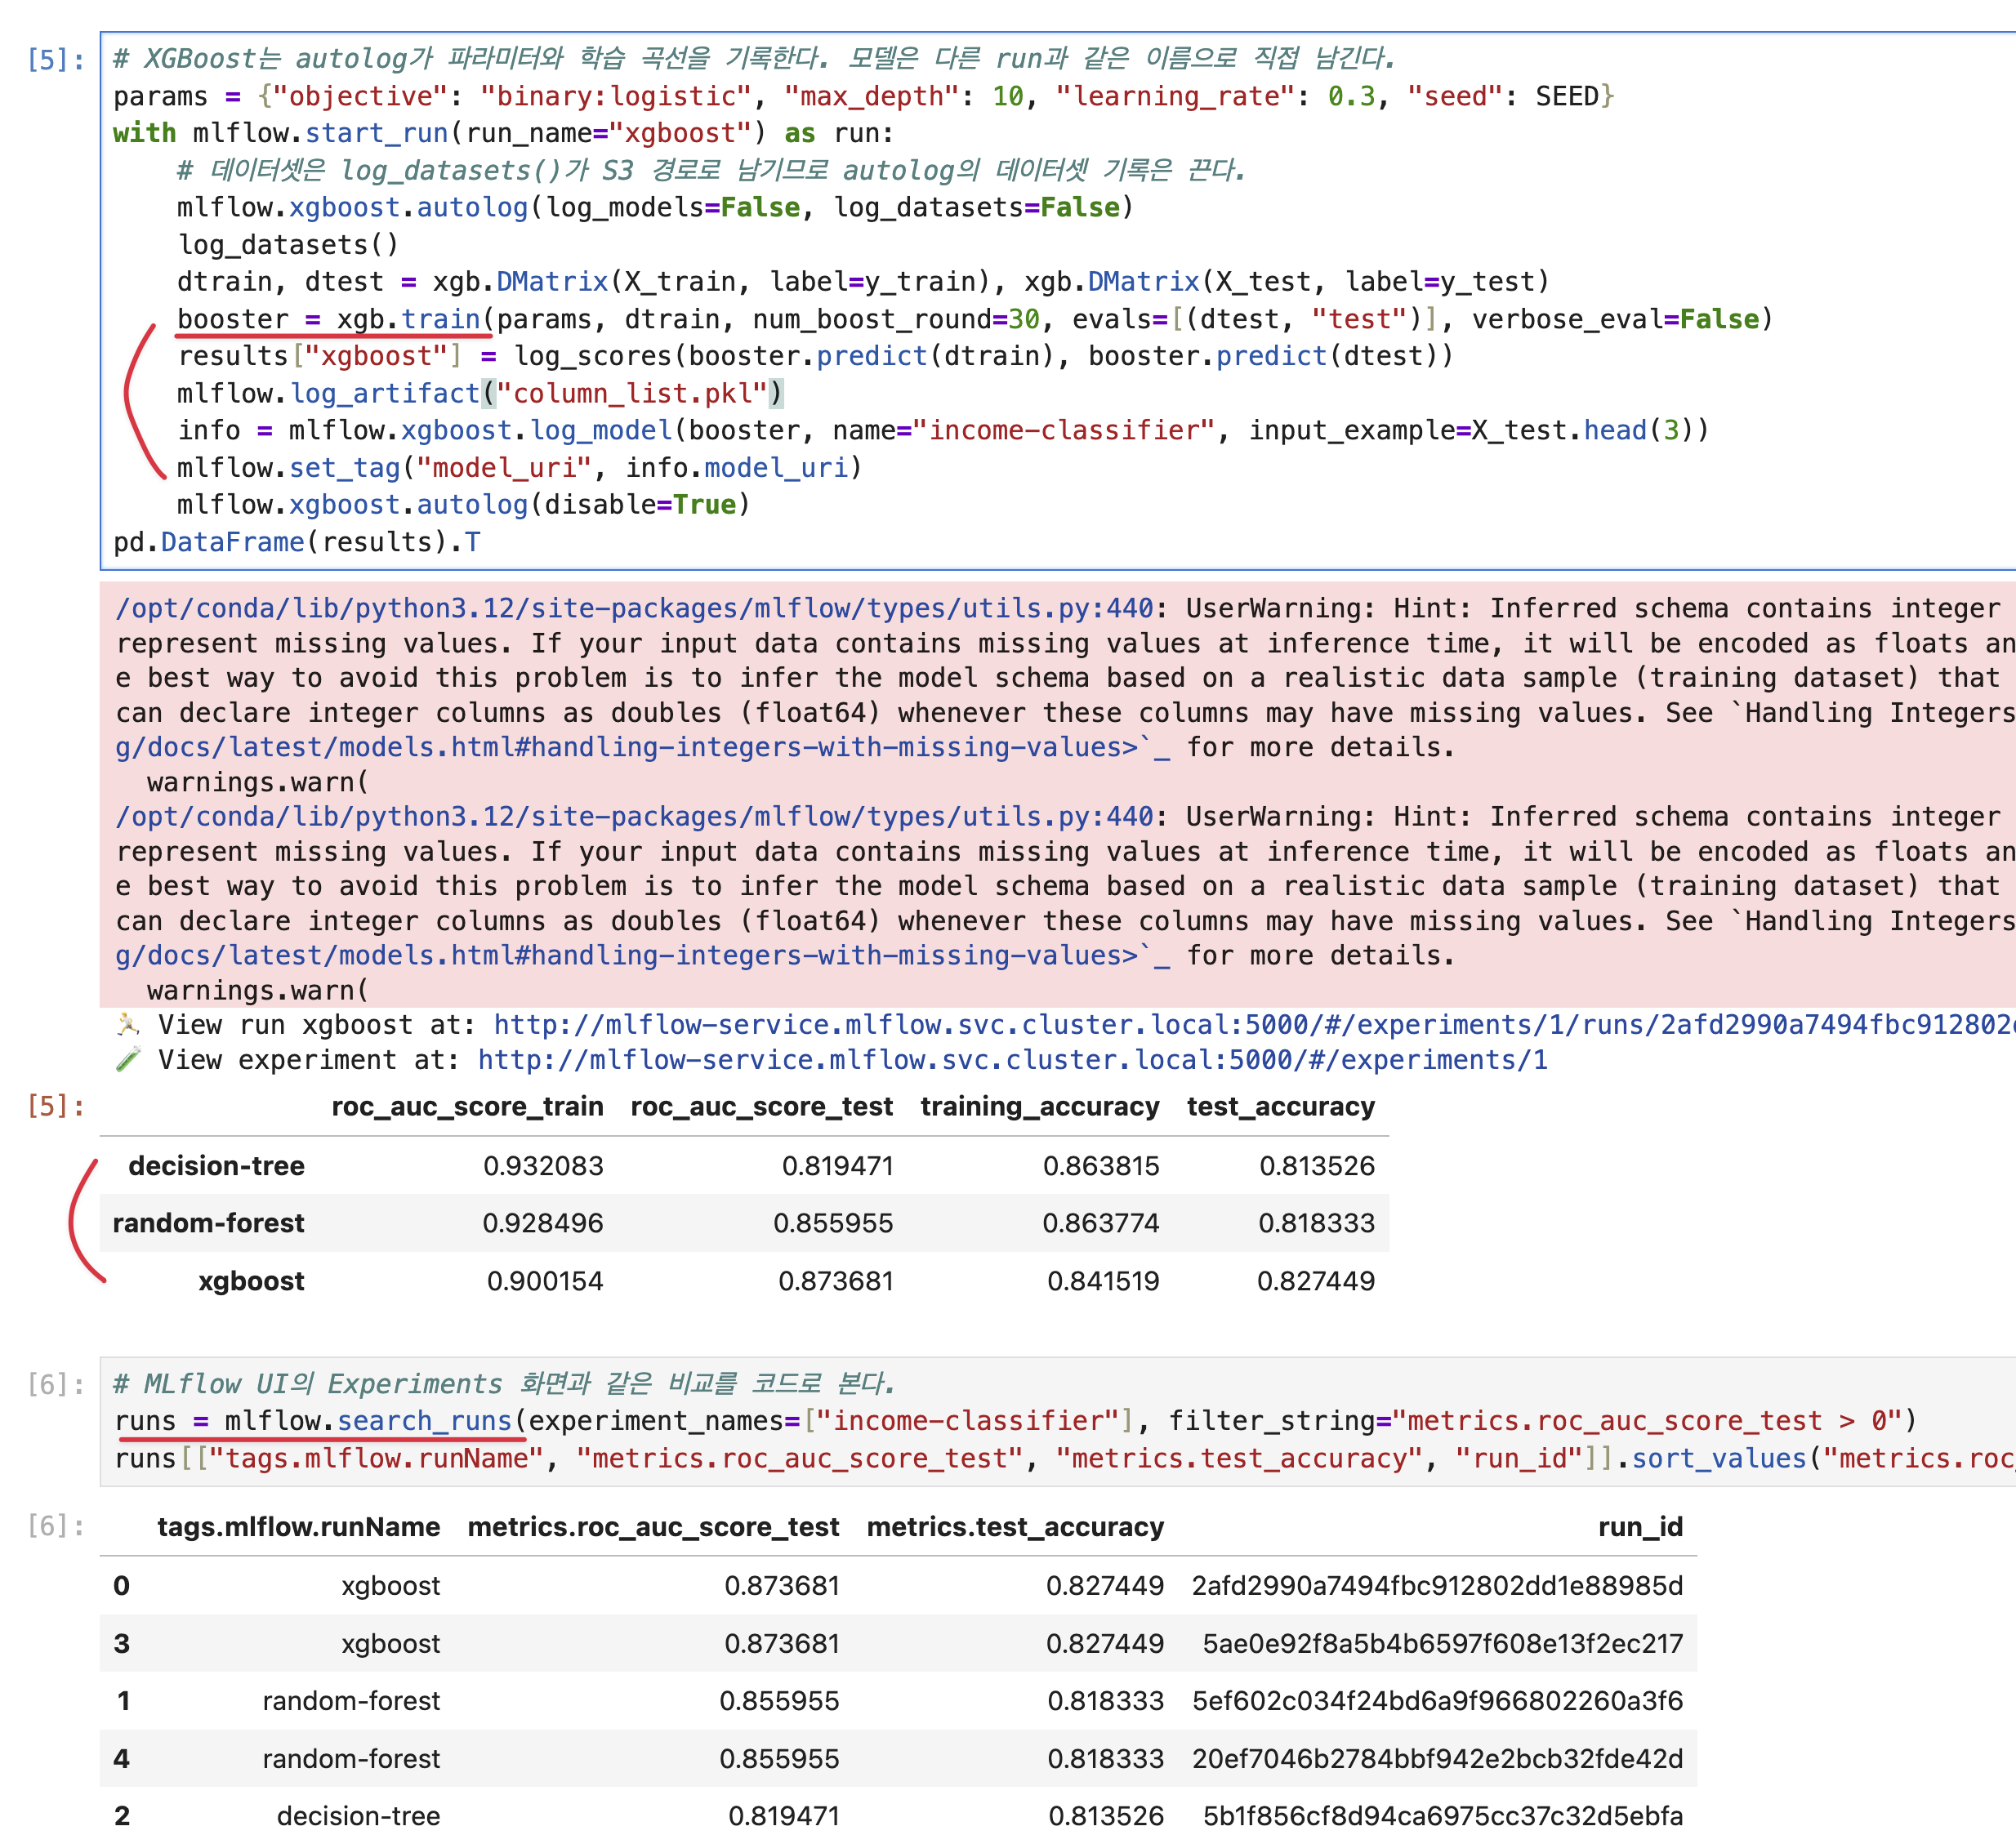
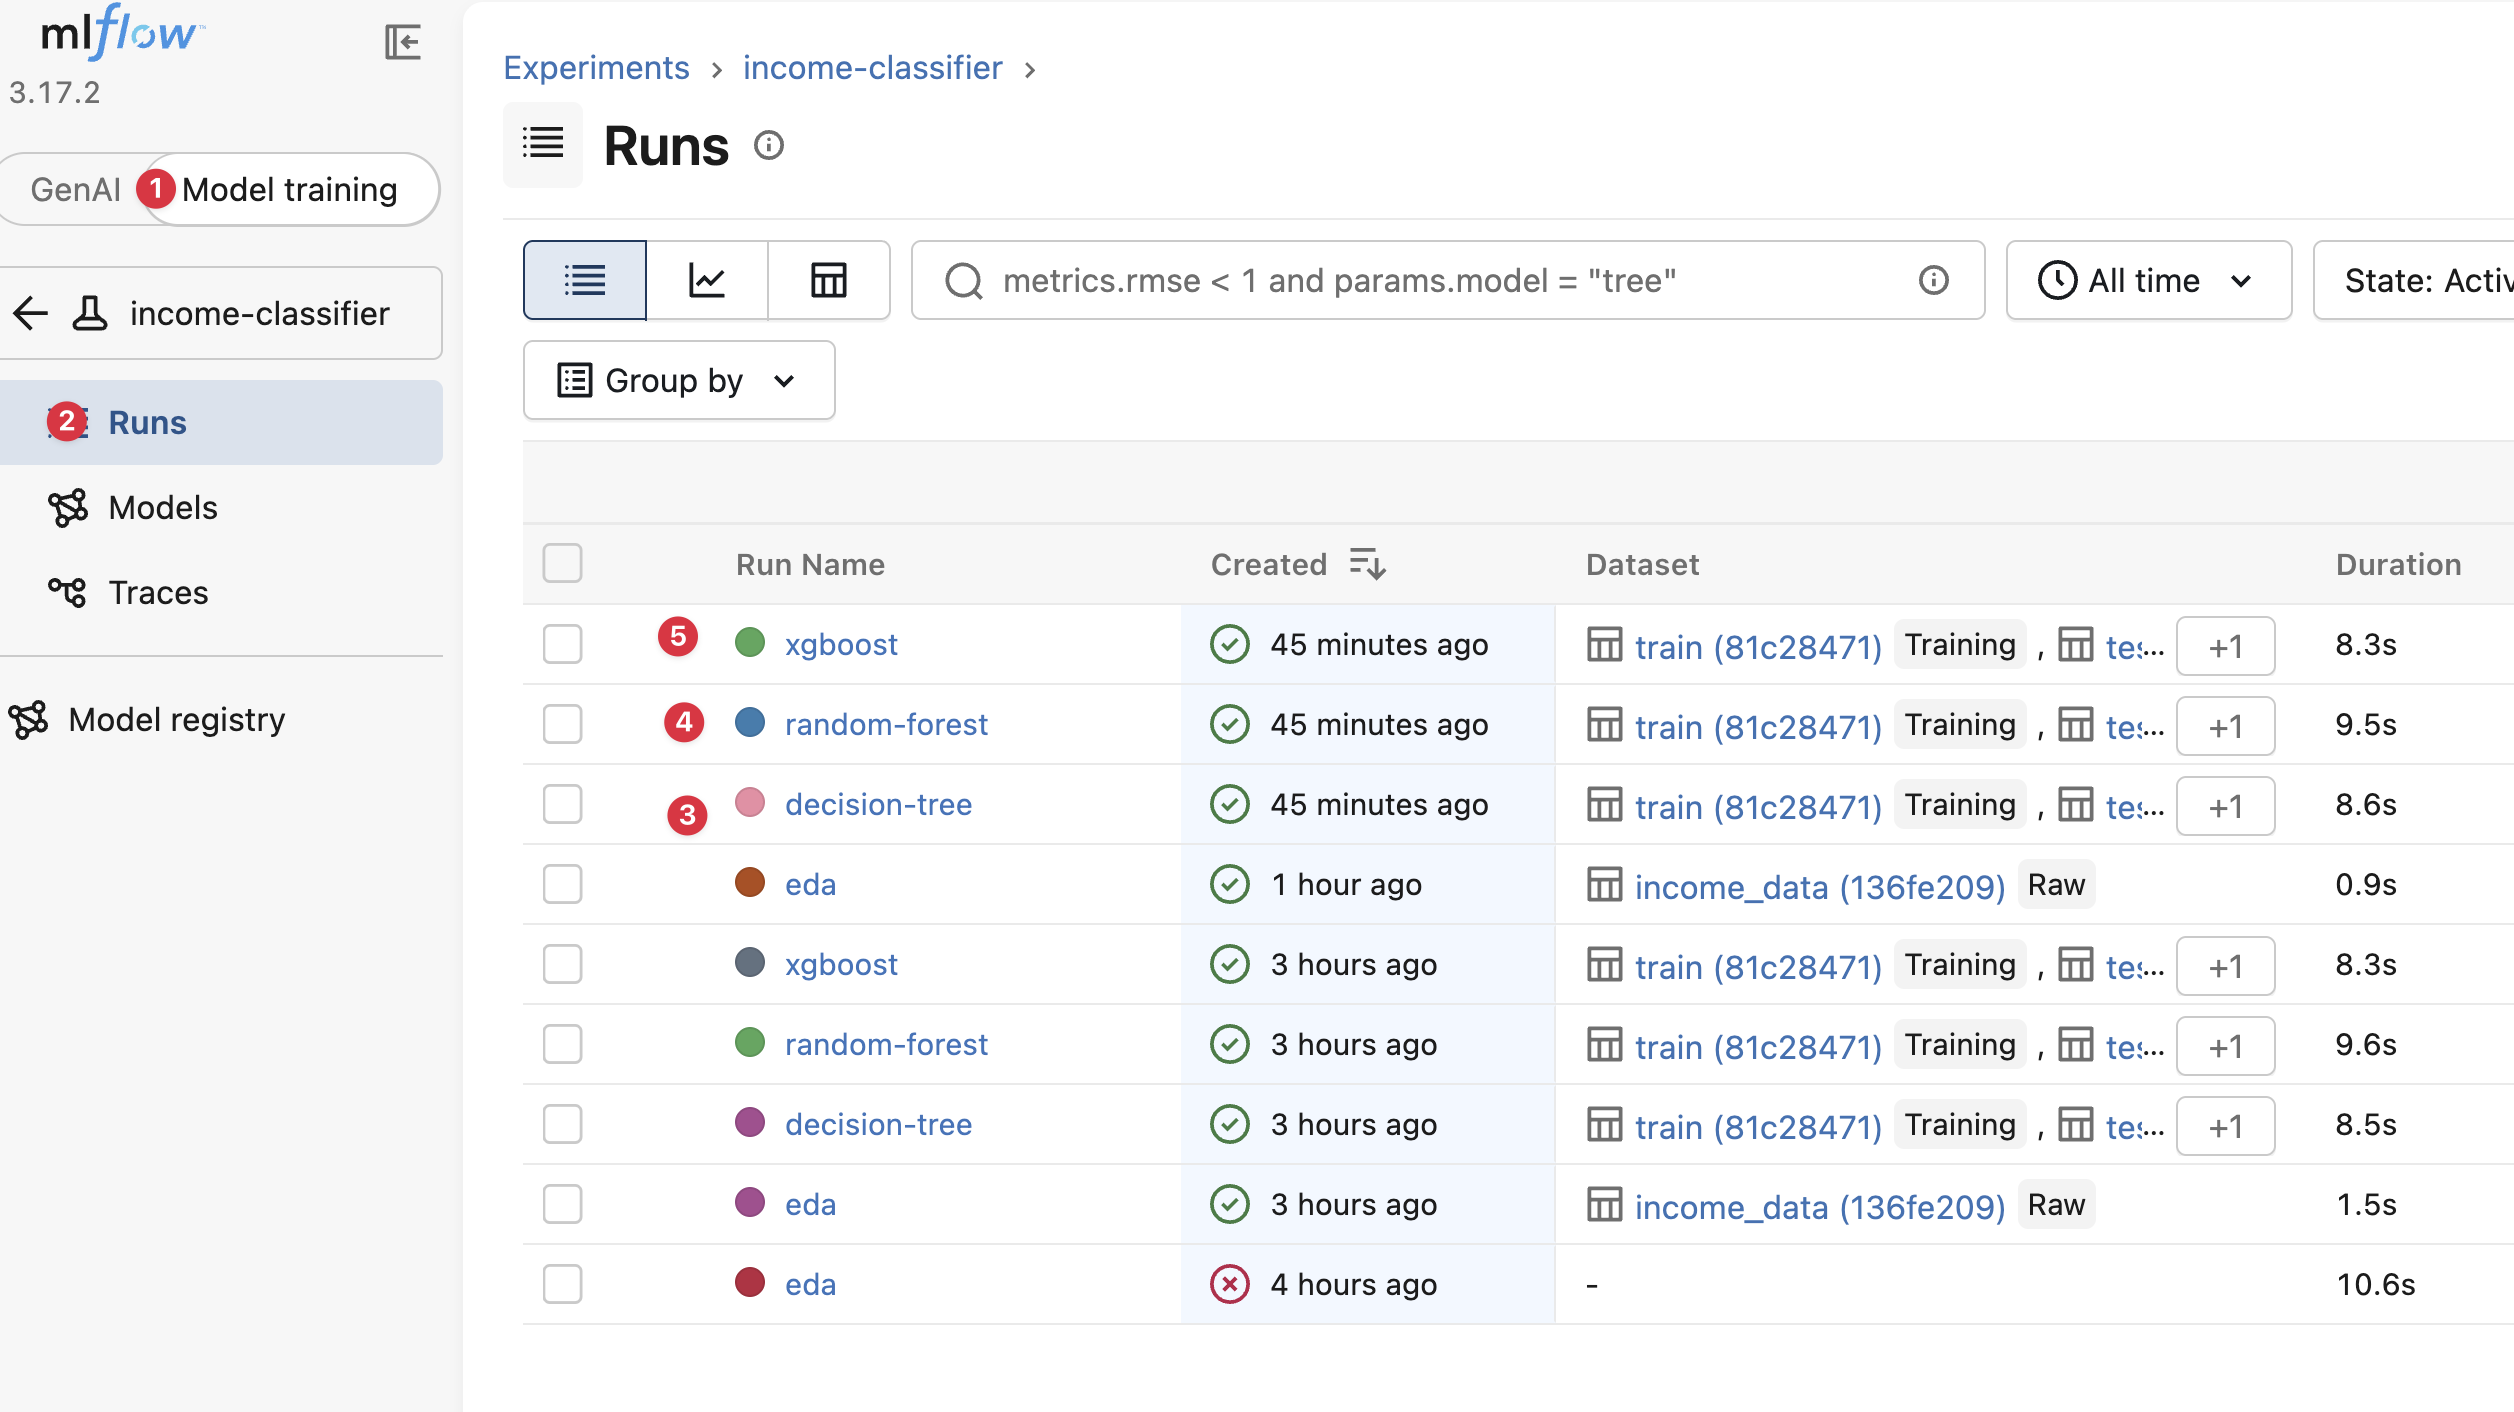
MLflow에서는 모델과 실험 데이터를 관리합니다.
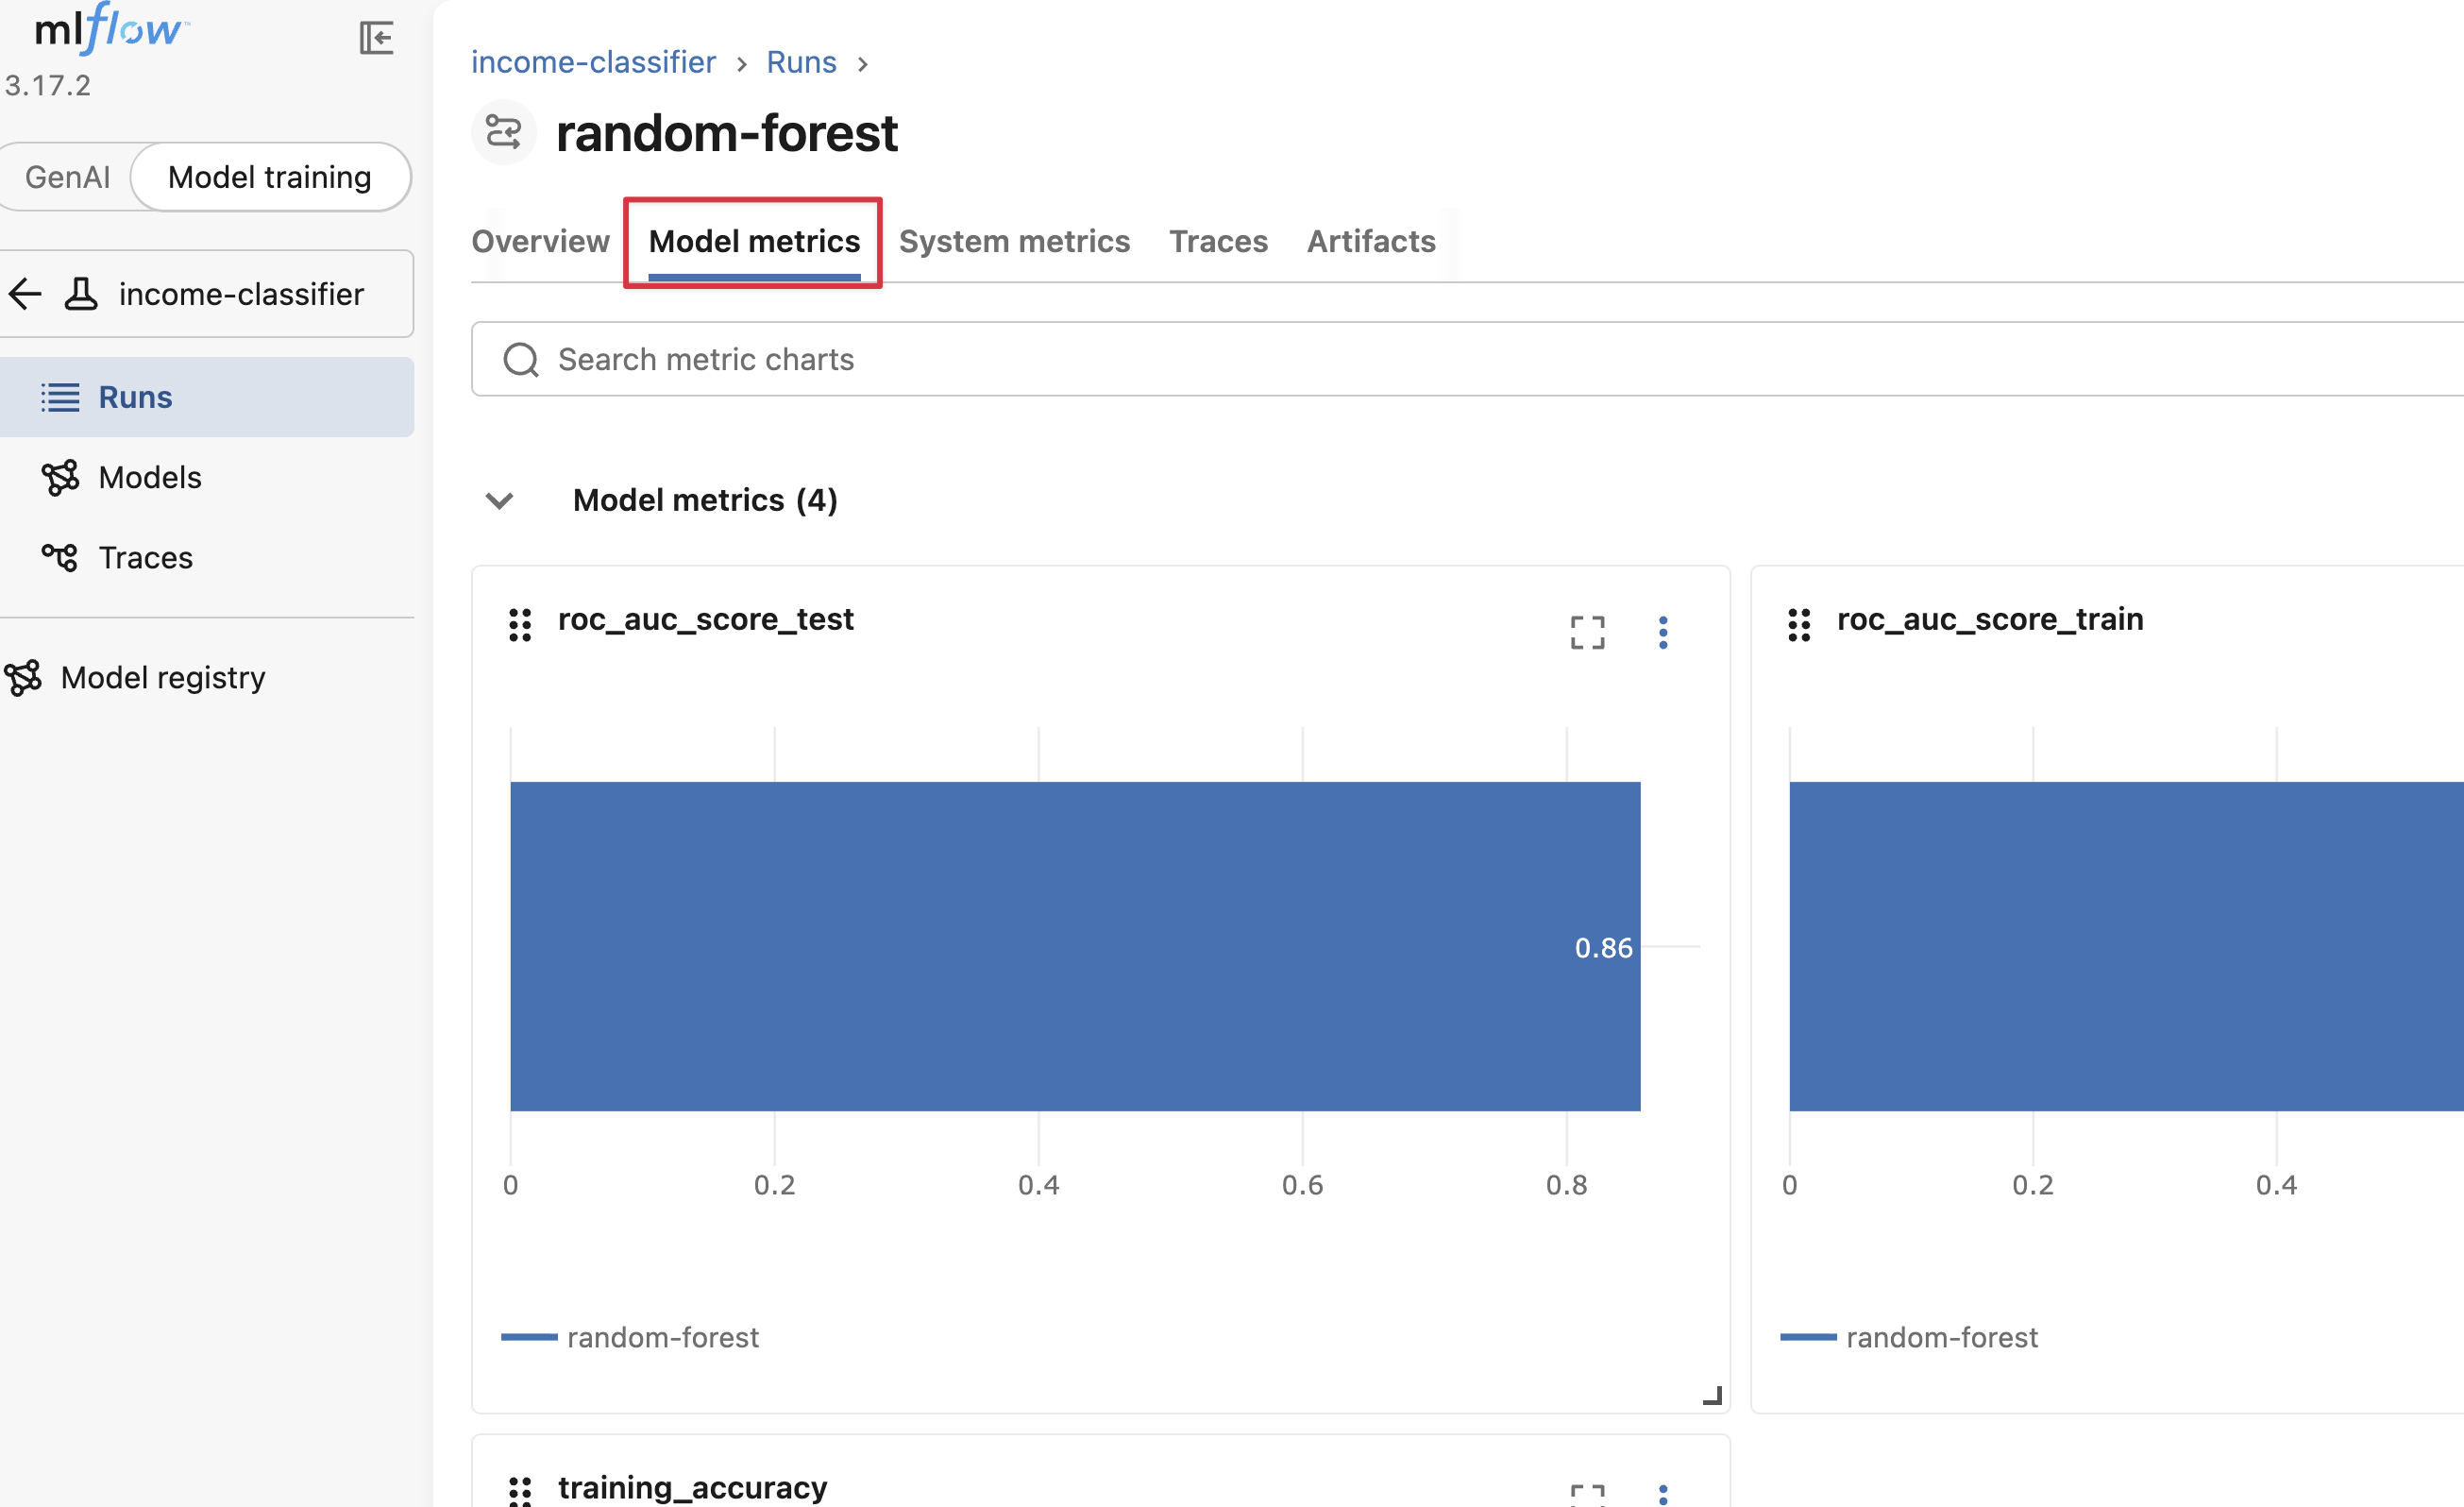
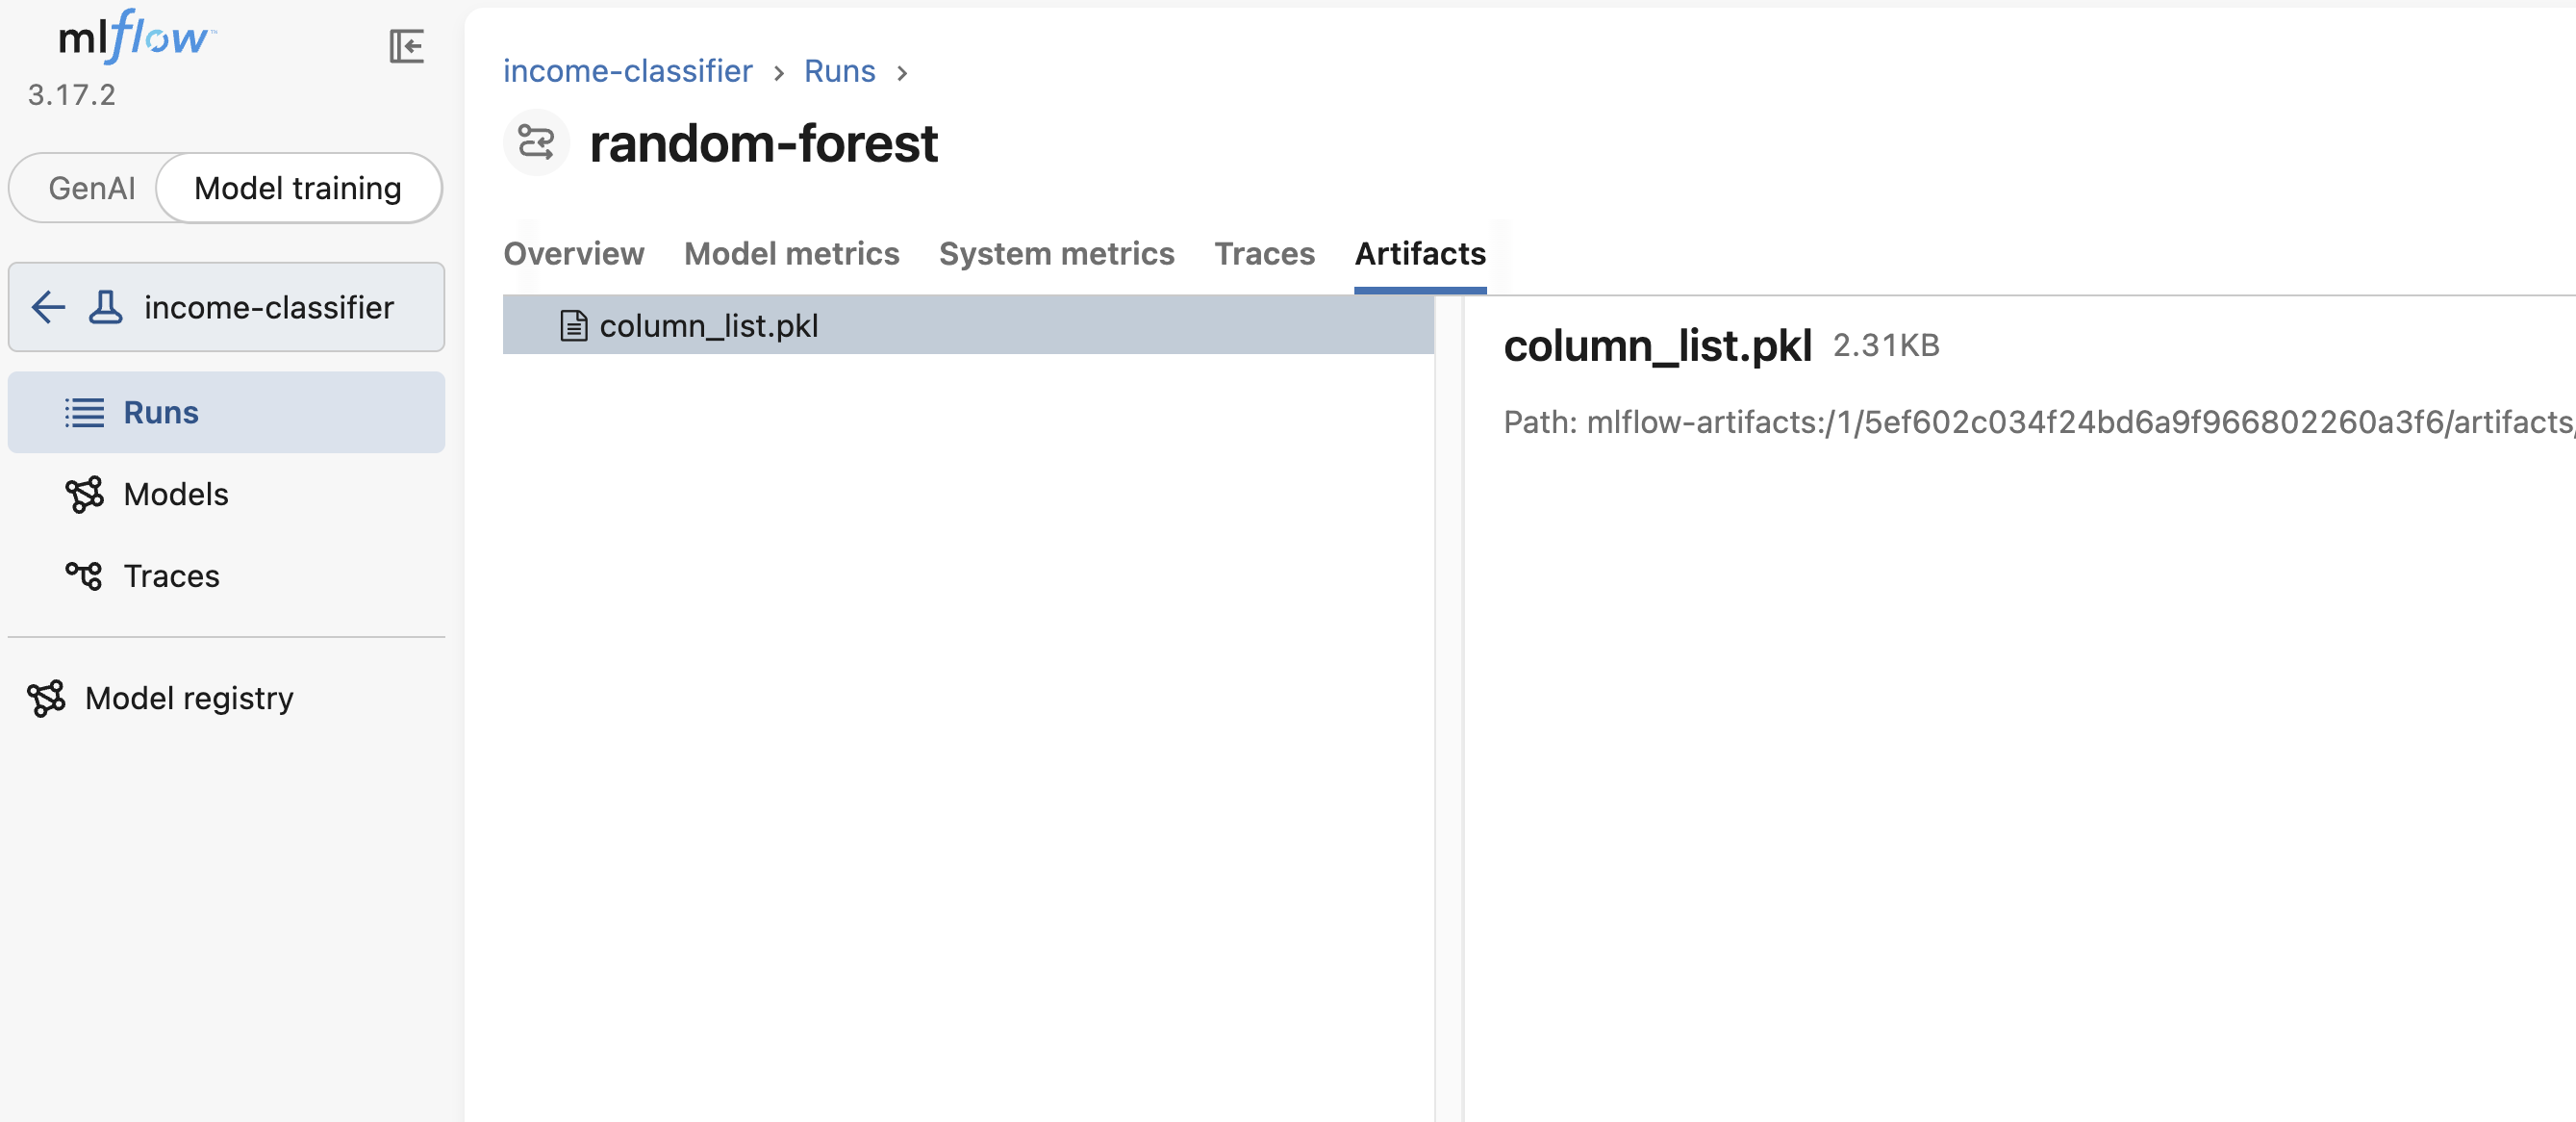
MLflow는 저장된 모델의 실험 데이터를 비교하는 기능을 제공하기 때문에 실험을 분석할 때 매우 좋습니다.
ML 플랫폼 기능5 - 파이프라인
이론
IDE에서 실험을 거듭하면 매번 똑같이 반복하는 단계가 생깁니다. 이 단계들을 순서대로 묶어 누구나 같은 방식으로 실행할 수 있게 만든 작업 흐름을 파이프라인이라고 합니다. ML 플랫폼은 파이프라인 정의, 실행, 모니터링 등의 기능을 제공하여 누구나 쉽게 파이프라인을 만들고 실행할 수 있도록 해야 합니다.
실습: Kubeflow
알려진 오픈소스 파이프라인은 Kubeflow입니다. Kubeflow는 Kubernetes 기반으로 파이프라인을 관리하며, 파이프라인 기능으로 KFP(Kubeflow Pipelines)를 제공합니다.
IDE에서 작성한 EDA 코드를 Kubeflow 파이프라인에 등록하면 아래처럼 누구나 파이프라인을 보고 실행할 수 있습니다.
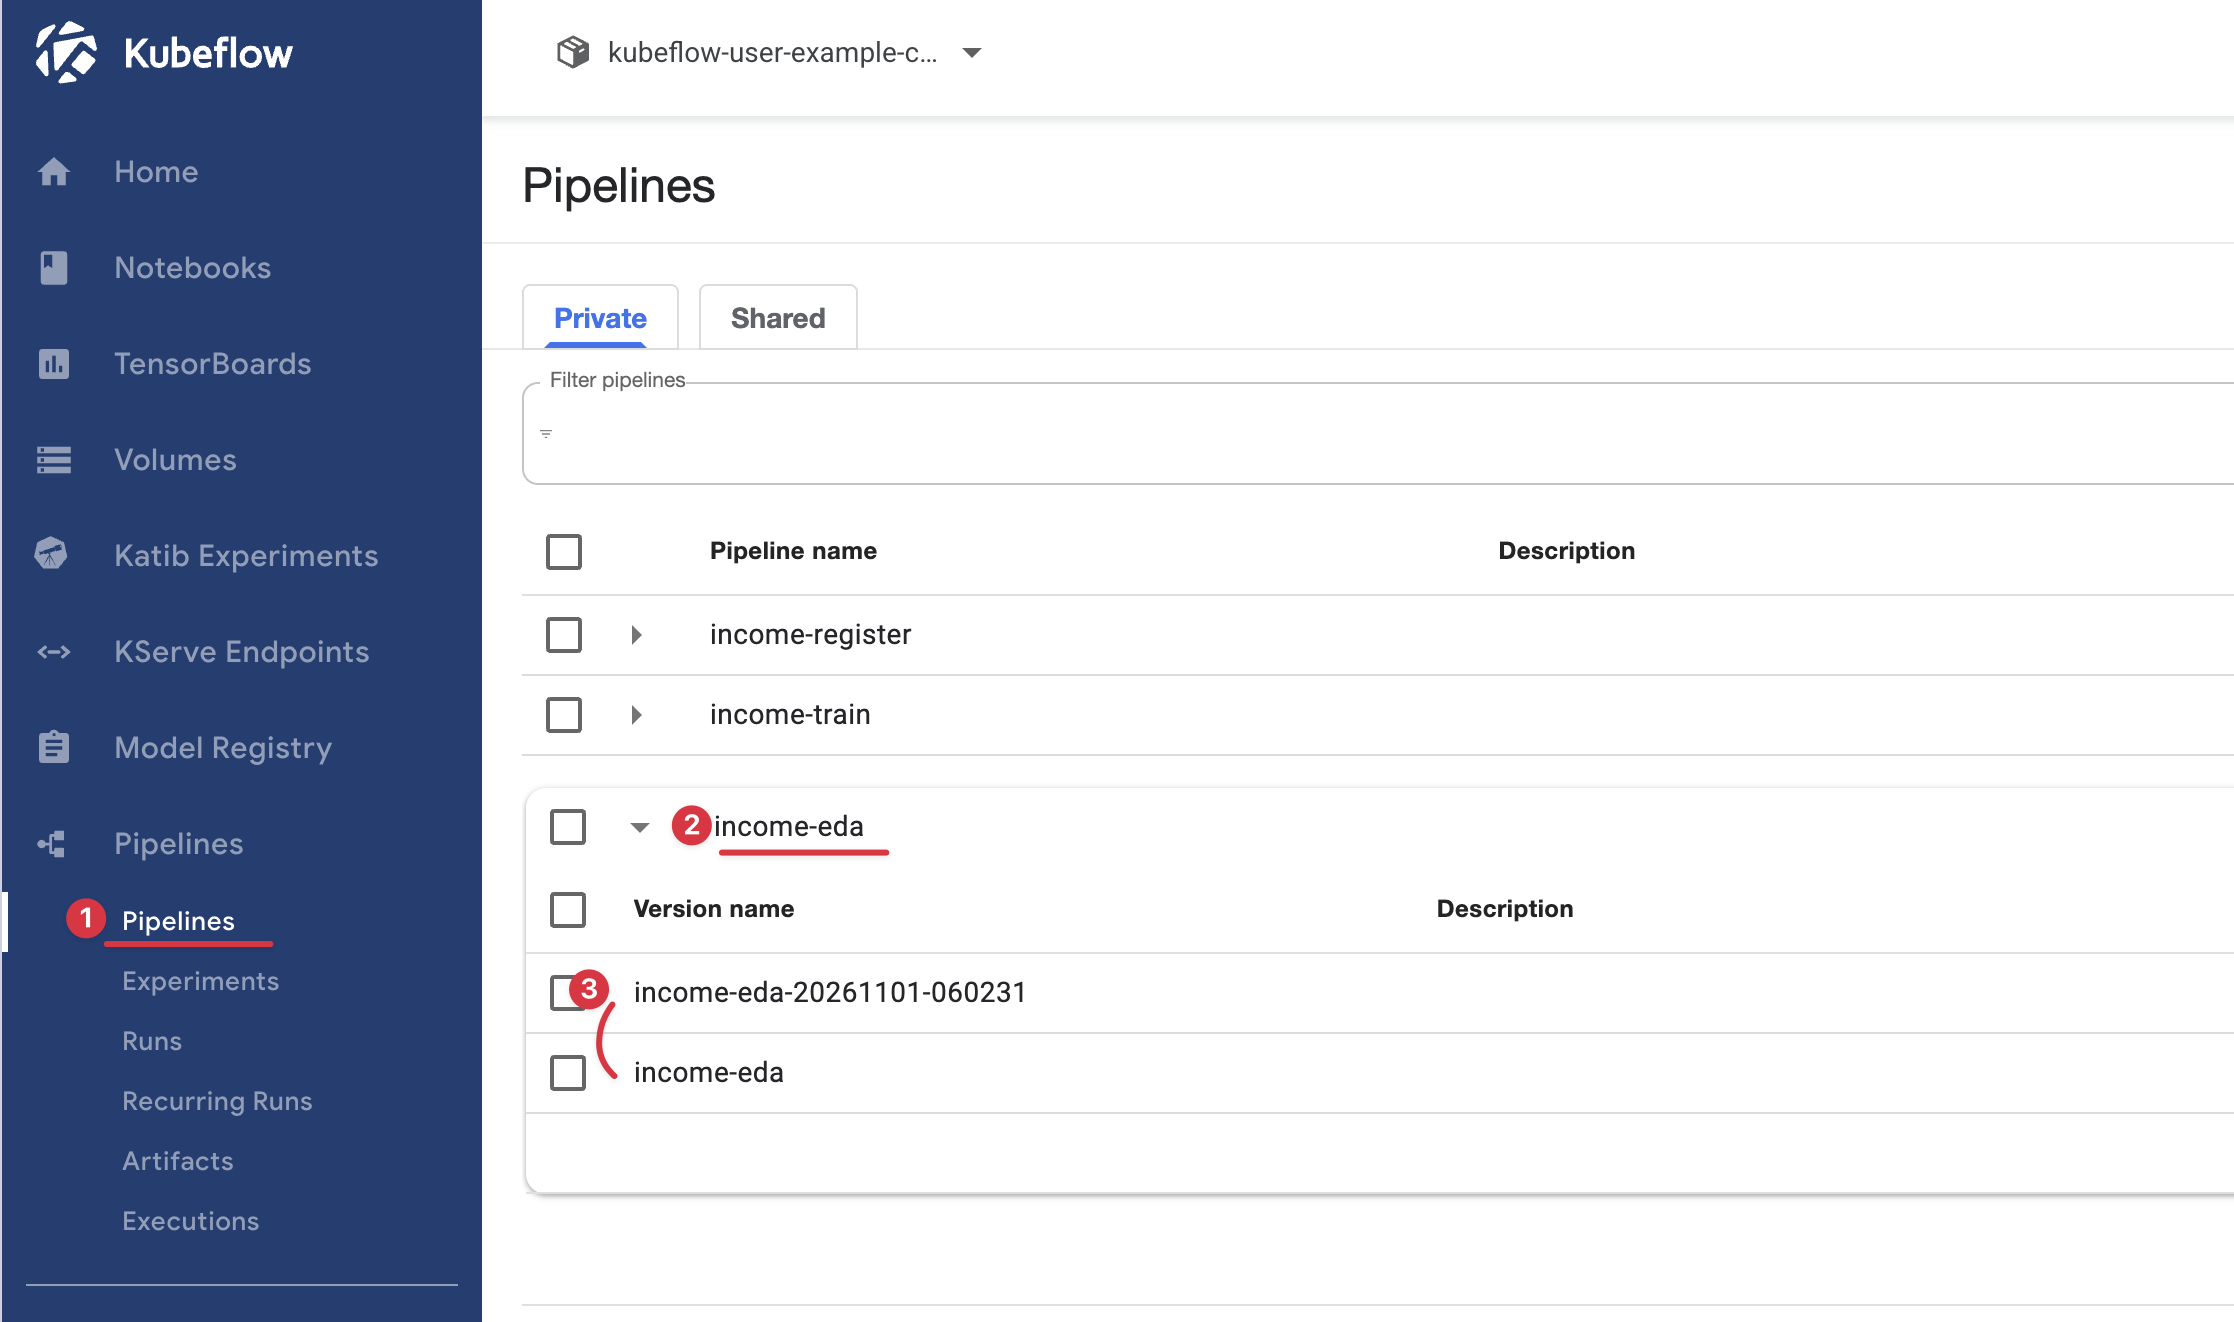
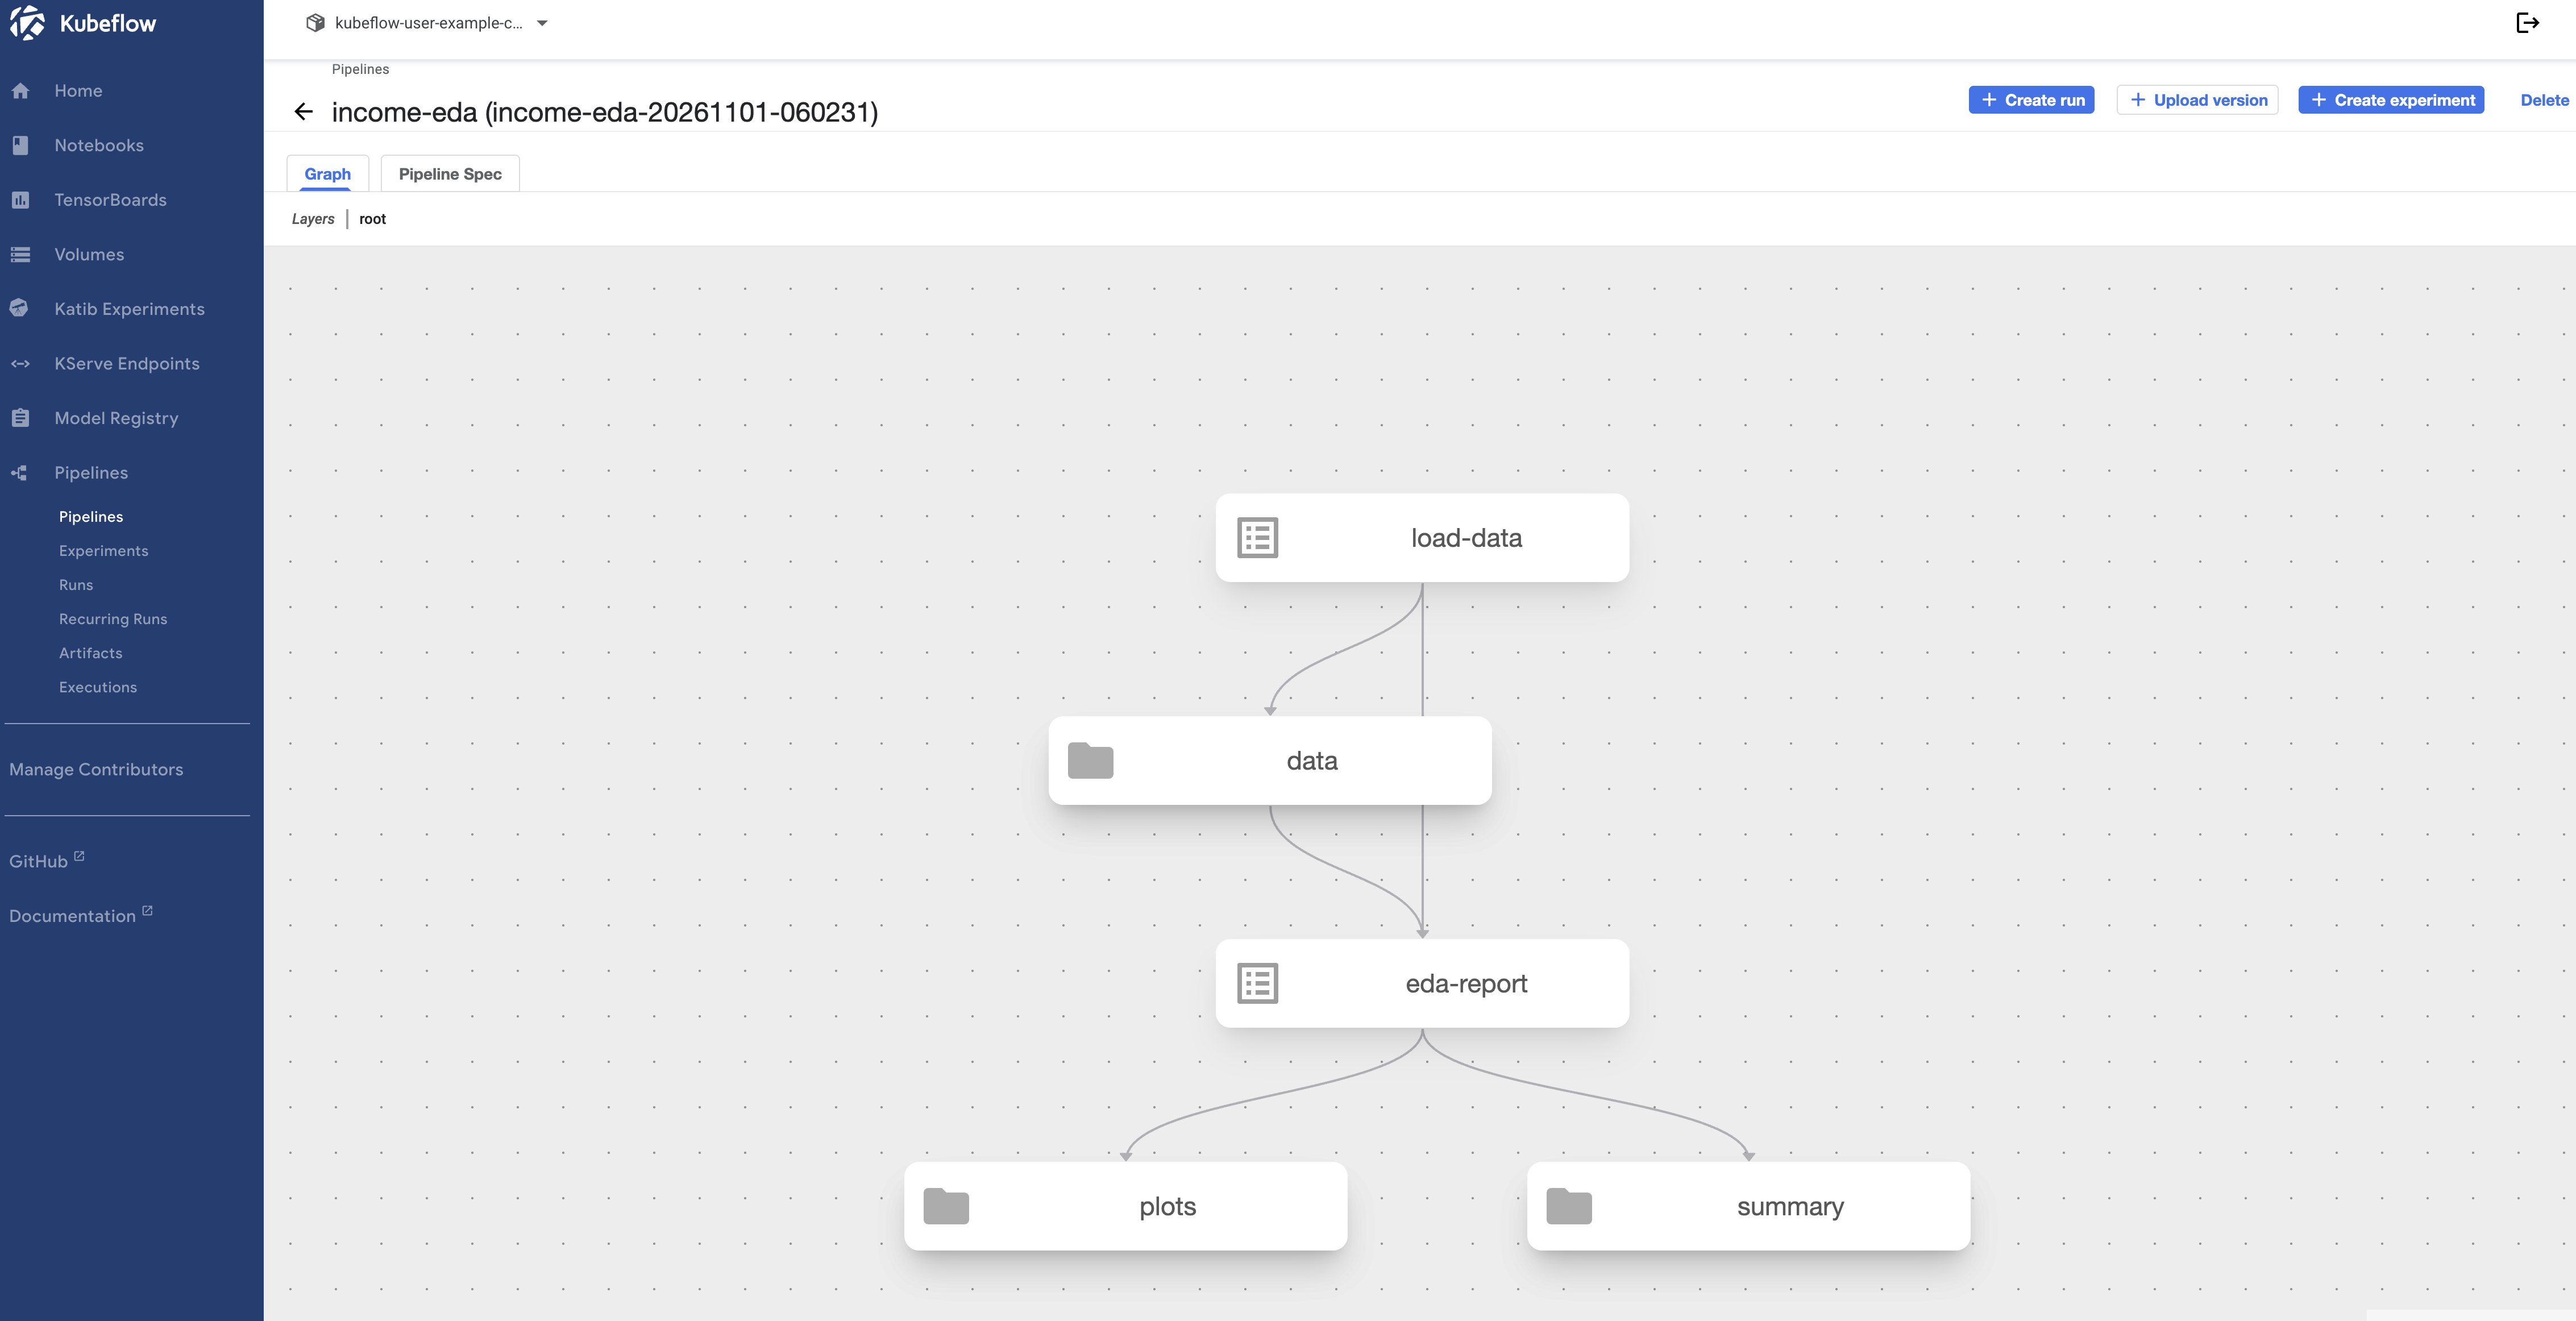
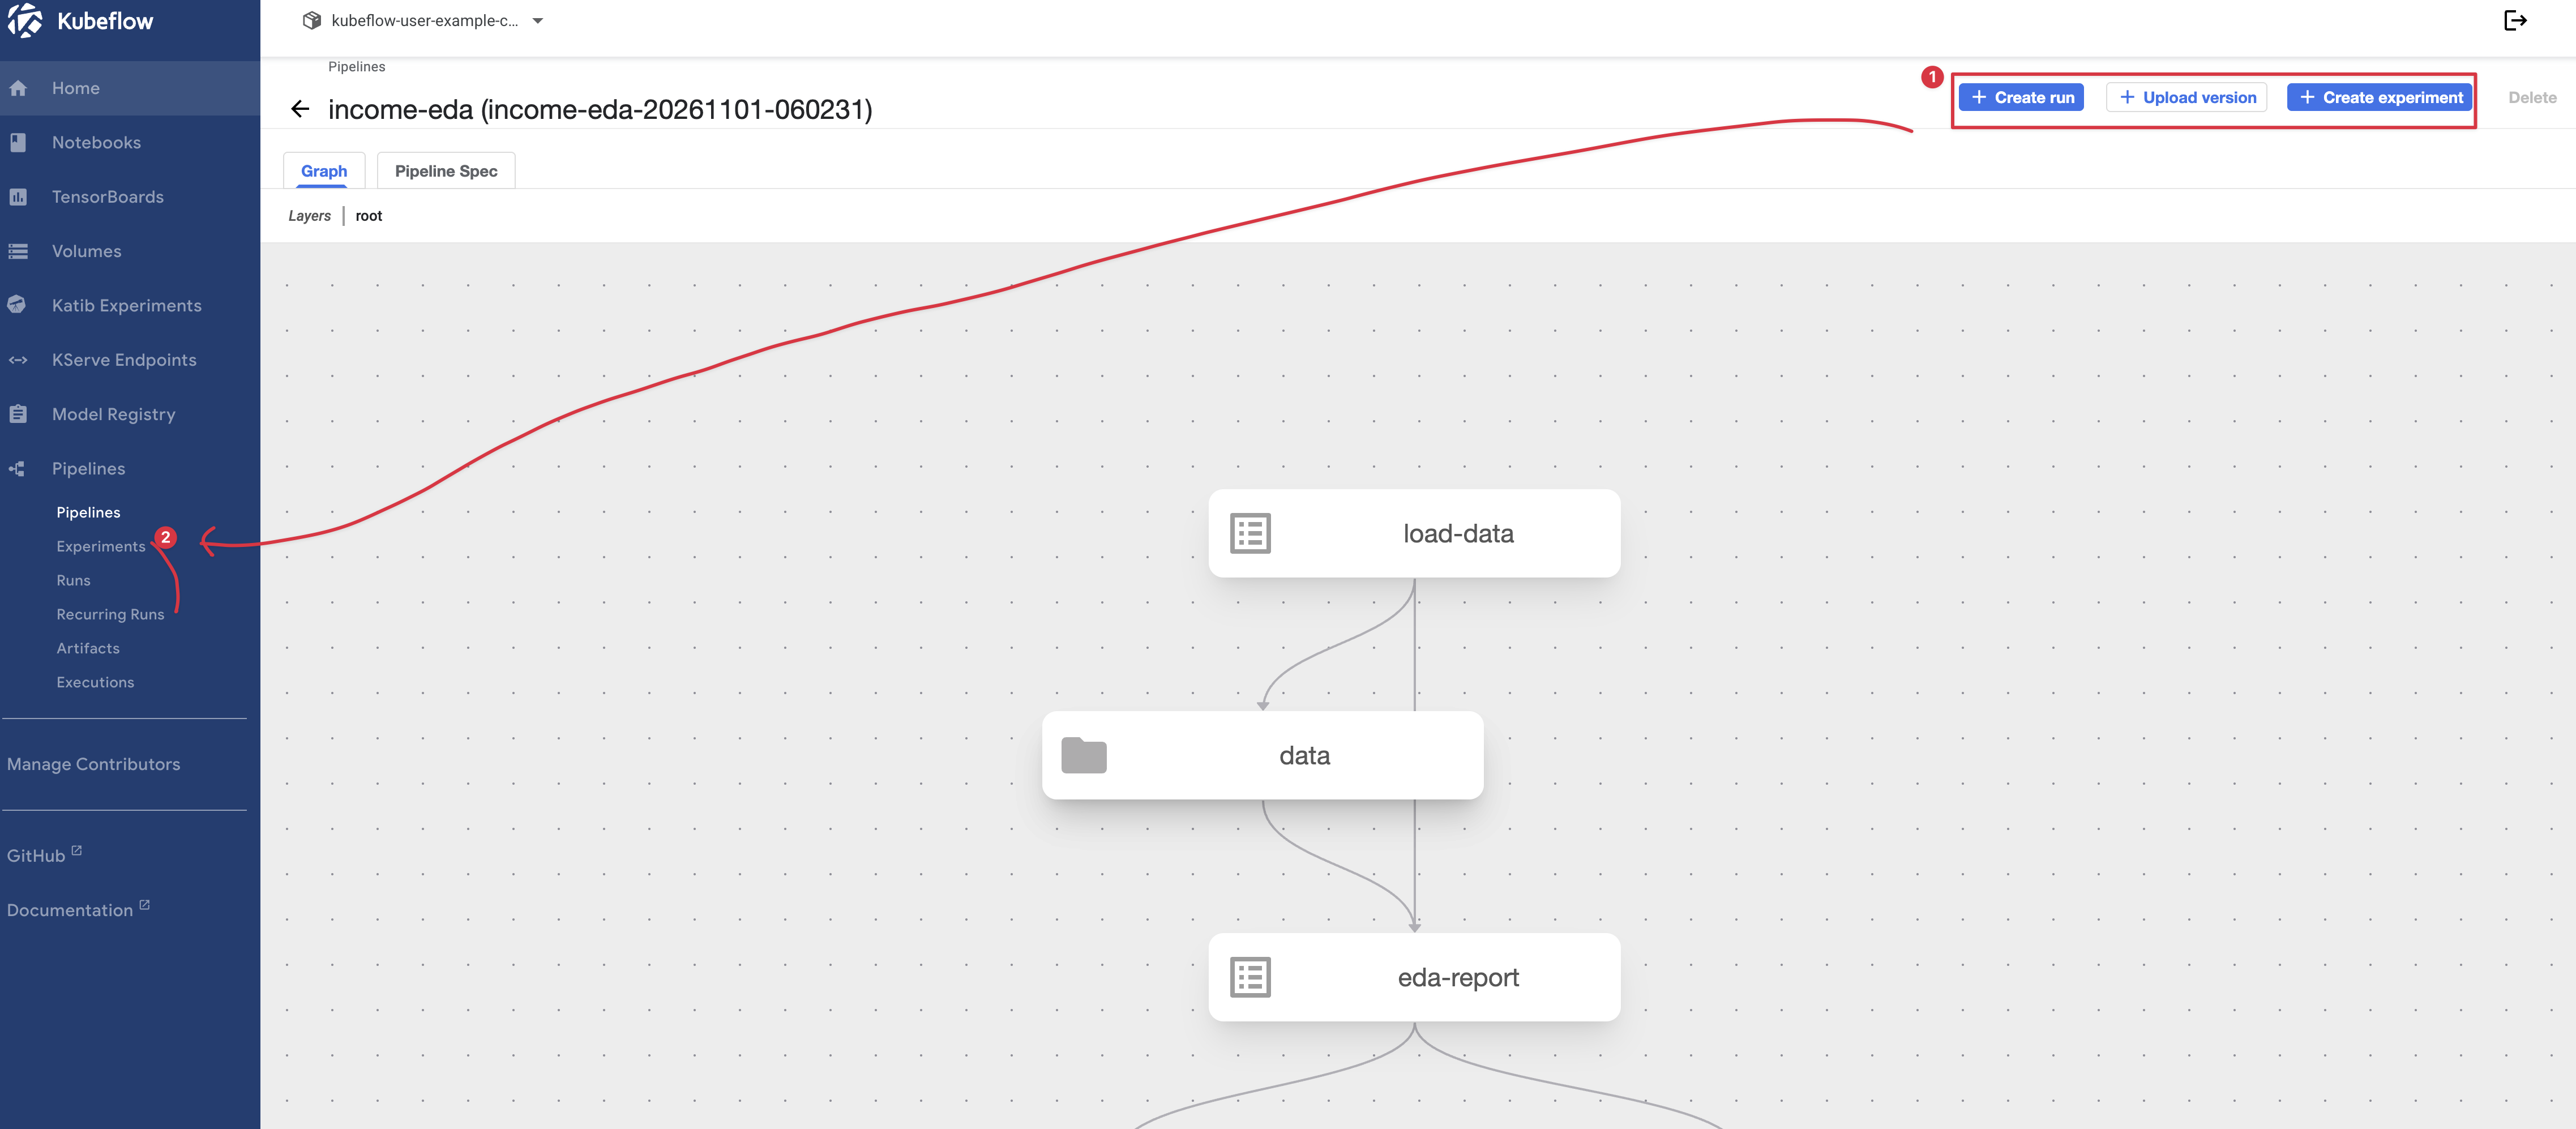
Kubeflow 파이프라인은 정의일 뿐이라 실행하려면 오른쪽 위에서 run 또는 experiment를 생성해야 합니다. run은 일회성 실행이고 experiment는 run을 묶어서 관리하는 방법입니다. recurring run은 run을 주기적으로 실행하는 리소스입니다.
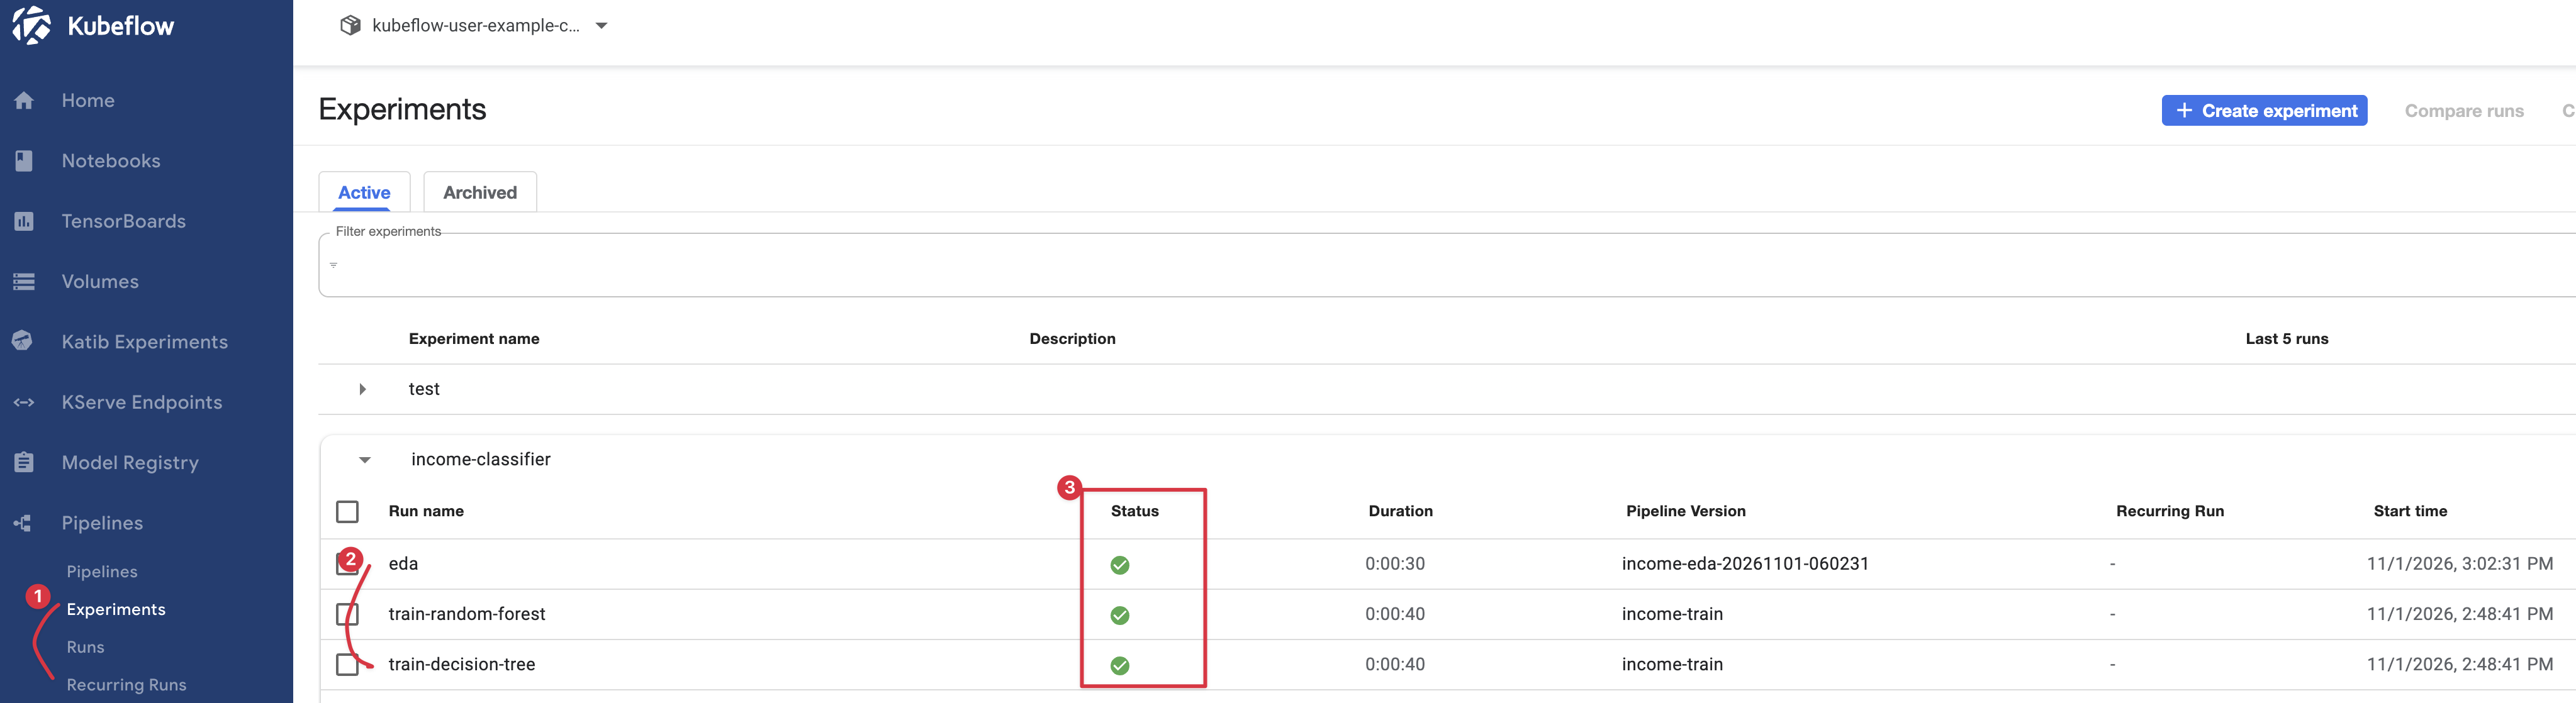
experiment 또는 run을 클릭하면 지금까지 실행한 파이프라인 결과가 표시됩니다.
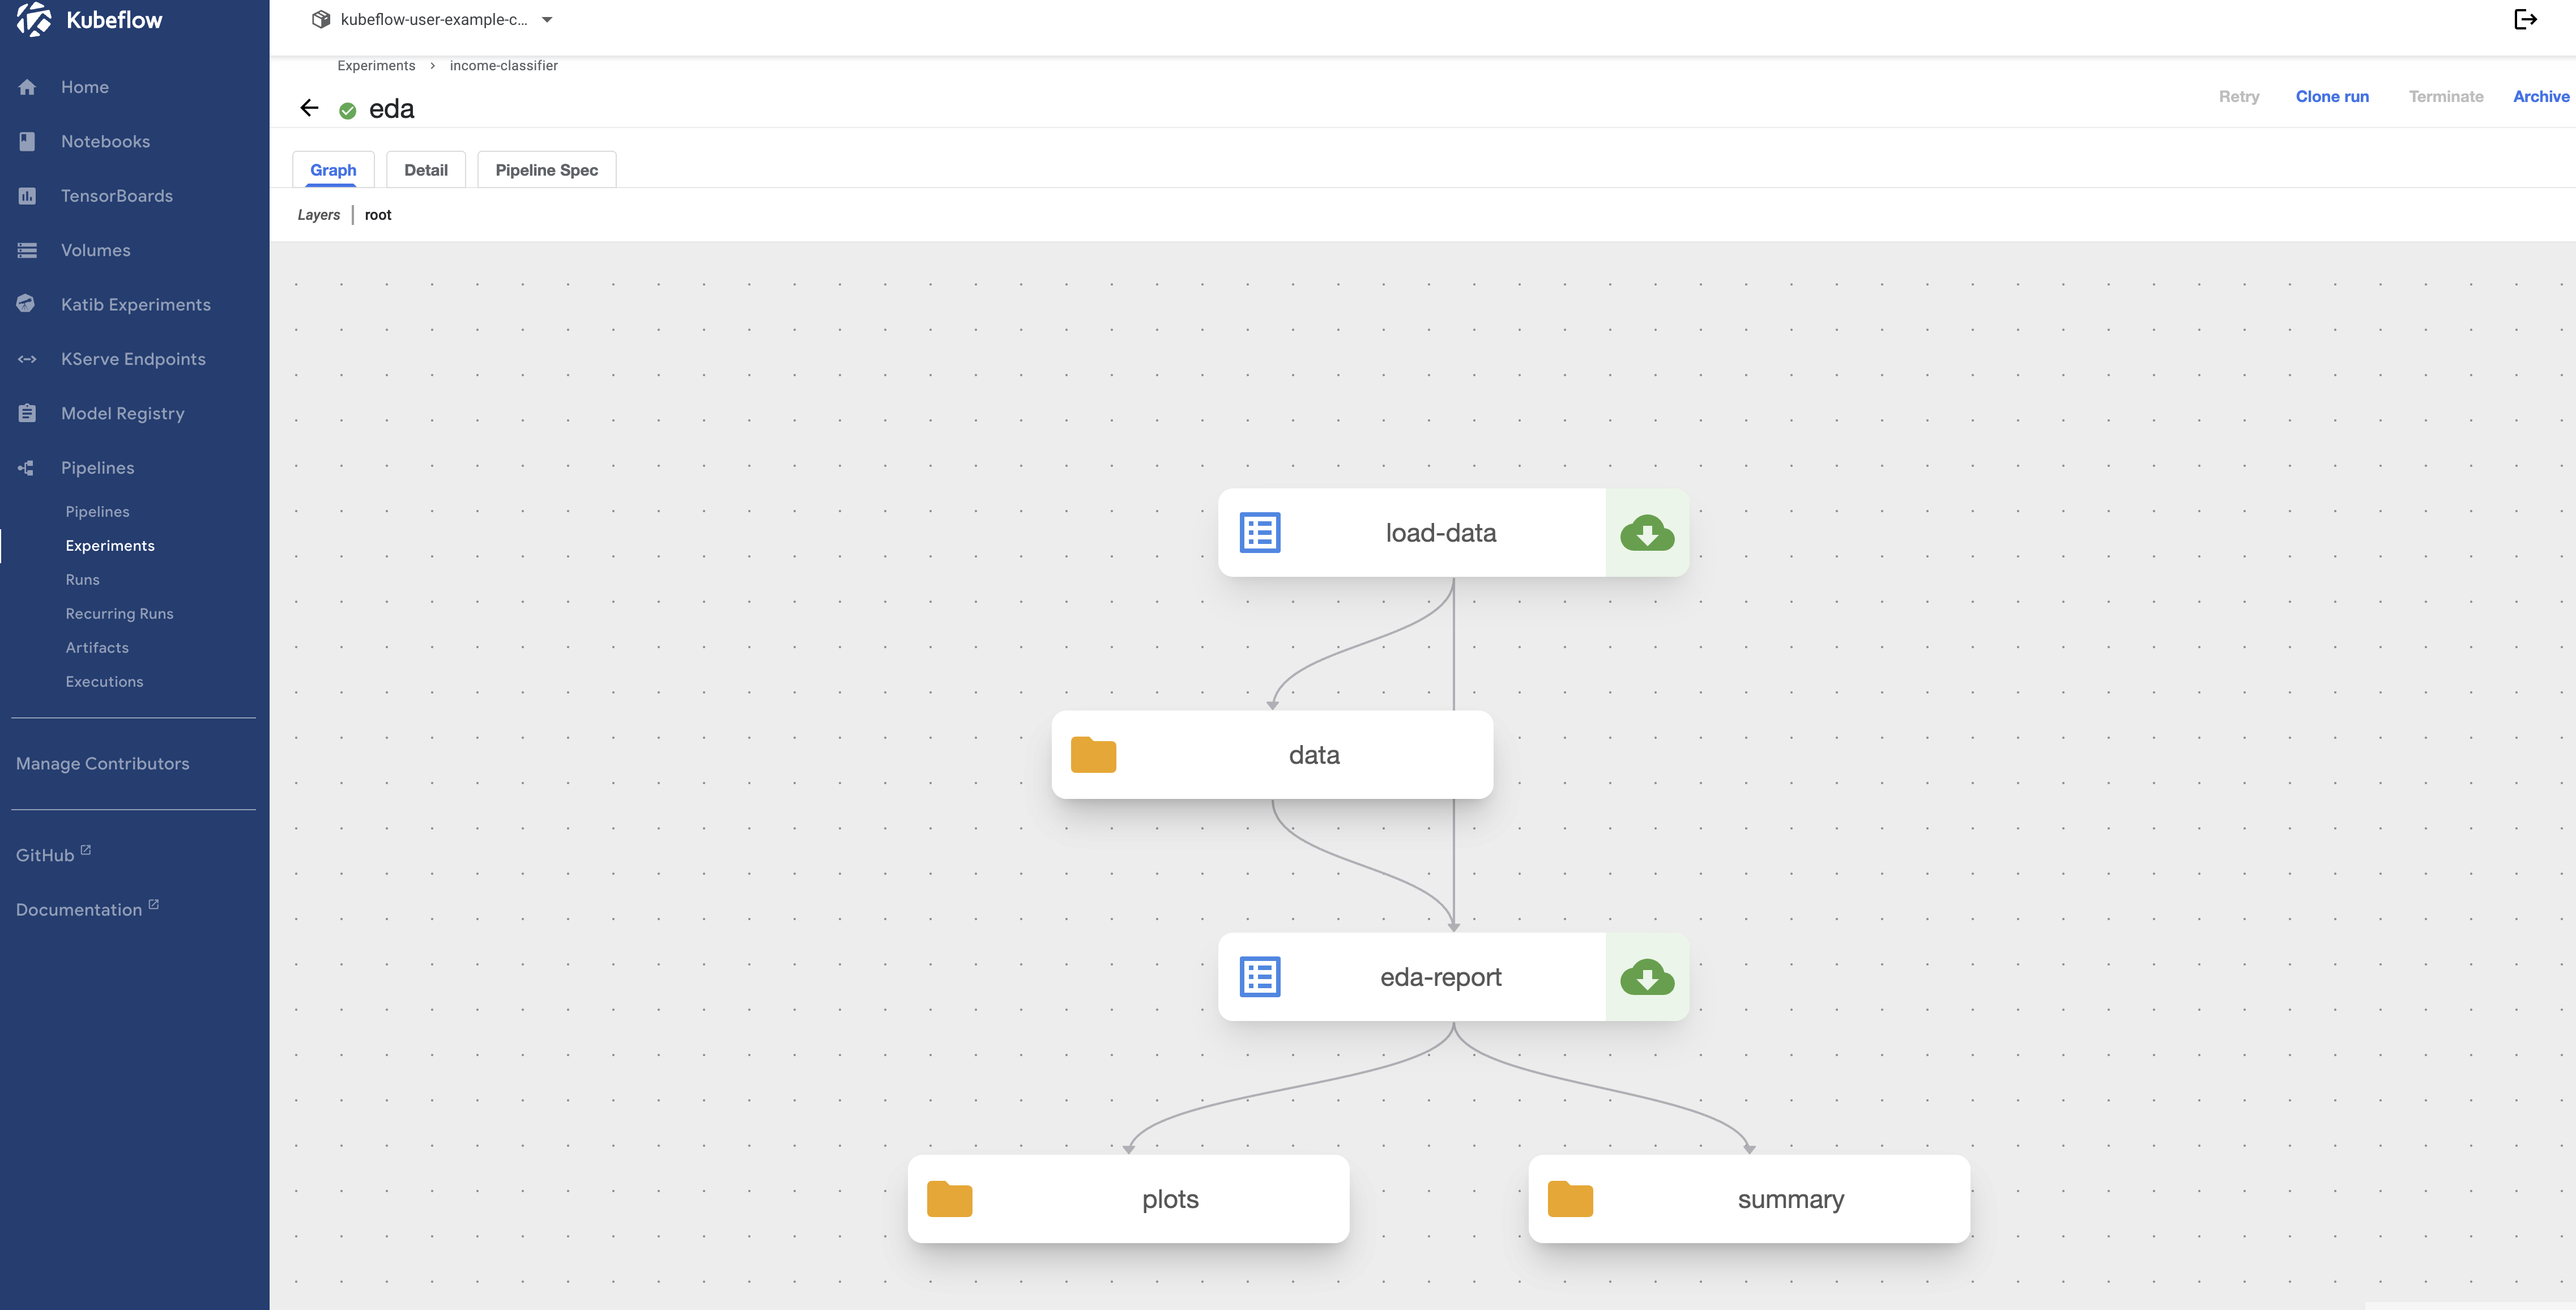
Kubeflow 파이프라인은 Python SDK로 정의합니다. SDK 컴파일러가 Python 코드를 YAML로 바꾸고, 이 YAML을 Kubeflow에 올려 실행합니다. 아래 그림은 Python SDK를 사용한 예제입니다.

ML 플랫폼 기능6 - 서빙
이론
서빙은 이전 글에서 정리한 것처럼 모델을 외부에서 호출할 수 있게 만드는 과정을 말합니다. 소프트웨어의 배포와 비슷한 의미입니다.
- 서빙 정리: https://malwareanalysis.tistory.com/950
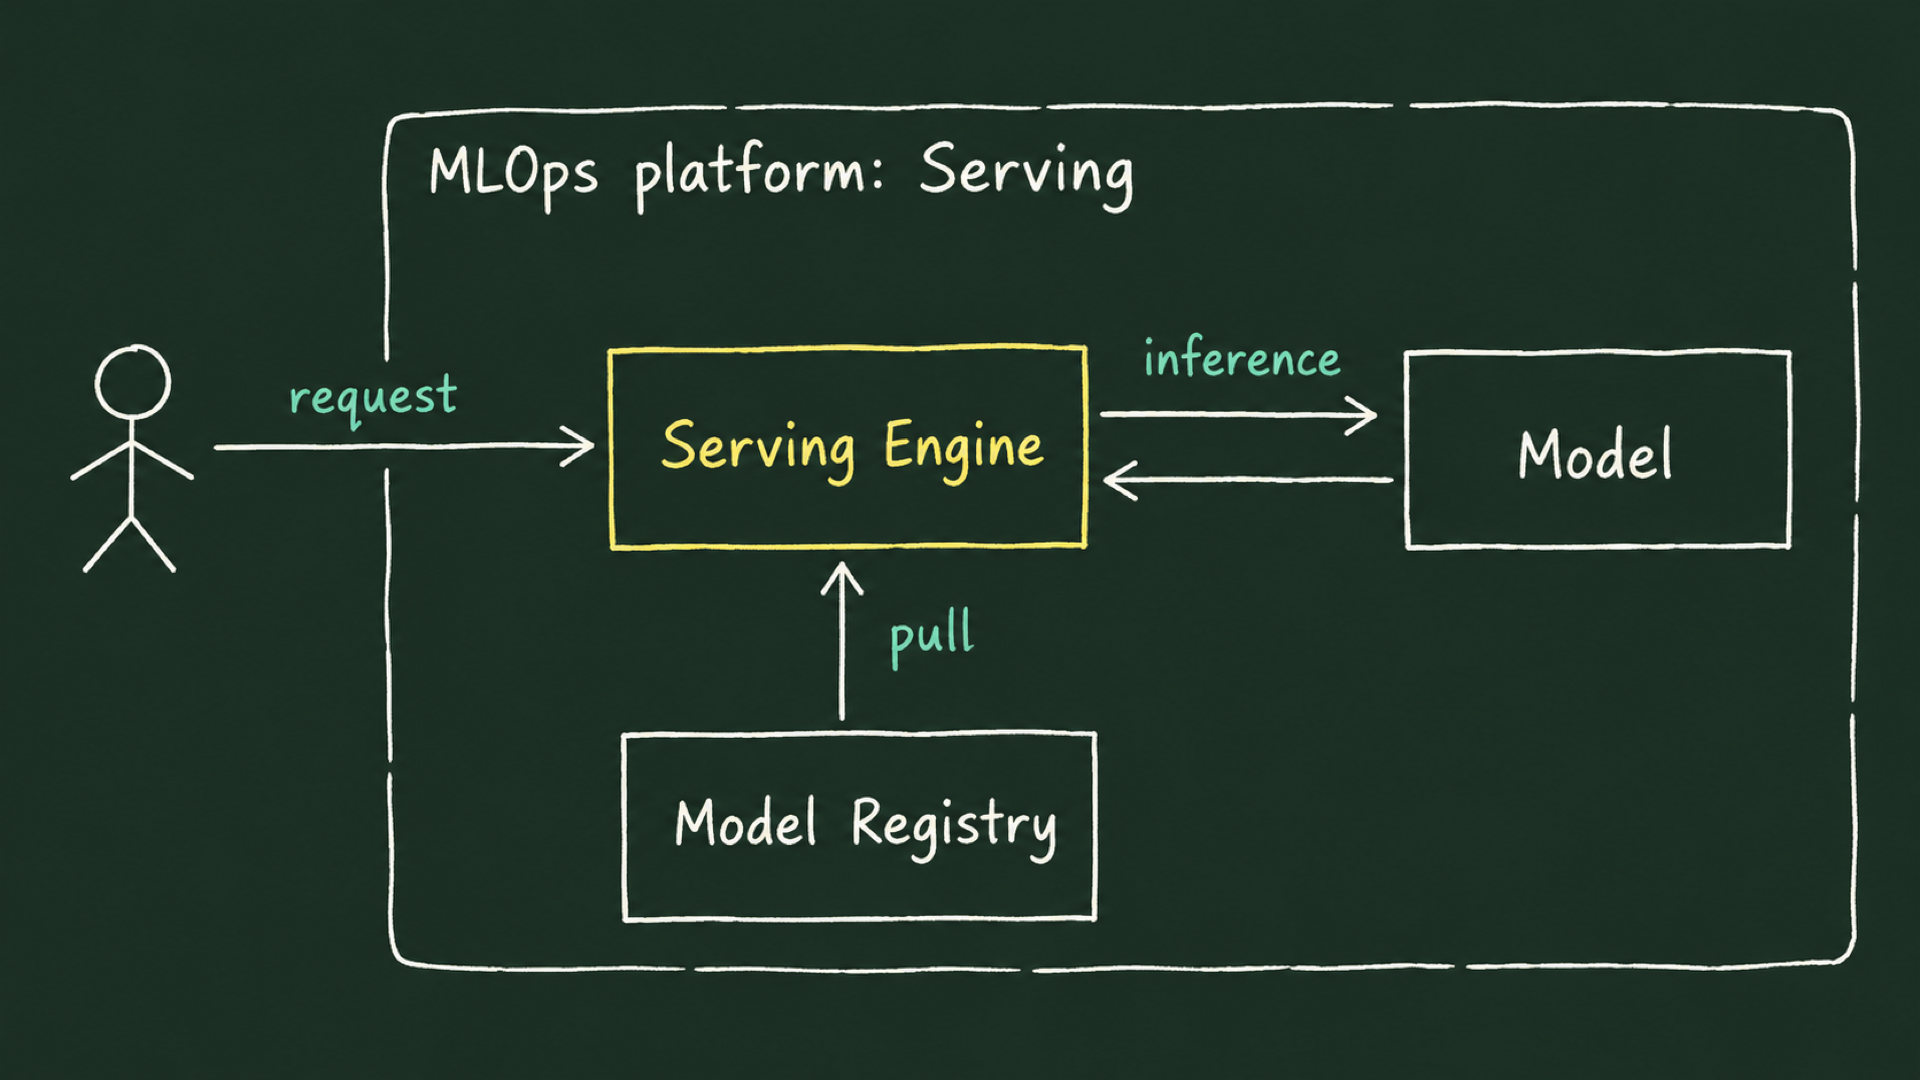
서빙하려면 GPU 튜닝, champion 모델 선정, 서빙 엔진 선정, 배포 전략 등이 필요합니다. 배포 전략은 소프트웨어 배포 전략과 비슷한데, Shadow라는 배포 전략이 추가로 있습니다.
| 전략 | 방식 | 장점 |
|---|---|---|
| Recreate | 기존 모델을 내리고 새 모델을 띄움 | 단순함 |
| Rolling update | 새 파드를 띄우고 Ready가 되면 기존 파드를 내림 | 중단 없음, 설정 없음 |
| Blue/green | 새 모델을 옆에 완전히 띄워 확인한 뒤 트래픽을 한 번에 넘김 | 확인 후 전환, 즉시 되돌림 |
| Canary | 트래픽 일부(예: 10%)만 새 모델로 보내고 지표를 보며 늘림 | 문제를 작은 범위에서 발견 |
| Shadow(mirroring) | 실제 요청을 복사해 새 모델에도 보내고, 응답은 버림 | 사용자 영향 없이 실제 입력으로 비교 |
| A/B 테스트 | 사용자 그룹을 나눠 모델별 비즈니스 지표를 비교 | 실제 효과 측정 |
실습
GPU 튜닝은 이 과정에서 생략하고, champion 모델은 이 예제에서 학습한 마지막 모델을 사용합니다. 서빙 엔진은 Kubeflow를 설치하면 기본으로 제공하는 KServe를 사용하고, Rolling update 배포 전략을 사용합니다.
KServe로 모델을 서빙하려면 KServe API의 InferenceService YAML을 배포하면 됩니다. InferenceService는 쿠버네티스 리소스를 배포하는 controller역할이라면, 서빙에 관련된 설정은 SevingRuntime에 설정합니다. mlflow는 mlflow models serve라는 명령어를 사용해서 mlflow 모델을 서빙할 수 있습니다.
apiVersion: serving.kserve.io/v1beta1
kind: InferenceService
metadata:
  name: income-classifier
  namespace: kubeflow-user-example-com
  labels:
    app.kubernetes.io/part-of: mlops-part2
  annotations:
    sidecar.istio.io/inject: "false"
spec:
  predictor:
    serviceAccountName: kserve-s3
    model:
      modelFormat:
        name: mlflow
        version: "3"
      runtime: mlflow-serve
      storageUri: s3://mlflow-artifacts/1/models/m-bf03a37fb3b34de292dd57fb330c1a45/artifacts
---
apiVersion: serving.kserve.io/v1alpha1
kind: ServingRuntime
metadata:
  name: mlflow-serve
  namespace: kubeflow-user-example-com
  labels:
    app.kubernetes.io/part-of: mlops-part2
spec:
  supportedModelFormats:
  - name: mlflow
    version: "3"
  containers:
  - name: kserve-container
    image: python:3.12.13-slim
    command: ["sh", "-c"]
    args:
    - pip install --no-cache-dir -r /mnt/models/requirements.txt && exec mlflow models serve -m /mnt/models -h 0.0.0.0 -p 8080 --env-manager local
    ports:
    - containerPort: 8080
      protocol: TCP
    resources:
      requests:
        cpu: 500m
        memory: 1Gi
      limits:
        cpu: "1"
        memory: 2Gi
InferenceService를 배포하면 KServe 컨트롤러가 Deployment로 serving pod를 만들고, pod를 호출할 수 있는 Service를 생성합니다. KServe 설정에 따라 InferenceService를 생성할 때 Gateway API의 HTTPRoute를 만들어 Istio gateway에 연동할 수도 있습니다. 이 예제에서는 gateway를 사용하지 않았고 port-forward로 호출했습니다.
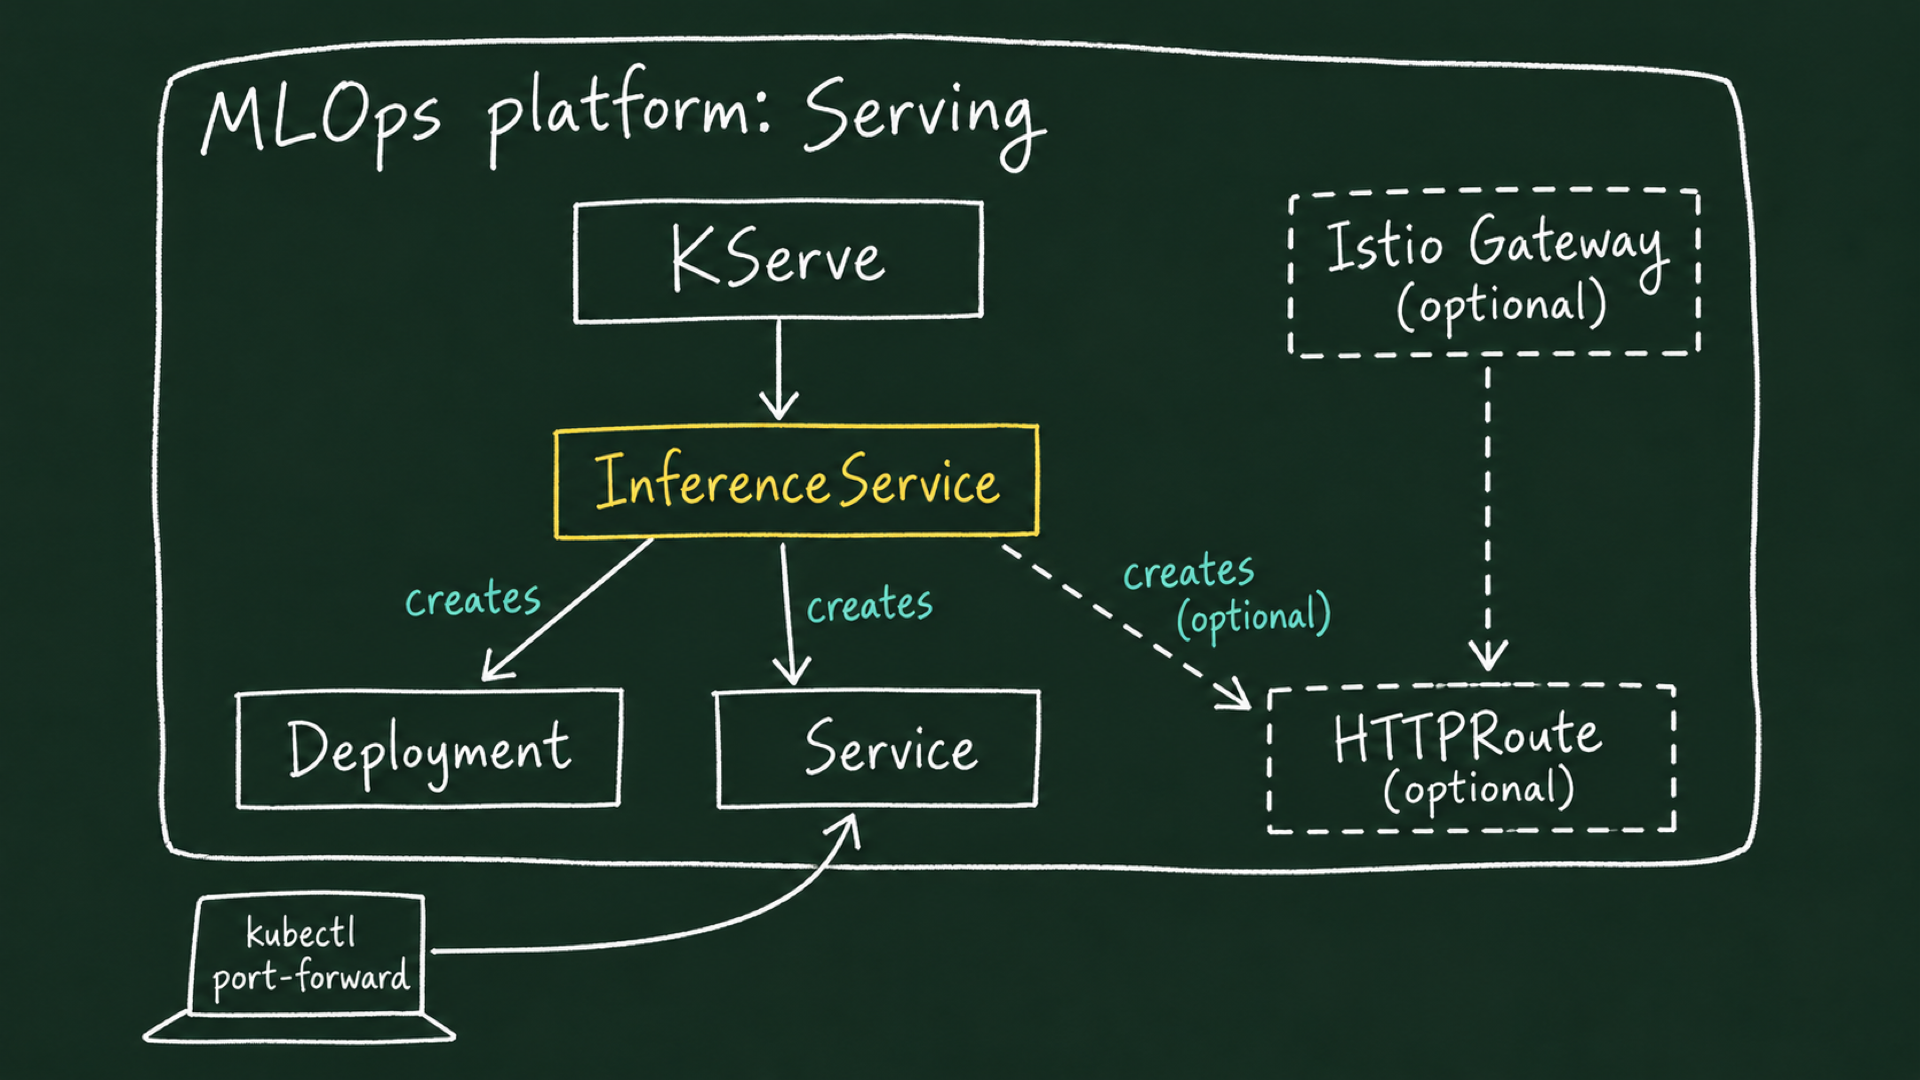
InferenceService는 kubectl get isvc로 조회할 수 있습니다. READY가 True여야 정상 동작합니다.
kubectl -n kubeflow-user-example-com get isvc income-classifier -o wide
아래 예시는 KServe가 InferenceService로 생성한 Deployment와 Service입니다.
kubectl -n kubeflow-user-example-com get svc,deploy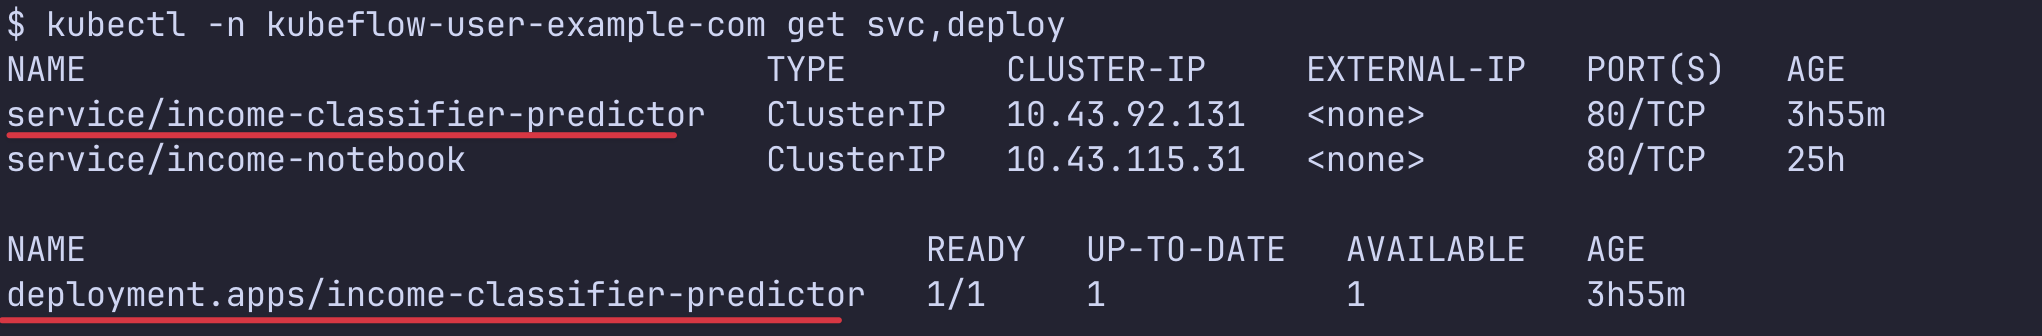
ML 플랫폼 기능7 - feature store
이론
모델 개발은 알고리즘도 중요하지만 데이터셋도 매우 중요합니다. feature store는 학습과 서빙에 쓰는 feature를 한 번 정의해 저장하고, 학습과 서빙이 같은 feature를 꺼내 쓰게 하는 저장소입니다. EDA에서 데이터셋을 탐색하여 학습에 사용할 데이터를 선별해서 feature로 만들고, 이 feature를 feature store에 저장합니다. 학습할 때는 feature store에 있는 feature를 그대로 사용하여 학습합니다. 그리고 실험을 기록할 때 어떤 feature를 사용했는지 기록하여 추적합니다.

feature store는 같은 feature를 오프라인 스토어와 온라인 스토어에 저장합니다. 오프라인 스토어는 과거 값을 모두 쌓아 학습 데이터셋을 만들 때 쓰고, 온라인 스토어는 key마다 최신 값만 두고 서빙할 때 예측 요청에 없는 feature를 빠르게 돌려줍니다(예: 카드번호로 최근 1시간 결제 횟수 조회).
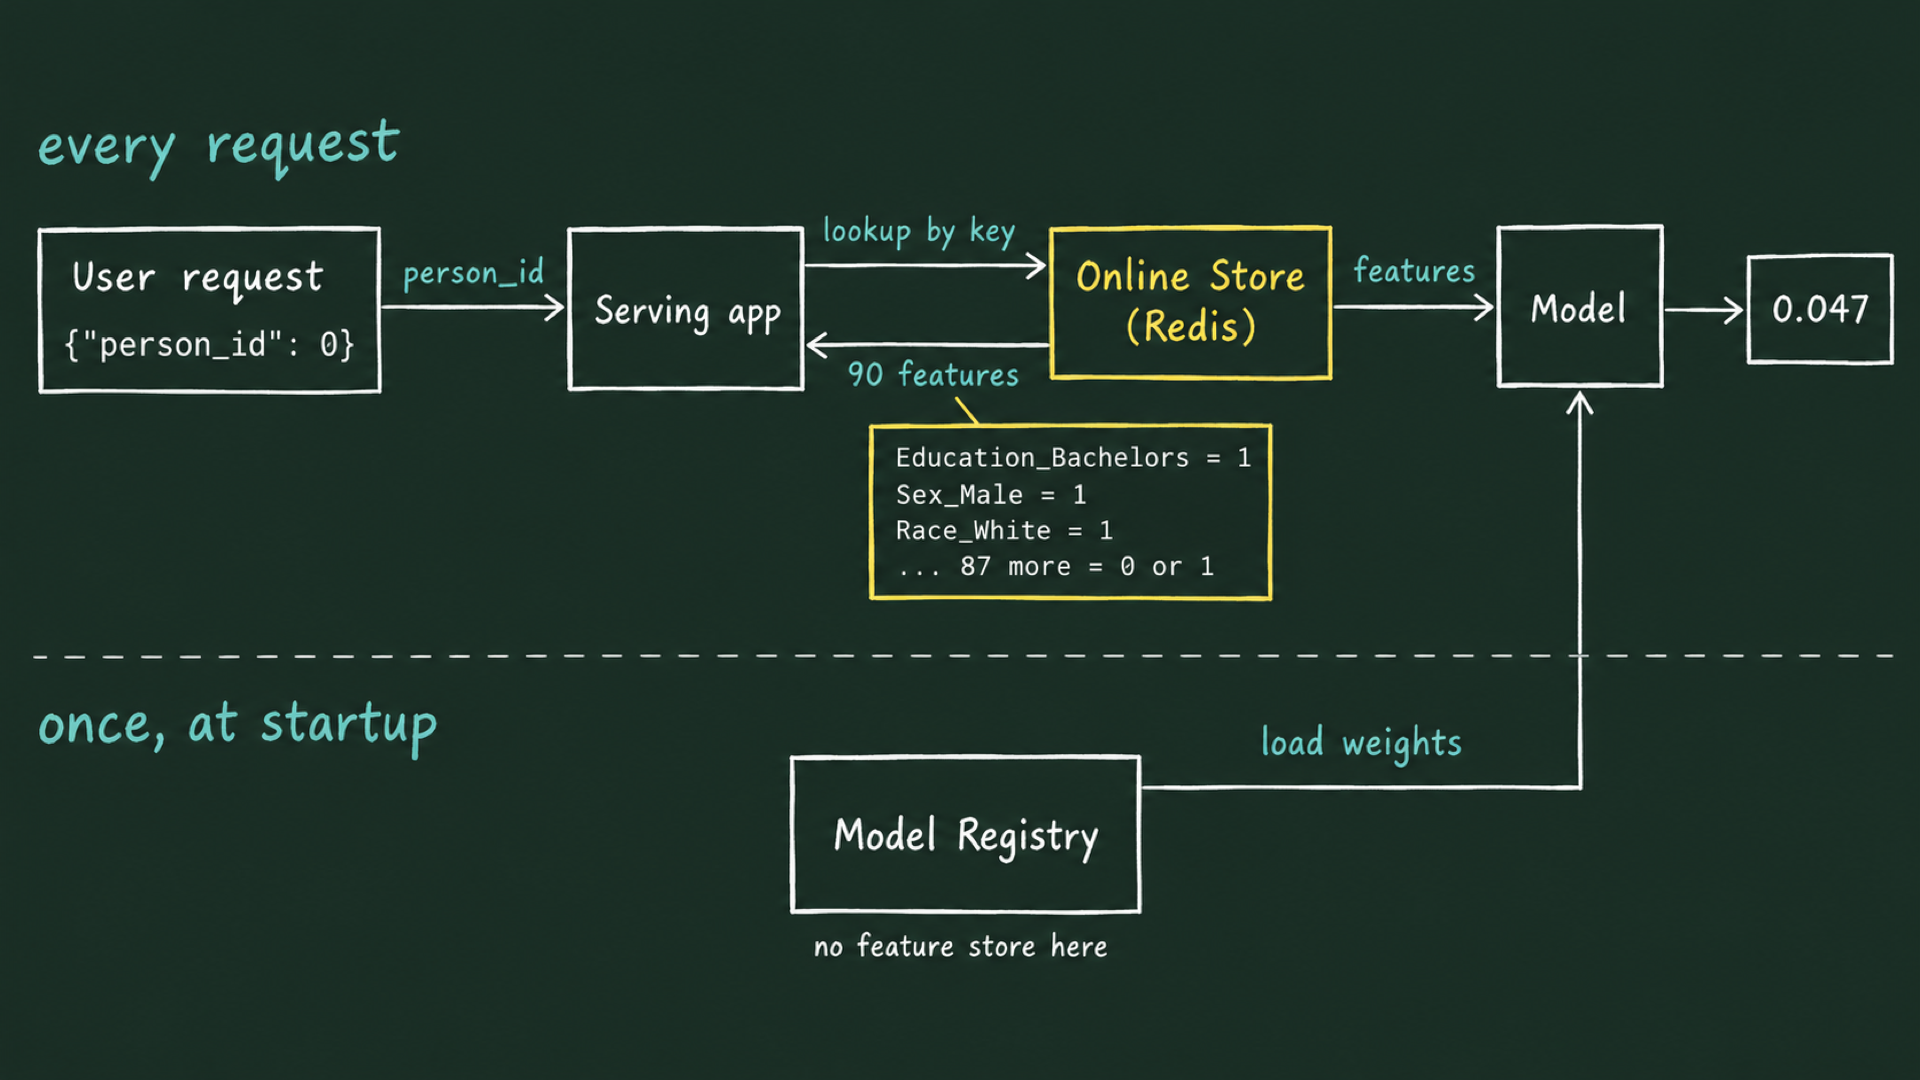
온라인 스토어는 저절로 채워지지 않아서, 스케줄러가 주기적으로 materialize를 실행해 오프라인 스토어의 최신 값을 옮겨야 합니다.

실습
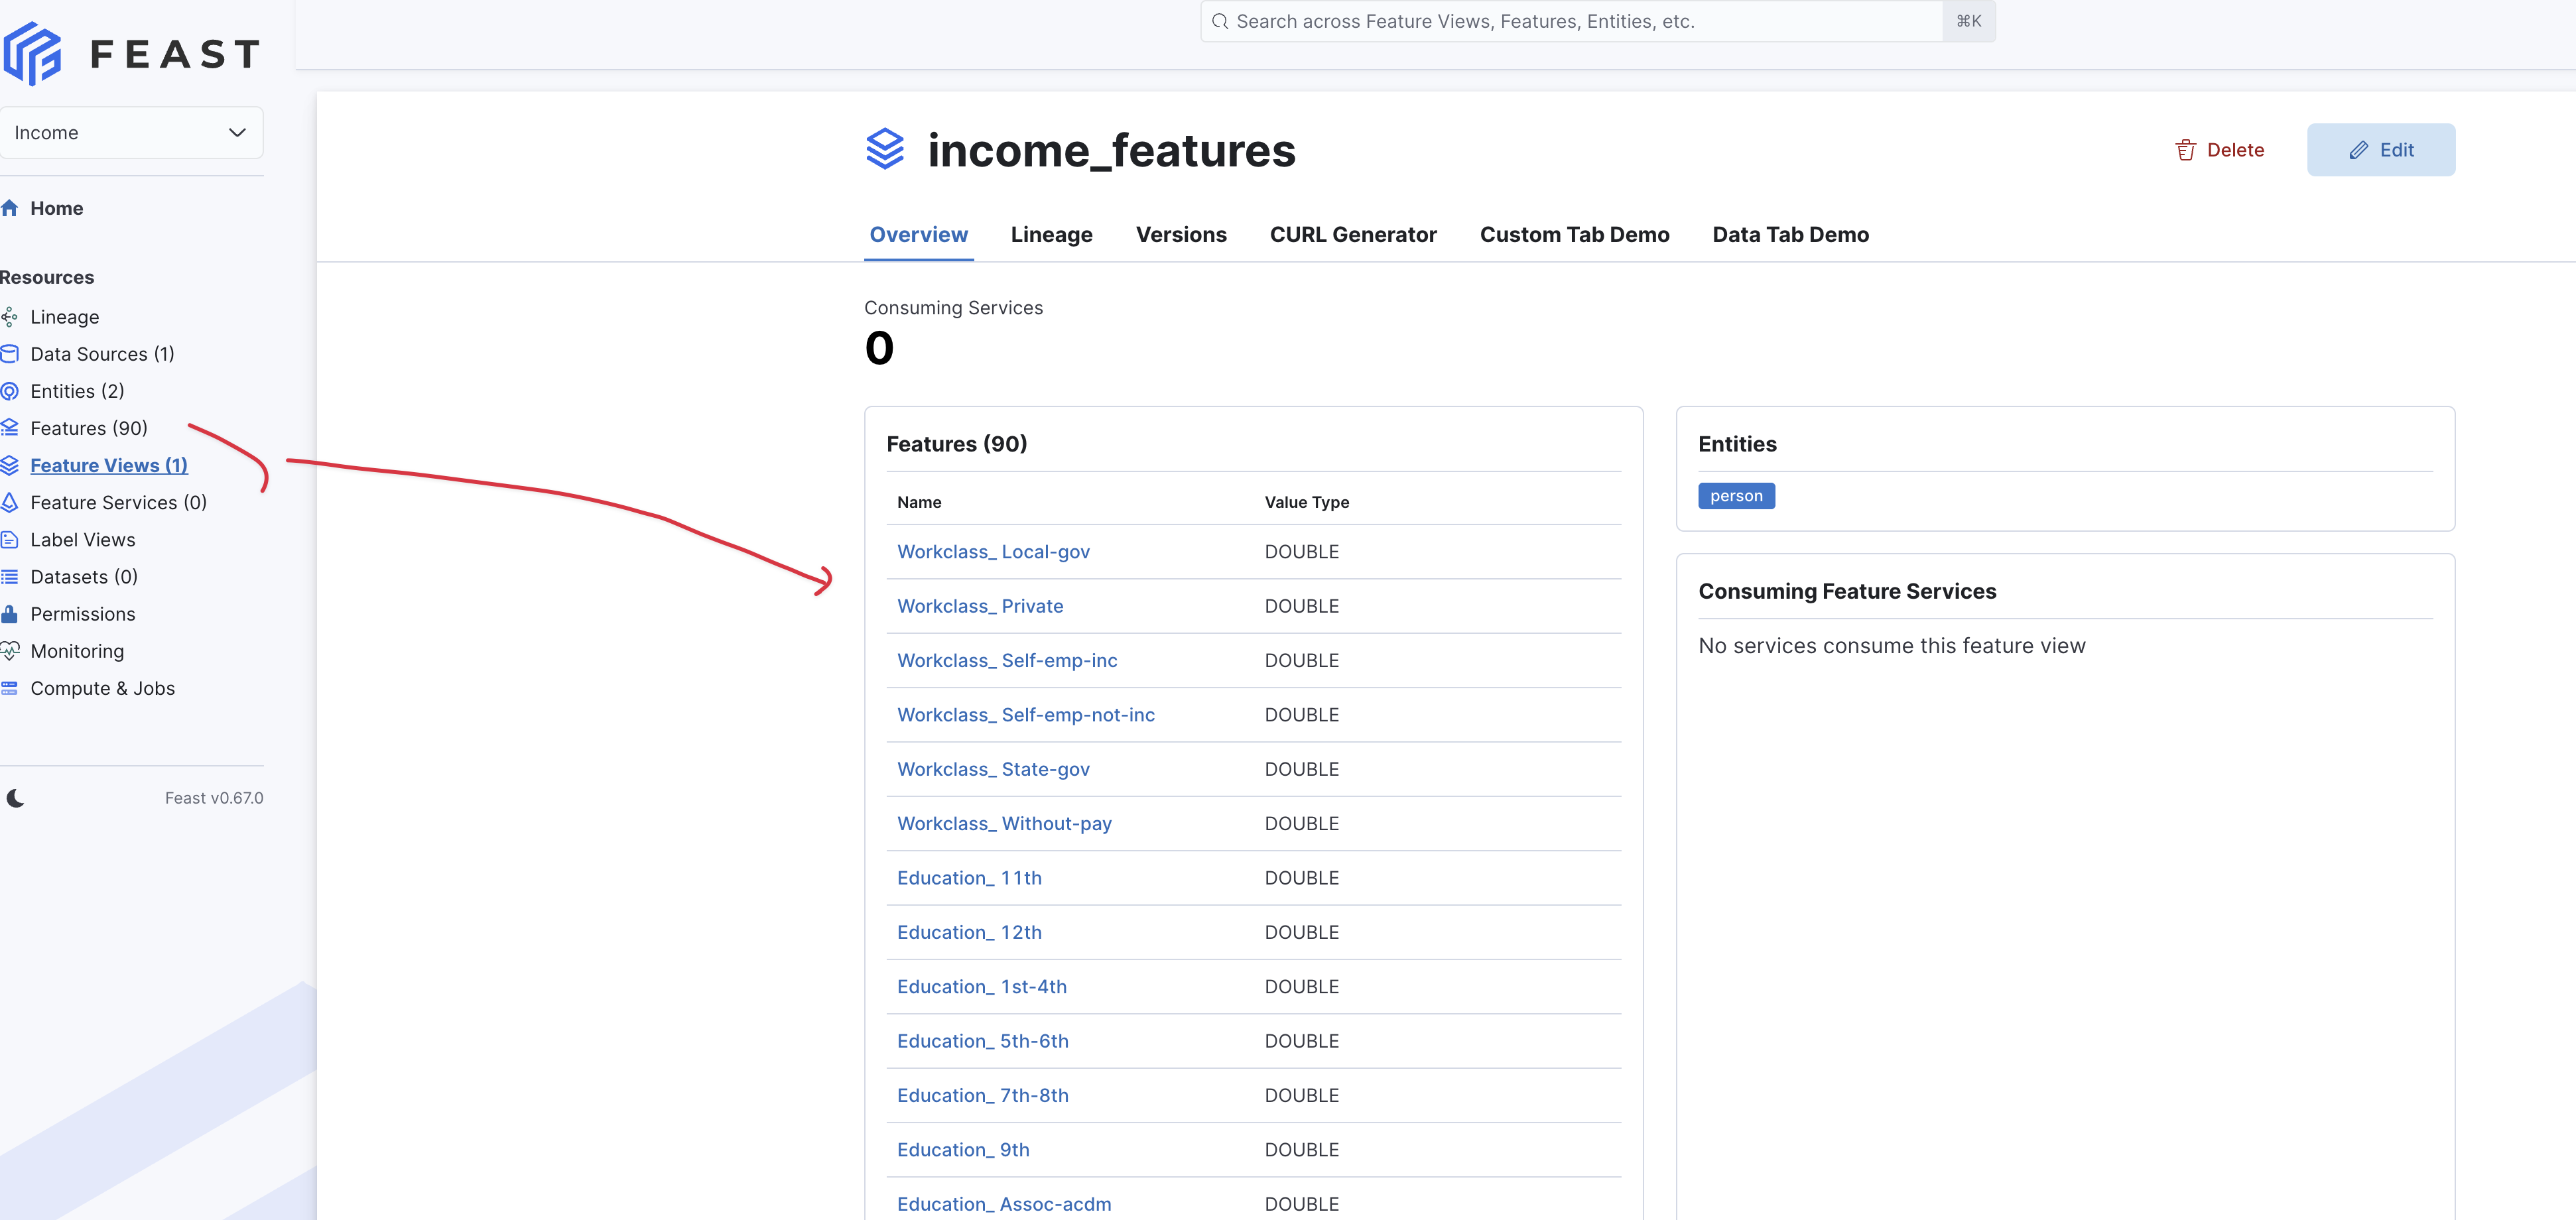
알려진 feature store 오픈소스로는 Feast가 있습니다. 아래 그림은 Feast에 저장된 feature를 보여줍니다.
참고자료
'전공영역 공부 기록' 카테고리의 다른 글
| PHP2Shell 취약점 간단 정리 - CVE-2026-109618, CVE-2026-109619 (0) | 2026.10.25 |
|---|---|
| CloudNet MLOps 스터디 1주차 (2) | 2026.10.25 |
| production LLM에 인터넷 검색을 붙일 때 유료 search provider를 써야 하는 이유 (0) | 2026.10.18 |
| ECS 배포 파이프라인에서 고민한 것 (0) | 2026.10.05 |
| AI Gateway 토큰 집계가 Model provider과 다른 이유 (0) | 2026.09.20 |